Ollama v0.40.13 更新:LFM3 音频模型登陆 Linux 与 Windows
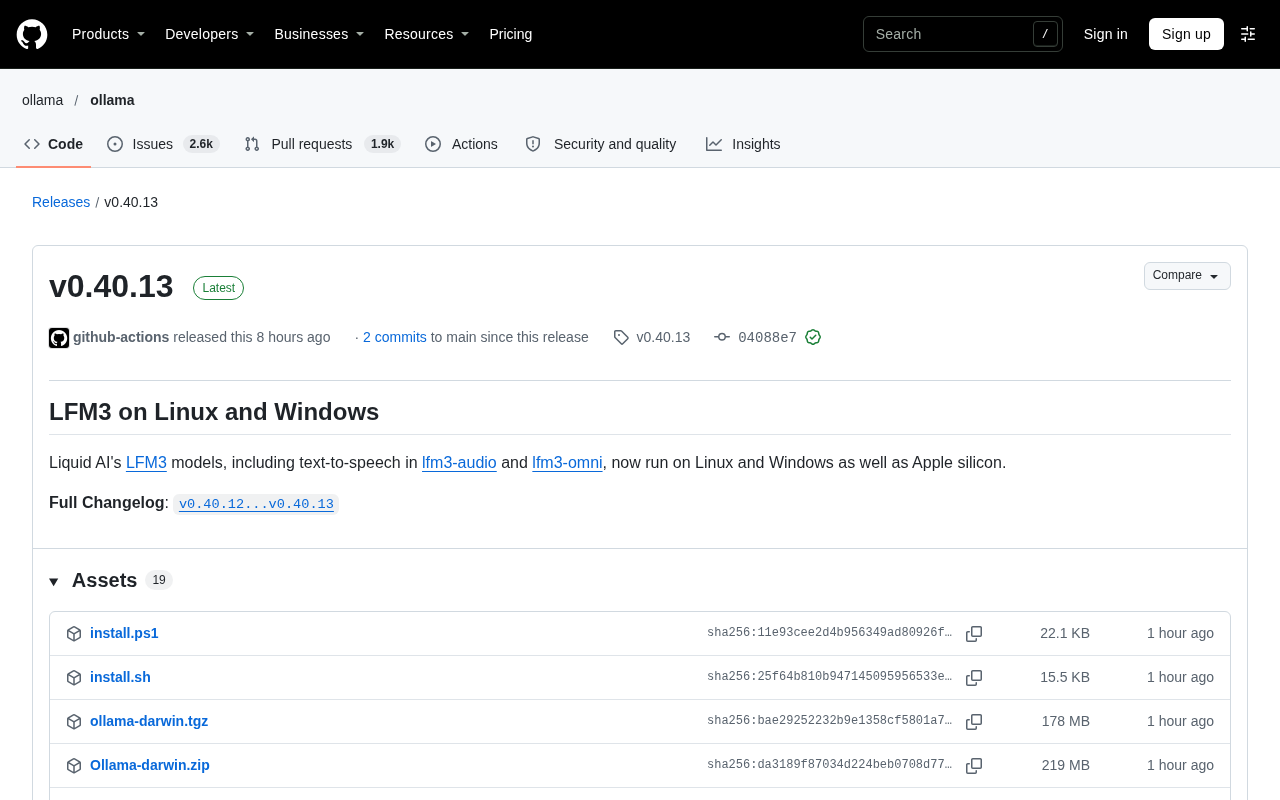
Ollama v0.40.13 将 LFM3 音频模型支持从 Apple silicon 扩展到 Linux 和 Windows。
Ollama 发布 v0.40.13 小版本更新,核心变化是将 Liquid AI 的 LFM3 系列模型支持范围从 Apple silicon 扩展到 Linux 和 Windows。LFM3 并非纯文本模型,其 lfm3-audio 和 lfm3-omni 变体具备文本转语音等音频能力,而此类模型在本地部署场景中一直较为稀缺,通常需要额外的推理框架和服务进程。纳入 Ollama 统一管理后,用户可以用拉取文本模型的相同方式获取带音频能力的模型,显著降低尝试门槛。此次更新仅包含 1 个 commit,属平台适配层面的迭代,未涉及底层架构调整。版本说明未提供具体性能数据或硬件要求,实际表现仍取决于设备配置与模型量化版本。
Ollama 发布了 v0.40.13 版本,这次更新的核心信息并不复杂,但对本地大模型玩家来说意义不小:Liquid AI 的 LFM3 系列模型现在不再局限于 Apple silicon,Linux 和 Windows 用户也能直接跑起来了。对于习惯在本地部署模型的开发者,这相当于官方把一个此前偏「苹果专属」的能力补齐到了主流桌面平台。
LFM3 是什么,为什么值得关注
LFM3 是 Liquid AI 推出的模型系列,从命名和功能覆盖来看,它并不是单纯的文本模型。此次版本说明中明确提到,lfm3-audio 和 lfm3-omni 两个变体支持文本转语音(text-to-speech)能力,也就是说 LFM3 具备音频输入输出相关的多模态特性。
这类模型在本地推理场景中一直比较稀缺。大多数开源模型以纯文本为主,涉及语音合成或音频理解的模型往往需要额外的推理框架、独立的服务进程,部署链路较长。Ollama 把 LFM3 纳入统一管理,意味着用户可以用和拉取文本模型相同的方式获取一个带音频能力的模型,降低了尝试门槛。
Liquid AI 与 LFM 系列
Liquid AI 是麻省理工学院(MIT)孵化的 AI 初创公司,其核心研究方向是「液态神经网络」(Liquid Neural Networks)——一种受生物神经系统启发的模型架构,强调在推理过程中动态调整网络状态,以更少的参数实现时序与序列建模能力。LFM(Liquid Foundation Model)是该公司推出的基础模型产品线,定位为轻量、高效、可本地部署的通用模型家族。LFM3 是该系列的第三代版本,相比前代在多模态能力上有明显扩展。理解这层背景有助于判断 LFM3 的产品定位:它并非追求参数规模的开源大模型,而是主打在消费级硬件上以较低资源占用完成文本与音频任务,因此被 Ollama 这类本地推理工具纳入支持具有合理性。
平台支持的扩展意味着什么
此前 LFM3 在 Ollama 上只能运行在 Apple silicon 设备上,这与苹果芯片统一内存架构对模型推理的友好性有关。这次更新把支持范围扩展到 Linux 和 Windows,实际影响可以从两个层面看。
从用户覆盖角度,Linux 是服务器和开发机的主力系统,Windows 则覆盖了大量个人开发者和小型团队。支持这两个平台后,LFM3 的潜在使用群体从 Mac 用户扩展到绝大多数本地部署场景。从生态角度,这也说明 Ollama 对不同硬件后端的适配在持续推进,音频类模型不再是某个平台的实验性功能。
需要注意,版本说明并没有给出具体性能数据或硬件要求,实际运行效果取决于设备配置和模型量化版本。
Apple silicon 统一内存与模型推理
Apple silicon(M 系列芯片)采用统一内存架构(Unified Memory Architecture),CPU 与 GPU 共享同一块物理内存,无需在显存和系统内存之间搬运数据。这一特性对大模型推理尤其友好:模型权重可以直接驻留在共享内存中,GPU 通过高带宽访问,避免了独立显卡常见的显存容量瓶颈。因此不少本地推理框架会优先适配 Apple silicon,Ollama 此前将 LFM3 限制在该平台即与此有关。Linux 和 Windows 平台则通常依赖 NVIDIA CUDA、AMD ROCm 或纯 CPU 推理,硬件组合更复杂,适配工作量和性能表现差异都更大,这也是此次平台扩展值得关注的技术原因。
如何使用与更新
此次发布由 github-actions 自动构建,release 记录显示包含 1 个 commit,完整变更日志指向 v0.40.12...v0.40.13。从版本号跨度看,这是一次小版本迭代,改动集中在模型平台支持上,不涉及底层架构的大幅调整。
对于已经在使用 Ollama 的用户,常规的升级流程即可获取新版本;升级后可以尝试拉取 LFM3 相关模型,观察音频能力在本机上的实际表现。如果是首次接触音频类本地模型,建议先确认磁盘空间和运行内存是否满足模型体积要求。
Ollama 的模型拉取与版本管理机制
Ollama 采用类似容器镜像的分层模型分发方式,用户通过 ollama pull <model> 拉取模型,模型文件按层缓存在本地,更新时只下载变化的层。Ollama 本体与模型是分开版本化的:升级 Ollama 客户端只更新推理运行时和平台适配层,已下载的模型不会自动变化,需要重新 pull 才能获取新版本或新变体。因此文中提到「升级后可以尝试拉取 LFM3 相关模型」,实际操作是先用包管理器或安装脚本升级 Ollama,再显式拉取 lfm3-audio、lfm3-omni 等具体模型标签。此外,Ollama 的模型量化版本会直接影响内存占用与推理速度,资源有限的设备应优先选择参数量更小或量化程度更高的标签。
小结
Ollama v0.40.13 是一次目标明确的更新:把 Liquid AI 的 LFM3 音频模型从 Apple silicon 扩展到 Linux 和 Windows。它没有花哨的功能堆砌,但对想在本地体验语音合成能力的开发者来说,是实打实的可用性提升。后续值得关注的是 LFM3 在不同硬件上的推理质量和延迟表现,这决定了它能否真正进入日常开发工作流。
相关推荐
Ollama本地部署指南:零基础跑通开源大模型
Ollama本地部署教程:介绍Ollama是什么、为什么选择它,以及如何下载安装、运行开源大模型,并利用API进行个性化开发,适合零基础用户。
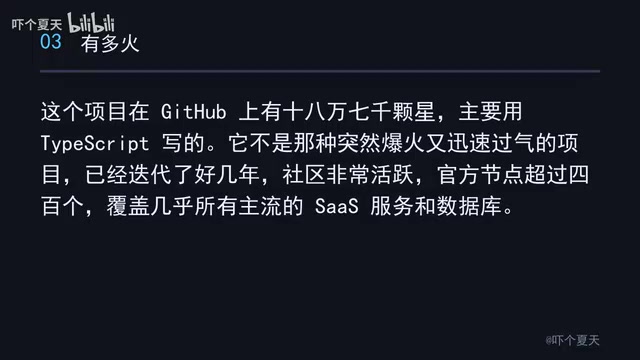
n8n:GitHub 187K星的开源自动化神器,把重复工作变工作流
n8n 是一款 GitHub 187K 星的开源可视化工作流自动化引擎,支持 400+ 节点、Webhook/定时/轮询触发,可自托管保障数据安全,还能接入 AI Agent 打造 AI 工作流。本文介绍其核心概念、典型场景与避坑指南。
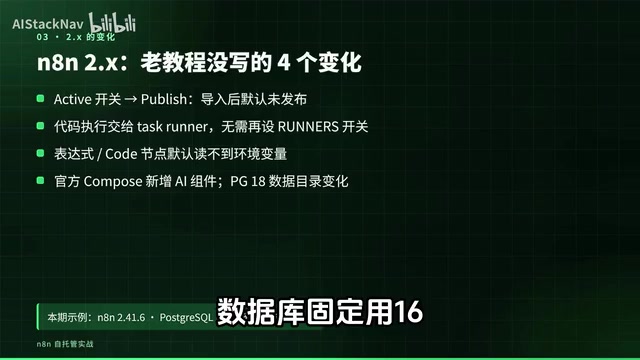
n8n自托管实战:Docker+PostgreSQL+Caddy部署指南
手把手教你用 Docker Compose 部署 n8n 自托管实例,搭配 PostgreSQL 和 Caddy 自动 HTTPS,含环境变量避坑、网站巡检飞书告警流程、备份升级回滚要点。