Ollama v0.40.5 预发布:MLX Metal 内核移植 CUDA,OpenAI 兼容性升级

Ollama v0.40.5 预发布版移植 MLX Metal 内核至 CUDA,并修复 OpenAI 兼容层。
Ollama v0.40.5 预发布版上线,虽仍为 RC 阶段,但带来了几项底层变更。最具技术含量的是将 MLX 框架为 Apple Metal 编写的自定义内核移植到 CUDA,使相同计算逻辑可运行于 NVIDIA GPU,为跨平台推理性能优化打开空间。兼容性方面,OpenAI 兼容接口修复了在 Responses 历史中接受自定义工具调用的问题,改善了 Agent 类第三方应用的集成体验。此外还有模型推荐文档语言标准化、云端支付错误提示优化等工程维护,新贡献者 @willietran 首次参与。整体看,该版本并非面向普通用户的功能大版本,而是以底层优化和兼容性修补为主,CUDA 内核的后续集成进展值得关注。
Ollama 最新预发布版本 v0.40.5 已上线,虽然仍处于候选发布(RC)阶段,但带来的几项变更值得本地大模型玩家关注。从 CUDA 内核移植到 OpenAI Responses API 的兼容性修复,这个版本透露出 Ollama 在跨平台推理与生态集成上的持续投入。
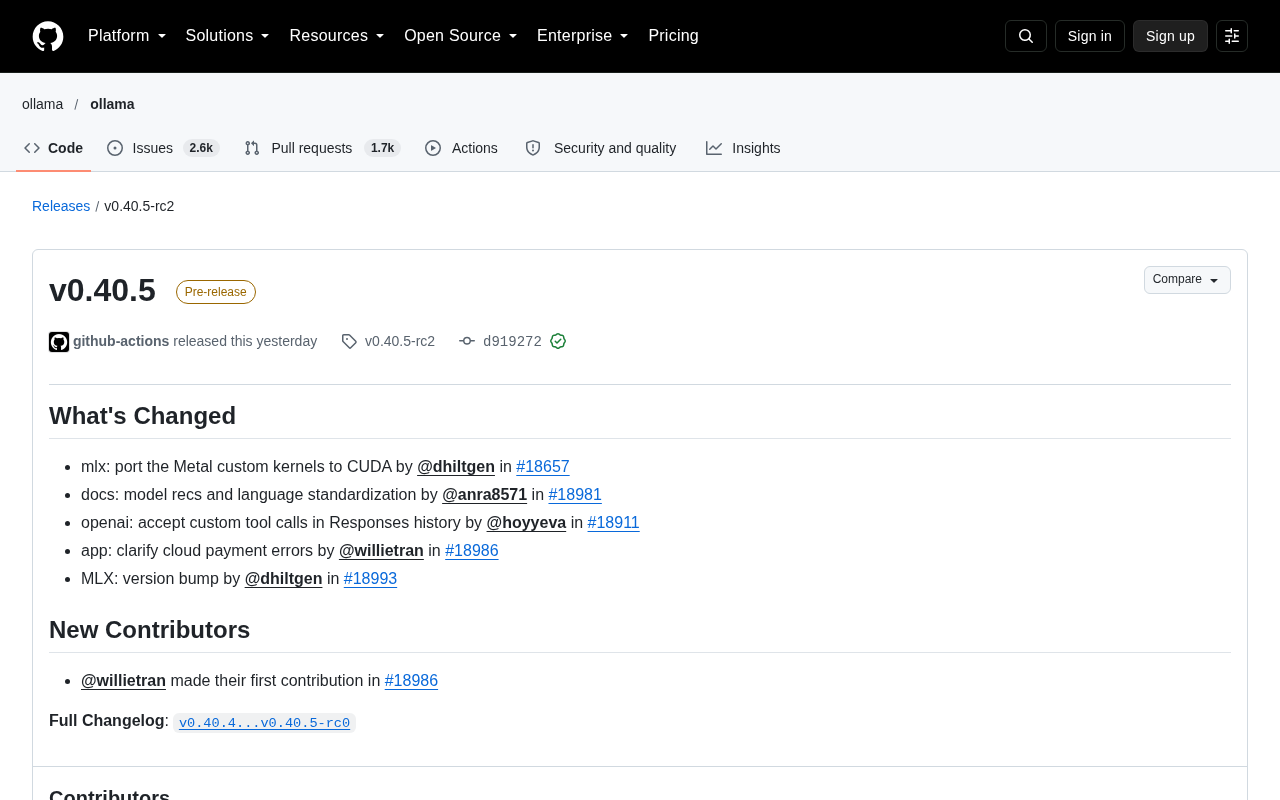
MLX 的 Metal 自定义内核被移植到 CUDA
本次更新中最具技术含量的改动,是开发者 @dhiltgen 提交的 PR #18657:将 MLX 框架中原本为 Apple Metal 编写的自定义内核移植到 CUDA 平台。
MLX 是苹果推出的机器学习框架,专为 Apple Silicon 的统一内存架构优化,其 Metal 内核充分利用了 M 系列芯片的 GPU 特性。把这套内核移植到 CUDA,意味着相同的计算逻辑现在可以在 NVIDIA GPU 上运行,为 Ollama 在非苹果硬件上的推理性能打开了新的优化空间。
这并非简单的 API 翻译。Metal 和 CUDA 在内存管理、线程调度和指令集层面差异显著,内核级别的移植需要对底层计算模式做重新适配。@dhiltgen 同时提交了 MLX 版本号提升的 PR #18993,表明团队正在同步维护两条技术路线。
对于使用 NVIDIA 显卡运行 Ollama 的用户来说,这一改动的实际收益取决于后续版本是否将这些内核投入默认推理路径。但从方向上看,Ollama 正在缩小不同硬件平台之间的性能差距。
关于“自定义内核”的一点背景:在深度学习推理中,“内核”(kernel)指的是在 GPU 上执行的一段并行计算程序,通常负责矩阵乘法、注意力计算、归一化等算子。深度学习框架提供的通用内核往往为了兼容性牺牲了性能,而“自定义内核”是针对特定硬件微架构手写的优化版本,能够充分调用该硬件的向量化指令、共享内存和线程束调度能力,从而在相同算力下获得更高吞吐。MLX 为 Apple Metal 编写的自定义内核,正是针对 M 系列芯片的统一内存与 GPU 特性做了手工调优。移植到 CUDA 后,这些算子需要在 NVIDIA 的 SM 架构、显存层级和 warp 调度模型上重新实现,属于典型的“跨后端内核重写”,其价值在于把苹果生态中已经验证的高效算法引入 NVIDIA 推理路径。
OpenAI 兼容层:Responses 历史中接受自定义工具调用
PR #18911 修复了一个生态集成中的细节问题:OpenAI 兼容接口现在可以在 Responses 历史记录中接受自定义工具调用(custom tool calls)。
Ollama 一直将自己定位为本地模型的 OpenAI API 替代方案,大量第三方工具和应用通过 OpenAI 格式的接口与 Ollama 通信。当这些应用使用自定义工具(而非 OpenAI 预定义的工具类型)时,之前的兼容层可能在处理历史消息时出现解析问题。这次修复让工具调用在多轮对话中的传递更加顺畅。
对于构建 Agent 或复杂工具链的开发者,这个改动减少了因接口不兼容而导致的调试成本。
关于 OpenAI Responses API 与工具调用:OpenAI 的 Responses API 是面向智能体(Agent)场景的对话接口,与传统的 Chat Completions 接口不同,它把模型输出建模为一系列“条目”(items),包括消息、函数调用、函数返回等,从而天然支持多轮、多步骤的工具调用循环。工具调用分为两类:一类是 OpenAI 内置的预定义工具(如文件检索、代码解释器),另一类是开发者自定义的函数工具(custom tool calls),由模型生成结构化参数、客户端执行并回传结果。兼容层要正确复现这套机制,就必须在历史记录里完整保存并解析自定义工具调用的输入输出结构,否则多轮 Agent 流程会在第二轮之后断裂。Ollama 修复这一点,本质上是让本地模型能够更可靠地充当 OpenAI Agent 框架的后端。
文档、支付错误提示与版本维护
其余几项改动偏向工程维护。PR #18981 对模型推荐文档做了语言标准化处理;PR #18986 改善了云端支付错误的提示信息,由新贡献者 @willietran 提交——这也是他首次参与 Ollama 项目。
整体来看,v0.40.5 不是一个面向普通用户的功能性大版本,而是一轮以底层优化和兼容性修补为主的迭代。对于关注本地推理性能的开发者,CUDA 内核移植的后续进展值得持续跟踪。
关于 RC(候选发布)与预发布版本:Ollama v0.40.5 属于 Release Candidate(RC)阶段的预发布版本,这类版本已经完成主要功能开发,进入“冻结功能、集中修 bug”的验证期。其版本号通常与正式版一致,但会附带 rc 或 pre-release 标记。RC 的目的是让社区提前验证,发现回归问题后仍可在正式版发布前修复,因此稳定性通常高于 nightly 构建,但低于正式版。对生产环境而言,RC 版可能出现接口行为微调或依赖冲突;对希望尝鲜新内核、新兼容性修复的开发者,则可以用它提前评估后续正式版的方向。Ollama 将 CUDA 内核移植这类底层改动放在 RC 中,也符合其“先验证、再默认”的迭代节奏。
常见问题
这个版本可以日常使用吗?
当前标记为 Pre-release(预发布),建议等待正式版发布后再用于生产环境。
CUDA 内核移植会立即提升推理速度吗?
不一定。内核移植是基础工作,实际性能提升取决于这些内核何时被集成到默认推理流程中。
OpenAI 兼容性修复影响哪些场景?
主要影响使用自定义工具调用的第三方应用,尤其是需要多轮工具调用的 Agent 类工具。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。