Ollama v0.40.7-rc0 加入 PPLX Decider v1.2 支持
Ollama 为 MLX 后端新增基于 Qwen3.5 的 PPLX Decider 路由打分器,显露推理调度层野心。
Ollama 推送 v0.40.7-rc0 预发布标签,为 MLX 后端新增 PPLX Decider v1.2 支持。该 Decider 并非独立小模型,而是基于 Qwen3.5 的决策打分器,采用非因果注意力与 publisher readout,并包含图像处理与 System One 提示编码,属于评估与路由组件而非生成模型。选择 MLX 作为首个落地后端,契合端侧路由对极低延迟的需求,也反映 Ollama 从模型加载器向本地推理运行时的定位延伸。由于信息仅来自单一 commit,缺乏文档佐证,其是否扩展到 CUDA、ROCm 等后端仍需观察。
一次看似平常的 MLX 更新,藏着推理调度层的野心
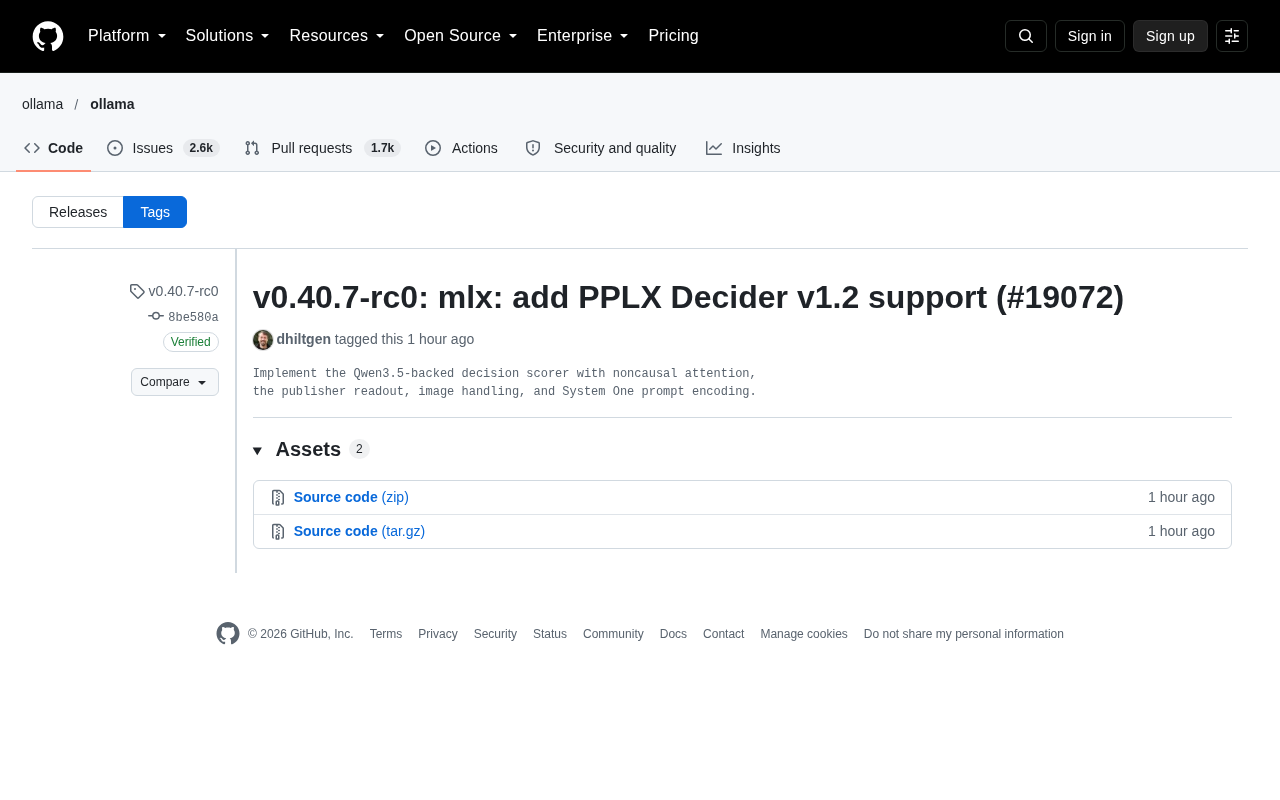
Ollama 在 GitHub 上推送了 v0.40.7-rc0 预发布标签,提交号为 8be580a,由维护者 dhiltgen 打上标签。从标题看,这是一次针对 MLX(Apple Silicon 上的机器学习框架)后端的增量更新:为 PPLX Decider v1.2 增加支持。
单看这行 commit message,很容易被当作普通的依赖升级略过。但提交正文里透露的实现细节,说明事情没那么简单。
PPLX Decider 到底是什么
提交说明写道:
Implement the Qwen3.5-backed decision scorer with noncausal attention, the publisher readout, image handling, and System One prompt encoding.
拆开来看,这里有几个关键信息:
决策打分器由 Qwen3.5 驱动。 PPLX Decider 并非一个独立的小模型,而是一个基于 Qwen3.5 的 decision scorer。所谓“decider”,在推理系统语境里通常指决定“下一步走哪条路径”的调度组件——比如是否触发工具调用、选择哪条推理分支、如何分配计算预算。
非因果注意力(noncausal attention)。 这是一个强信号。常规自回归生成使用因果注意力,每个 token 只能看到自己之前的上下文;非因果注意力则允许 token 双向可见。这通常出现在用于判别、打分或分类的模型头部,而非纯生成任务。换言之,这个 Decider 更像是一个“评估器”而非“生成器”。
publisher readout。 可以理解为对模型输出的读出层(readout head),负责把隐藏状态映射为决策分数。
图像处理与 System One 提示编码。 说明这个决策器能够接收图像输入,并采用了一种名为“System One”的提示编码方案。System One 这个命名让人联想到双系统理论中快速、直觉式的决策路径——用于低延迟的路由判断相当贴切。
非因果注意力与双向编码:非因果注意力(noncausal / bidirectional attention)取消了因果掩码,使序列中每个位置都能关注全部上下文。BERT 类编码器即采用此结构,擅长产出全局语义表示,适合分类、排序与打分任务。将其用于 Decider,意味着该模块对完整输入(含图像 token 与提示文本)做一次双向编码,再经 readout 头输出决策分数,属于典型的判别式(discriminative)用法,而非逐 token 自回归生成。这与“决定走哪条路径”的调度需求高度吻合——决策只需一次前向,无需解码循环,延迟更低。
System One 提示编码:双系统理论中 System 1 指快速、自动化、低认知负荷的判断,System 2 则是慢速、审慎的推理。以 System One 命名提示编码方案,暗示该编码面向短路径、低延迟的路由判断,可能采用压缩后的提示模板或轻量 tokenizer,以便在端侧毫秒级完成编码。
为什么选择 MLX 作为首个落地后端
这次更新挂在 mlx 命名空间下,意味着该能力首先在 Apple Silicon 平台落地。MLX 是苹果为统一内存架构设计的框架,在 M 系列芯片上跑中小型模型有明显优势。
把决策打分器优先部署在端侧,逻辑上说得通:路由决策需要极低延迟,放在本地比往返云端更合理。而 Qwen3.5 作为基座,说明选型偏向轻量、可本地部署的模型。
结合 Ollama 近期的定位演进——从“本地跑模型的简单工具”向“本地推理运行时”扩展——引入调度决策层是顺理成章的一步。模型跑起来只是基础,决定何时调用哪个模型、走哪条推理路径,才是运行时层面的核心竞争力。
MLX 的统一内存与延迟优势:MLX 采用统一内存(unified memory)模型,CPU 与 GPU 共享同一块物理内存,无需像 CUDA 那样在主机与设备间显式拷贝张量。对于需要频繁在小批量输入上做前向计算的决策打分器而言,这种零拷贝特性可显著压低单次推理的端到端延迟。此外 MLX 采用惰性求值(lazy evaluation)图,算子融合在编译期完成,适合 Router 这类计算图固定、batch size 极小的负载。
PPLX 的含义:PPLX 通常是 Perplexity 相关的缩写,在推理框架语境中多指代与 perplexity 打分或路由选择相关的组件。将其命名为 Decider,暗示该模块通过某种打分机制在多个候选路径间做选择,而非硬编码规则。
预发布版本意味着什么
rc0 后缀表明这是发布候选版本的第一个迭代。dhiltgen 在 10 月 17 日打上标签,提交本身带有 GitHub 验证签名(GPG key ID: B5690EEEBB952194),可确认来源可信。
对普通用户而言,这个版本短期内不会有可见变化,PPLX Decider 大概率仍处于内部启用或实验阶段。但对关注本地推理架构的开发者来说,这个 commit 值得记一笔:它暗示 Ollama 正在构建一层模型之外的智能调度能力,而不仅仅是模型加载器。
后续值得观察的点包括:PPLX Decider 是否会在非 MLX 后端(CUDA、ROCm)跟进;System One 提示编码是否会形成独立的规范;以及“decider”这个抽象是否会扩展为可插拔的路由策略体系。目前公开信息仅来自单一 commit,尚无文档或设计说明佐证,上述判断需要谨慎看待。
相关推荐
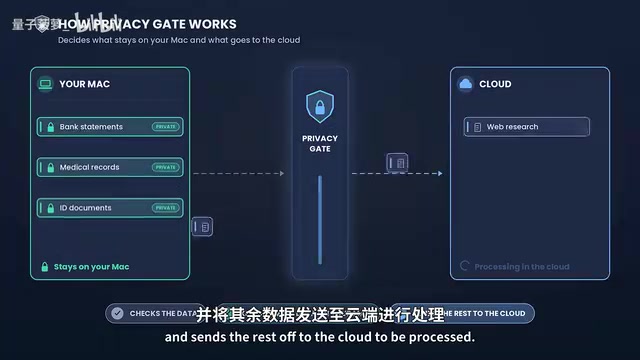
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
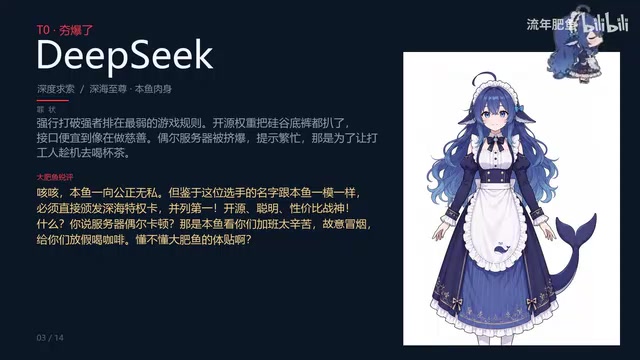
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。