Ollama核心架构拆解:三层协作与自定义模型实战

Ollama三层架构拆解:命令行收命令、本机服务管调度、llama.cpp做推理,GGUF量化与Modelfile让本地大模型开箱即用。
本文以Ollama 0.34.2为锚点,系统拆解其三层架构:命令行层收命令、本机服务层(端口11434)负责模型下载、加载与调度、llama.cpp引擎层执行实际推理。模型以GGUF单文件格式存储,支持内存映射加载并自包含网络结构与权重,配合Q4/Q8等量化方案将数十GB的原始权重压缩到普通硬件可承载的体量。自定义模型无需训练,用Modelfile五条指令写一份"配方"再执行create即可秒级生成,本质是一份指向基座的配置覆盖。接口侧采用双轨设计:原生REST提供全功能,/v1前缀的OpenAI兼容层让现有客户端代码几乎零改造即可本地化部署。硬件加速支持CUDA、ROCm、Metal和Vulkan四条路线,服务启动时自动探测并动态加载对应后端。
一条Run命令背后站着谁
上手Ollama只需几条命令——pull拉模型、run开始对话、list/ps/rm做管理,五分钟就能跑起来。但命令背后的协作机制,才是真正理解这个工具的关键。
把一条run命令拆开看,背后站着三层角色:命令行层只负责收命令,真正的管家是运行在本机的服务(默认端口11434),它负责下载、加载和接口;真正算出每个字的是引擎层的 llama.cpp,它跑在你的 CPU 或显卡上。三层各司其职,这就是 Ollama 的整体架构。
如果用一句话概括:管家层管模型,引擎层管推理,接口层管说话。 下面逐层拆开。
从源码目录认识分层架构
Ollama 以 Go 为主语言,编译后就是一个可执行文件。顶层目录按职责切分:命令入口、服务调度、硬件发现、模型创建、引擎对接,各有各的地盘。源码仓库有 4000 多个提交,250 多个发布版本,本文锚定的是 0.34.2 版本。
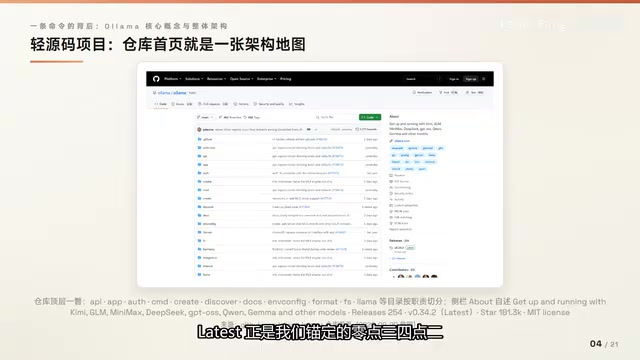
对照目录结构看,三层架构在源码里都有明确映射:命令行层收命令、服务层管模型与调度、引擎层做推理。先混个脸熟,深入源码时就能按图索骥。
模型存在哪里,GGUF又是什么
模型文件的默认存放路径因系统而异:Mac 在用户主目录下,Windows 在用户目录下,Linux 走系统标准目录。想换位置,改一个环境变量即可。
目录里分两块:清单文件记录每个模型名由哪些层组成,实际数据则按内容摘要存成分片——这和容器镜像的分层思路是同一个味道。
模型为什么拉完就能跑?答案是 GGUF 格式,这是 GGML 官方规范定义的单文件格式。它的特点是单文件分发、支持内存映射加载、信息自包含——网络结构、分词器、权重全在一个文件里。加载一个模型所需的全部信息都在文件内。
GGUF 是 2023 年由 llama.cpp 项目引入的格式,全称 GGML Unified Format,是对早期 GGML/GGMF/GGJT 等格式的统一替代。它采用键值对头部(header)存储超参数和词表,张量数据紧随其后连续排列,整个文件可以通过 mmap(内存映射)直接映射到进程地址空间,操作系统按需换页,无需一次性将所有权重读入 RAM。这一设计让"部分权重在 CPU 内存、部分在 GPU 显存"的混合推理成为可能——llama.cpp 的 -ngl(n_gpu_layers)参数正是利用了这个特性,按层粒度决定哪些权重卸到显卡。GGUF 的自包含性也意味着分发时无需附带外部配置文件,一个文件即一个完整可运行模型,这正是 Ollama 能用分片哈希做内容寻址存储的基础。
量化:55GB模型如何塞进8GB显存
几十 GB 的原始权重,普通电脑根本装不下,靠的是量化压缩。模型库的 Tag 名把规格全写明了,一般分三段:规格、微调标记、量化名。
- Q4 档:最常见的甜点选择,12B 模型可压到约 8.1GB
- Q8 档:更贴近原始精度,训练时就做量化感知,质量更稳
- FP16:不量化,是上限档
选型第一步就是读懂 Tag 名。
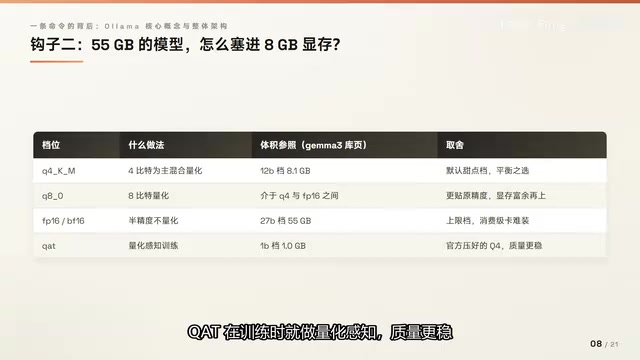
量化的核心思路是用低位整数近似表示原本的 32 位或 16 位浮点权重。以 Q4 为例,每个权重用 4 bit 存储,相比 FP16 的 16 bit,体积缩减约 75%。但简单截断会带来明显精度损失,因此实际方案通常是分块量化(block-wise quantization):每 32 个或 256 个权重共享一组缩放因子,以此控制误差累积。GGUF 文件名中常见的 Q4_K_M 等后缀,K 代表使用了 k-quants 方案(对注意力层和前馈层的关键矩阵保留更高精度),M 表示 Medium 配置,是精度与压缩比之间的折中选择。量化不是无损的,语言理解和长文推理任务在极低位量化(如 Q2、Q3)下会有可感知的质量下滑,Q4_K_M 通常被认为是"肉眼难以区分差异"的最低实用档。
管家层的四本账
服务层这位"管家"的日常,可以归纳为四件事:
- 拉取与删除:对接模型库,一条命令来去自由
- 登记与查询:列出家底,查档案
- 加载与调度:请求来了,把模型装进显存或内存
- 卸载回收:默认驻留五分钟,没人用就请出去,省下的显存就是下一次响应的速度
这四本账,正是入门时那些命令背后真正发生的事。
自定义模型:写份配方就行
做自定义模型不用训练,写一份 Modelfile 配方即可。这是官方定义的、用于创建和分享自定义模型的蓝图,核心是五条指令:
FROM:指定基座,唯一必填PARAMETER:调参数SYSTEM:一句话定人设TEMPLATE:提示词母版,一般沿用基座MESSAGE:预制对话示范
完整动手链:从配方到验收
第一步,写配方。 对照官方示例:FROM llama3.2,温度设 1(越高越发散),上下文设 4096,SYSTEM 让模型扮演马里奥。保存为纯文本文件 Modelfile。
第二步,create 建模型。 由于基座层本地已有,直接复用,只新写清单和参数层,所以几乎秒级完成,不用重新下载几个 G。看到 success,库里就多了一个叫 mario 的模型,用 ls 能查到。
第三步,run 验证。 问它"你是谁",回答带着马里奥的口吻,说明 SYSTEM 人设生效。注意:底层本事没变,权重还是那个基座,变的只是系统提示和两个参数。所谓自定义模型,本质是一份指向基座的配置。
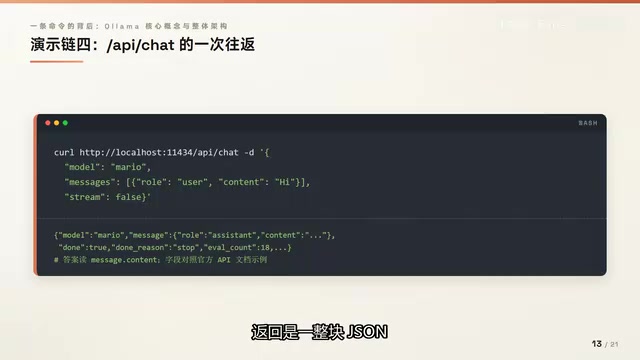
第四步,用程序调用。 往本机端口发一个对话请求,模型填 mario,返回是一整块 JSON,答案在 message.content 里。注意 stream 不写时默认开启,回答会一块块流式返回,关掉才是一次性拿全。
第五步,查档验收。 量化栏显示是 Q4 混合量化变体,继承自基座;参数区温度 1、上下文 4096,正是配方里写的两行。基座给了身体,配方给了性格。
接口双轨:原生 REST 与 OpenAI 兼容
官方 README 的 REST API 一节说明,Ollama 提供一套 REST 接口,和前面演示的请求走的是同一个端口、同一条路径。往下还有官方 Python 库,一行命令即可安装。命令行、REST 接口、官方 SDK,三条路通向同一个本机服务。
那么 OpenAI 的现成客户端为什么也能连?因为服务还开着一个兼容层,路径前缀 /v1。代价是官方也写明了:它是 OpenAI 接口的一个子集,个别字段不支持。
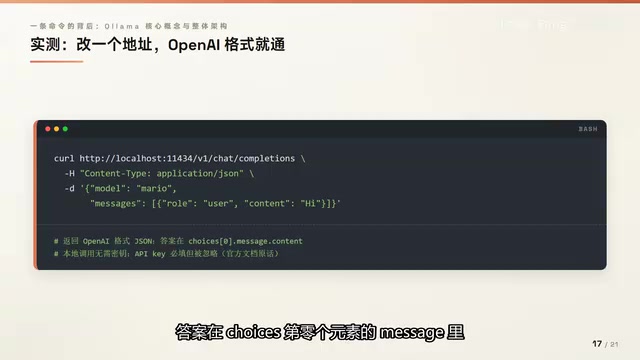
OpenAI 协议没地方设上下文长度,官方给的解法正是用 Modelfile 建一个新模型。实测把路径从 /api 换成 /v1/chat/completions,请求体几乎不变,返回直接是 OpenAI 格式,答案在 choices 第零个元素的 message 里。官方原话是"本地调用密钥必填但被忽略"——改个地址不换代码,这就是兼容层的价值。
四个关键数字与硬件加速
接入应用时,有四个数字管住这个服务:
- 11434:默认端口,只对本机开放
- 4096:默认上下文长度
- 五分钟:模型默认驻留时长,参数
keep_alive可调,设 0 立即卸载 - 5.0:N 卡最低算力档
加速方面,服务启动就会探测硬件,调度器读驱动上报的显存,决定模型放显卡还是内存。加速路线有四条:N 卡 CUDA、A 卡 ROCm、Mac Metal,还有 Vulkan 兜底,环境变量可指定用哪张卡。引擎本体是 llama.cpp,Apple 平台上还有一个 MLX 引擎可选。
llama.cpp 是整个推理链的最底层,由 Georgi Gerganov 于 2023 年初发起,目标是在消费级硬件上高效运行 LLaMA 系列模型。它以纯 C/C++ 实现,通过 BLAS 接口对接不同硬件后端:CUDA 对应 N 卡、ROCm 对应 A 卡、Metal 对应 Apple Silicon 的统一内存架构。Apple 平台上额外支持的 MLX 引擎则是 Apple 自研的机器学习框架,专为 M 系列芯片的统一内存设计,在吞吐量和能效上与 Metal 路线各有侧重。Ollama 在启动时通过探测驱动版本和算力版本(Compute Capability,即文中提到的 5.0 最低档)来决定编译哪条加速路径的共享库,并在运行时动态加载,这也是为什么同一个 Ollama 可执行文件能在多种硬件环境下开箱即用。
一句话收束整个架构
把本期装进一句话:管家层管模型,引擎层管推理,接口层管说话。 一份配方建出自定义模型,一次对话看清三层协作。
归纳要点:
- 分层上,命令行收命令、服务管模型与调度、引擎做推理
- 存储上,清单加分片,GGUF 单文件自包含
- 量化档位先读 Tag 名,Q4 是默认填仓
- 自定义模型用 Modelfile 加 create,秒级完成
- 接口双轨:原生全功能,V1 兼容零改造
理解了这套分层架构,再往深读源码实现,每一个概念都能找到对应的落脚点。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。