Ollama零基础教程:本地部署大模型入门指南
Ollama是开源免费的大模型本地管理平台,降低部署门槛,保障数据隐私。
本文介绍了Ollama这一开源大模型管理平台,旨在解决在线API服务成本高、数据隐私风险及模型不可定制的问题。Ollama支持跨平台(macOS、Windows、Linux、Docker),提供命令行和Web UI两种交互方式,并能自动调度CPU/GPU资源,简化本地部署流程。其四大特点包括开源免费、跨平台、简单易用和性能优化。典型应用场景涵盖本地知识库问答、API集成开发和模型实验微调。总结指出,Ollama让开发者专注于应用而非环境配置,适合个人低成本探索和企业私有化部署。
在线大模型服务虽然方便,但API调用按Token计费,长期使用成本不低,且数据需上传至第三方。如果你希望零成本、数据私有、还能自由定制模型,Ollama提供了一个优雅的解决方案。
Ollama是什么?
简单说,Ollama是一个开源的大模型管理平台。它帮你把开源模型(如DeepSeek广告、Llama等)下载到本地,并提供命令行和Web UI两种交互方式。你不再需要手动配置复杂的GPU环境,Ollama会自动调度CPU和GPU资源来运行模型。
Ollama的核心价值在于降低本地部署门槛。以往在本地跑大模型需要折腾CUDA、PyTorch等依赖,现在安装Ollama后即可直接拉取和运行模型。
开源大模型是指模型权重、架构和训练方法公开可获取的AI模型,如Llama、DeepSeek、Qwen等。与闭源模型(如GPT-4)不同,开源模型允许用户自由下载、修改和商用(需遵守相应许可证),这为本地部署和定制化提供了基础。Ollama正是围绕这些开源模型构建的管理工具,它本身不训练模型,而是简化了模型的获取、运行和切换流程。
Token计费是大模型API常见的计价方式,Token是文本处理的基本单位,约等于一个汉字或英文单词的一部分。在线服务按输入和输出的Token数量收费,高频调用时成本会累积。本地部署则消除了按量计费,只需承担硬件和电力成本。
为什么需要本地部署?
在线服务如ChatGPT、文心一言、通义千问广告等,使用方便但有明显局限:
- API调用按Token计费:虽然DeepSeek等模型价格较低,但企业级高频调用仍是一笔开销。
- 数据隐私问题:敏感数据需上传至第三方服务器。
- 模型不可定制:你只能使用服务商提供的固定模型。
本地部署开源模型可以解决这些问题。模型运行在你自己的机器上,API调用不产生费用,数据不出本地,还能基于现有模型灌入私有知识库,构建领域问答机器人。
Ollama的四大特点
1. 开源免费
Ollama完全开源,个人和企业均可免费使用,没有隐藏的授权费用。
2. 跨平台支持
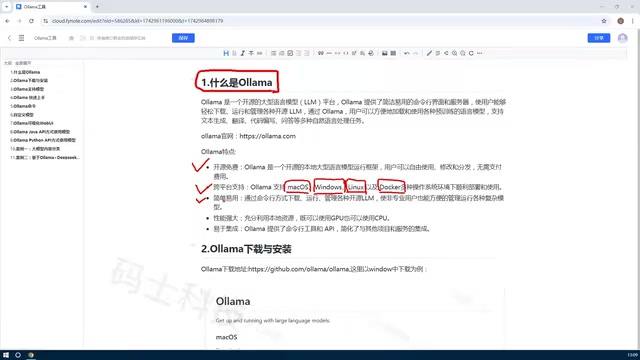
支持macOS、Windows、Linux,也提供Docker镜像。个人开发者可在Windows或Mac上快速体验,企业则可通过Linux或Docker在生产环境部署。
3. 简单易用
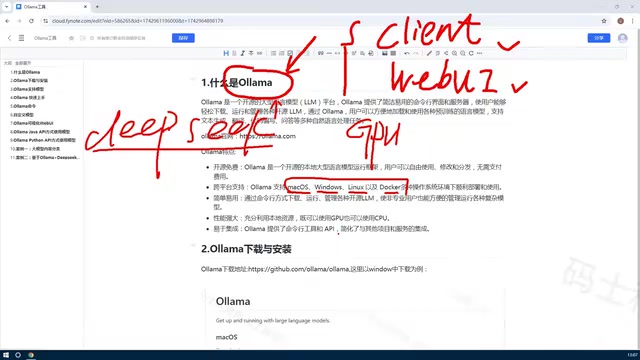
提供两种使用方式:命令行(Client)适合脚本和自动化,Web UI适合图形化操作。两者都支持模型的下载、删除和自定义创建。
4. 性能与资源调度
Ollama能自动利用GPU和CPU资源。有GPU时优先使用GPU加速,没有GPU时回退到CPU运行。这大幅降低了硬件门槛——当然,模型越大,对机器配置要求越高。
GPU加速依赖CUDA(NVIDIA)或Metal(Apple Silicon)等计算框架,Ollama内置了针对不同硬件的优化后端,能自动检测可用GPU并将模型层分配到显存中。当显存不足时,它会将部分层卸载到CPU内存,实现混合推理,虽然速度下降但保证了可运行性。这种动态调度机制是Ollama降低使用门槛的关键,用户无需手动配置环境变量或编写推理代码。
典型应用场景
- 本地知识库问答:将企业内部文档灌入模型,构建私有化问答系统。
- API集成开发:通过Ollama的API接口,用Python、Java、Rust等语言调用本地模型,无需支付在线API费用。
- 模型实验与微调:基于开源模型创建自定义版本,用于研究和测试。
私有知识库问答通常采用检索增强生成(RAG)模式:将企业文档切分、向量化后存入向量数据库,查询时先检索相关片段,再连同问题一起交给本地模型生成答案。Ollama提供Embedding模型和生成模型的API,可配合LangChain、LlamaIndex等框架搭建完整流水线,确保敏感数据不出内网。
总结
Ollama解决了本地运行大模型的核心痛点:环境配置复杂、资源调度困难、模型管理繁琐。它让开发者能专注于应用开发,而非底层环境。对于想低成本探索大模型能力的个人,或是需要数据隐私的企业,Ollama是一个值得上手的工具。
相关推荐

64G内存笔记本跑大模型,实际可用仅46.7G
华硕ProArt创16实测:64G内存标称值下模型可用仅46.7G,128G版官方上限1200亿参数。本文拆解9000元内存差价、统一内存占用真相、续航表现,并给出三步自查方法,帮你判断本地跑大模型该买多大内存。

LangGraph 实战:开发者真实工作流与技术栈剖析
从 Reddit 开发者提问切入,剖析 LangGraph 在实际生产中的工作流设计、技术栈组合、图结构模式与调试痛点,总结从教程走向落地的关键实践与可观测性需求。
四足机器人Wouf首秀:ST3215舵机速度慢却步态更快
四足机器人Cubic Doggo新版本Wouf首次行走,开发者发现ST3215舵机反馈读取延迟拖慢控制循环,禁用后步态反而更快,并探讨同步读取固件对强化学习的重要性。