Ollama入门指南:本地跑大模型的最低门槛工具

Ollama用三条命令消除本地跑大模型的所有门槛,扮演「管家+引擎」角色让消费级硬件也能运行开源大模型。
Ollama是一个开源本地大模型管理工具,将环境配置、模型格式转换和显存资源管理全部封装进单一可执行文件。其核心设计是「管家加引擎」分层架构:用户面对的是统一的命令行和HTTP接口,底层推理由llama.cpp引擎完成,模型以GGUF量化格式存储,让消费级硬件也能承载。三条命令——安装、拉模型、对话——覆盖完整上手流程。本地路线的核心价值在于隐私不出机、离线可用、无账单成本和完全的实验自由,代价是速度受硬件封顶、无法跑超大旗舰模型。选型口诀清晰:原型、隐私、练手选本地,高并发、旗舰模型看云端。
Ollama解决了什么问题
想在自己电脑上跑大模型,普通人往往会撞上三道坎。第一道是环境坎——推理框架需要编译,依赖一堆显卡环境,很多人配到一半就放弃;第二道是格式坎——模型权重动辄几十GB,格式不通用,转换脚本足以劝退新手;第三道是资源坎——多大显存跑多大模型,量化压缩还得自己动手。
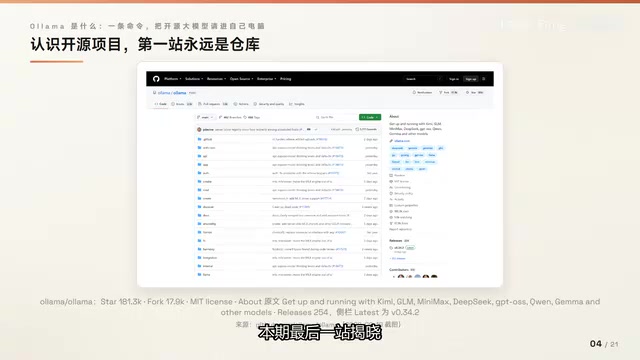
Ollama的答案是把这三件事全部藏进一条命令。它是一个用主流语言编写、可编译为单一可执行文件的开源项目,采用MIT许可证,商用零负担。在GitHub上已累计超过十八万颗星,是本地大模型工具里的绝对顶流。你只需装好它,一条命令拉取官方模型(约7.2GB),再一条命令就能开始对话。
心智模型:一个管家带一个引擎
理解Ollama最简单的方式,是把它想成「一个管家带一个引擎」。你只跟管家说话:一条命令拉模型,一条命令开对话。管家负责下载模型、按需加载进显存、对外提供统一接口,而真正算出回答的是内置的 llama.cpp 引擎,它读取 GGUF 量化模型。
这种分层设计的好处很实在:引擎升级你无感知,模型更换零成本。用一个常见类比,Ollama 之于本地大模型,就像 Docker 之于容器——底座是别人的(llama.cpp 是社区项目),但体验是自己打磨的。Ollama 干的是工程活:统一格式、按需加载、管好显存、对外给稳定接口。模型本身几乎不由它来算。
llama.cpp 是由 Georgi Gerganov 于2023年发起的开源项目,用纯 C/C++ 实现大模型推理,核心目标是在无需 GPU 的普通硬件上也能运行 LLaMA 系列模型。它支持 CPU 推理,同时也能调用 Metal(苹果芯片)、CUDA(NVIDIA)、ROCm(AMD)等加速后端,做到「有卡用卡,没卡靠 CPU」。GGUF 是 llama.cpp 定义的模型存储格式(前身是 GGML),将模型权重、量化参数和元信息打包进单一文件,方便分发与加载。量化指的是把模型权重从原始的 32 位或 16 位浮点数压缩成更低精度(如 4 位整数),体积和显存占用可缩小数倍,推理速度也更快,代价是精度有轻微损失。Ollama 在 llama.cpp 之上加了一层调度和接口,用户无需关心这些细节。
为什么要把模型搬回本地
云端接口随手可用,为什么还要费劲把模型搬回本地?官方给出了四个理由。
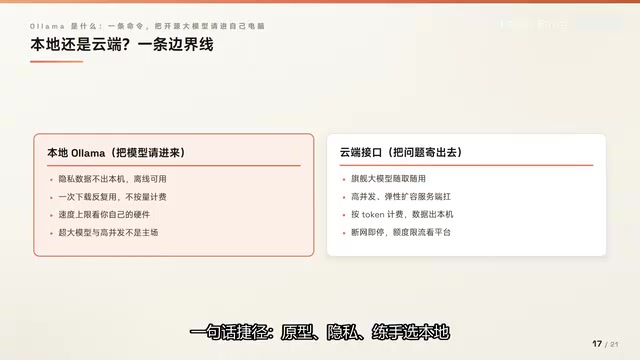
隐私:官方常见问题页写明,本地运行时不收集你的提示和数据。离线:模型装在本机,断网也照常用。成本:本地推理不按次计费,没有账单焦虑。自由:模型文件在自己手里,做实验随便折腾。
当然,本地路线也有代价——速度由硬件封顶,超大模型和高并发场景力不从心。云端路线则是旗舰模型随取随用、并发有服务端扛,代价是按量计费、数据出本机。官方文档对本地和云端两条路各给了一条调用示例,并不偏废。
三条命令跑通全流程
从安装到对话,整个流程只需三条命令。
第一步安装:macOS 和 Linux 用一条官方脚本命令,Windows 用一条 PowerShell 命令,也提供桌面安装包和 Docker 镜像。装完敲 ollama 回车会进入首次设置向导,可以选择登录用云模型或继续本地模式。全程无需手动配置显卡驱动,门槛被真正拆掉了。
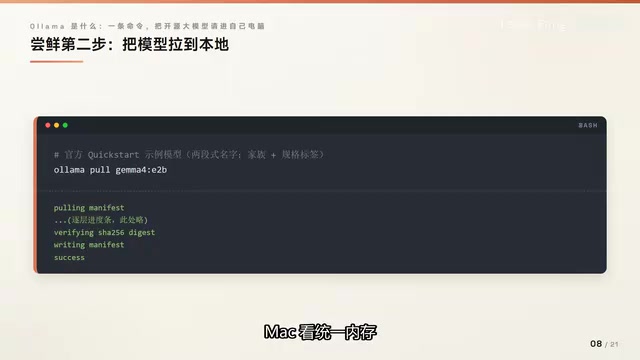
第二步拉模型:模型名采用两段式,比如 gemma3,冒号后的规格标签表示参数量。官方口径下载约 7.2GB,建议至少 8GB 可用显存(Mac 看统一内存)。执行后会先拉清单,再按层显示进度条,最后报告成功。
第三步对话:运行命令时若遇到没拉过的模型会自动先拉,然后进入聊天界面,回答一个字一个字地流式吐出。输入斜杠命令即可离开。
此外还可以用列表命令查看本地模型,它会给出名字、编号、体积、修改时间四列信息。模型文件默认放在用户主目录的 Ollama 数据目录,想搬家改一个环境变量即可,不要的模型用一条删除命令清理,不占冤枉磁盘。
几个关键数字与版本辨识
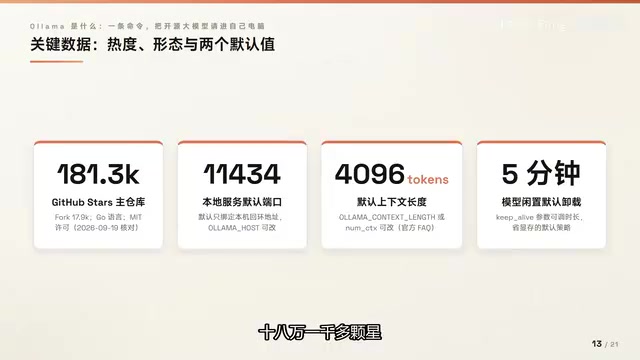
认识 Ollama 的形态,可以记住几个来自官方仓库的数字:11434 是本地服务端口,默认只对本机开放;4096 是默认上下文长度,想加大去环境变量里改;5分钟 是模型闲置后默认卸载的等待时间,这是显存紧张时的温柔设计。
看开源项目要分清版本标记。列表顶上挂着「预发布」标签的版本并不是生产首选,真正的最新稳定版标注着 Latest。预发布尝鲜、稳定版用于生产,这个习惯值得养成。
模型从哪来?官网模型库聚齐了各家开源家族:Meta 的 Llama 系列是老牌基座,提供 8B、70B、405B 多档;DeepSeek广告 的 R1 推理家族从 1.5B 到 671B,覆盖设备级到数据中心级;阿里的通义覆盖最宽,Google 的 Gemma 偏设备端,OpenAI 也放出了开放权重,GLM、Kimi、MiniMax 等均在列。每张卡片标注规模、标签和更新时间,看中哪个一条命令带走。
上下文长度(Context Length)决定了模型在一次对话中能「记住」多少文本。4096 个 token 大约对应 3000 个英文单词或 2000 个汉字,对日常对话和短文处理通常够用,但处理长文档或多轮深度对话时会显得紧张。将上下文调大(如 8192、32768)能让模型处理更长的输入,但显存占用会随之线性甚至二次方增长,因此默认值是在通用性和资源消耗之间取的折中。Ollama 通过环境变量 OLLAMA_NUM_CTX 或在 Modelfile 中设置 num_ctx 参数来调整这一上限,具体能设多大取决于显存余量。
选型边界:什么时候该用它
工具用得顺手,关键是认清能力圈。有三类场景适合请 Ollama 出场:本地原型和离线环境,模型随叫随到;隐私敏感的文本处理,数据不出本机;给应用配开发模型接口,它兼容 OpenAI 和 Anthropic 客户端,改个地址就指向本地(但官方提醒兼容只覆盖子集),调试不花钱。
也有两类场景要绕开:高并发的生产推理服务,那是专用推理站的主场;以及非旗舰不可、家用硬件装不下的超大模型场景。
一句话总结选型边界:原型、隐私、练手选本地,高并发、旗舰看云端。Ollama 承接的是本地大模型的管家角色,下载、加载、接口这些杂活全包,你只管说要做什么,真正的推理交给引擎,量化格式让消费级硬件也接得住。「管家加引擎」这个模型将贯穿后续内容,下一步就是亲手把它跑起来,收到模型的第一句回答。
Ollama 兼容 OpenAI 客户端 SDK 的原理是在本地 http://localhost:11434 上暴露与 OpenAI REST API 路径相同的端点(如 /v1/chat/completions),这样只需把 base_url 改为本地地址、api_key 填任意字符串,现有代码无需改动即可切换到本地模型。Anthropic 兼容层同理。「兼容只覆盖子集」意味着部分高级参数(如 OpenAI 特有的函数调用格式细节、流式工具调用等)可能行为不一致,在生产环境使用前需要针对性测试,开发和调试阶段则几乎透明。
相关推荐

Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南
深度拆解基于Harness(驾驭工程)架构的企业级智能体实战项目,涵盖多模型配置、ASGI部署、MCP协议对接ERP系统、Sandbox沙箱隔离等核心模块,帮助AI大模型求职者理解工程化落地方向的面试要点。

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。

系统设计面试笔记开源项目:2.4万星的学习利器
开源项目 liquidslr/system-design-notes 整理了经典书籍《System Design Interview》的学习笔记,GitHub 收获 2.4 万 Star。本文解析其内容价值、适用人群及系统设计面试复习建议。