OpenAI AI发现PHP关键漏洞:影响70%网站的安全警报
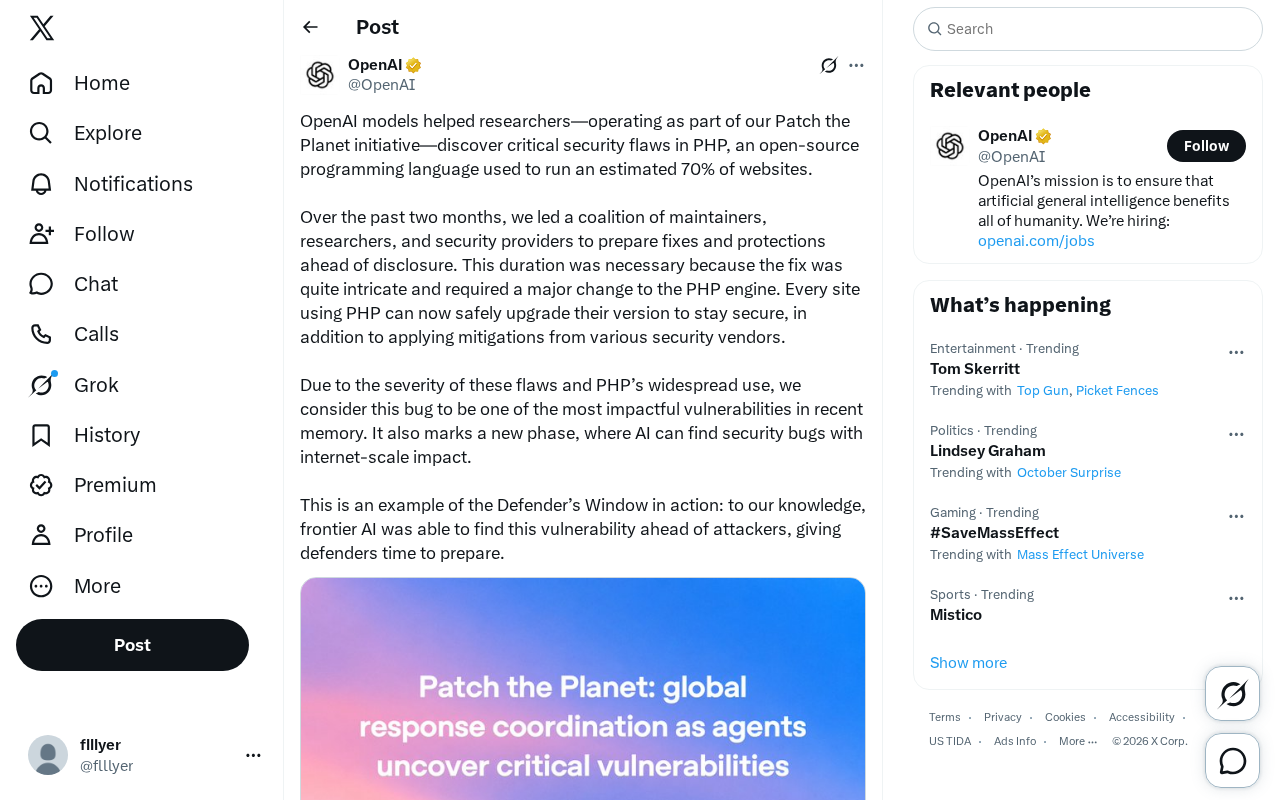
OpenAI称其AI在PHP中发现高危漏洞并协调修复,展示“防御者窗口”。
OpenAI 通过“Patch the Planet”计划,称其 AI 模型在支撑约 70% 网站的 PHP 中发现一个关键安全漏洞,并评价为近年来影响最严重的漏洞之一。由于修复需要对 PHP 引擎做重大变更,OpenAI 牵头维护者、研究人员与安全厂商组成联盟,花费约两个月准备补丁与缓解措施,采取先修复后披露的协同模式。OpenAI 将事件定位为“防御者窗口”的范例:前沿 AI 若先于攻击者发现漏洞,防御方就能争取时间避免大规模利用。但 AI 的实际贡献与“先于攻击者”的说法仍缺乏第三方独立验证,漏洞技术细节也未公开,透明度与协作范式成为后续讨论焦点。
OpenAI 通过其「Patch the Planet」计划,利用 AI 模型在开源编程语言 PHP 中发现了一个关键安全漏洞。PHP 支撑着全球约 70% 的网站,这一发现被 OpenAI 称为「近年来影响最严重的漏洞之一」。更值得关注的是,从发现到修复的整个过程展示了 AI 在网络安全领域的新角色——在攻击者之前找到漏洞,为防御者争取时间。
漏洞发现:AI 在 PHP 引擎中挖出高危缺陷
据 OpenAI 官方披露,其 AI 模型协助研究人员在 PHP 中发现了一个关键安全漏洞。PHP 作为开源编程语言,被估计约 70% 的网站使用,包括大量内容管理系统和Web应用。这一漏洞的特殊之处在于修复难度极高——需要对 PHP 引擎进行重大变更。
OpenAI 将此次发现归功于「Patch the Planet」计划,该计划旨在利用 AI 模型主动发现并修复开源软件中的安全缺陷。与传统的漏洞挖掘方式相比,AI 模型能够在海量代码中快速定位潜在风险点,显著缩短从发现到确认的周期。
由于这些漏洞的严重性和 PHP 的广泛使用,我们认为这是近年来影响最大的漏洞之一。这也标志着一个新阶段:AI 能够发现具有互联网规模影响的安全漏洞。——OpenAI 官方声明
PHP 引擎(通常指 Zend Engine)是 PHP 语言的核心执行部件,负责词法/语法解析、编译为 opcode、内存管理与扩展接口等。对引擎层进行“重大变更”意味着改动会触及所有 PHP 应用共用的底层行为,风险远高于修某个扩展或框架代码:既要保证向后兼容,又要覆盖不同版本分支与大量 SAPI(如 FPM、Apache 模块)场景。因此此类修复往往需要更长的评审、回归测试与发布协调周期,也解释了为何修复方案需要联盟提前准备而非即时上线。
协同修复:两个月准备期背后的工程挑战
在披露之前,OpenAI 牵头了一个由维护者、研究人员和安全厂商组成的联盟,花费约两个月时间准备修复方案和防护措施。这个时间跨度并非偶然——修复涉及 PHP 引擎的核心改动,需要确保兼容性和稳定性,避免在修补过程中引入新的问题。
这种「先修复、后披露」的协同模式在安全社区中并不陌生,但由 AI 厂商主导协调多个利益相关方,仍属少见。OpenAI 表示,目前所有使用 PHP 的网站都可以安全升级版本,同时也可以采用各安全厂商提供的缓解措施。
你可能没注意到,修复的复杂性意味着部分站点可能无法立即升级。对于这些场景,安全厂商的临时防护方案成为关键的过渡手段。
“先修复、后披露”对应的安全实践通常被称为负责任披露(Coordinated Disclosure):发现方在公开细节前,先与维护者和受影响厂商私下协调,给出补丁、缓解措施与升级指引,并约定披露时间窗口。其目的是降低“补丁可用前的空窗期”被大规模利用的概率。由 AI 厂商牵头协调多个利益相关方并不常见,因为这要求其同时具备漏洞验证能力、跨组织沟通能力与对开源社区发布节奏的尊重;协调不当可能造成信息泄露或补丁质量不足。
防御者窗口:AI 与攻击者的时间竞赛
OpenAI 将此次事件称为「防御者窗口」(Defender's Window)的实践范例。其核心逻辑是:如果前沿 AI 能够比攻击者更早发现漏洞,防御方就有时间准备补丁和缓解措施,从而避免大规模利用事件的发生。
这一概念背后是对 AI 双用途性质的现实认知——同样的模型能力,既可以用于攻击,也可以用于防御。OpenAI 声称,据其所知,前沿 AI 在此次事件中先于攻击者发现了漏洞。不过,这一说法目前仅来自 OpenAI 单方面披露,尚未有第三方独立验证攻击者是否确实未能更早发现该漏洞。
从行业视角看,AI 辅助漏洞挖掘正在从实验室走向实际应用。此前已有多个研究项目展示了大语言模型在代码审计中的潜力,但真正产生互联网级影响的案例仍然稀少。PHP 漏洞的发现,可能成为这一方向上的标志性事件。
“防御者窗口”可理解为漏洞生命周期中的时间差:从漏洞被某一方发现到被广泛利用之间存在窗口期。若防御方更早获得可操作的信息并完成修补,就能把窗口压缩到攻击者难以规模化利用的程度。该概念与“AI 双用途”紧密相关:模型可用于代码审计、模糊测试种子生成、补丁建议,也可被用于逆向与漏洞定位。争议点在于证据链:要证明“AI 先于攻击者发现”,通常需要可审计的发现时间线、独立复现与第三方评估,否则只能视为厂商自述。
行业影响:开源安全的新变量
PHP 漏洞事件对开源安全生态提出了新的问题。一方面,AI 驱动的漏洞发现效率提升,意味着更多缺陷会被更快曝光,维护者的修复压力随之增加。另一方面,如果 AI 厂商能够主动协调修复并向社区披露,可能形成一种新的安全协作范式。
对于使用 PHP 的网站运营者而言,当务之急是确认版本状态并尽快升级。OpenAI 强调,升级是确保安全的根本方式,安全厂商的缓解措施可作为补充。
从更长远的角度看,此次事件也引发了对 AI 安全工具透明度的讨论。OpenAI 未在公开声明中披露漏洞的具体技术细节,这符合负责任披露的惯例,但也让外界难以独立评估 AI 在发现过程中的实际贡献程度。随着更多类似案例出现,如何在安全保密与公共知情之间取得平衡,将成为行业持续面对的问题。
(本文基于 OpenAI 官方推文内容整理,部分背景信息为行业常识补充。)
相关推荐
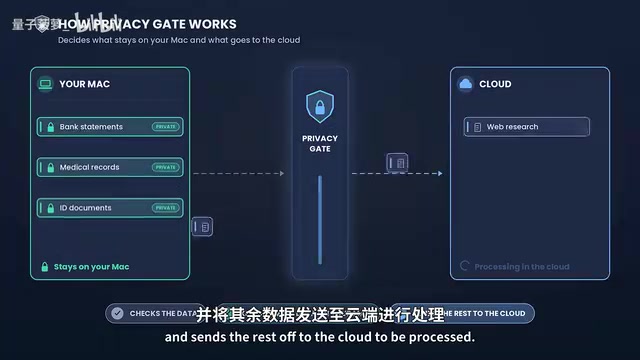
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
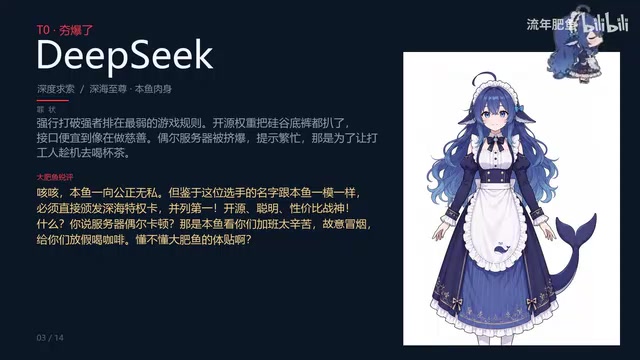
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。