OpenAI对Cursor断供内幕:SpaceX收购引发的模型战争
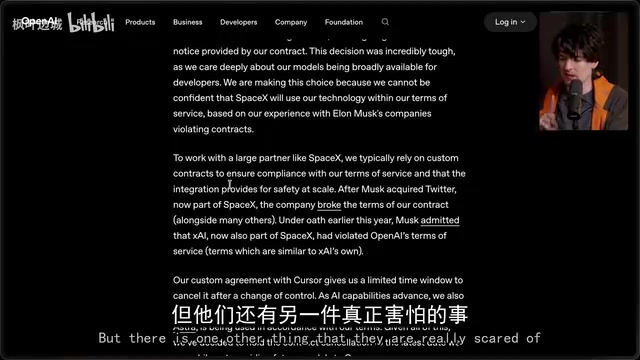
SpaceX收购Cursor后,OpenAI以防模型蒸馏为由宣布11月12日断供,AI供应链政治博弈正式传导至终端开发者。
SpaceX完成对AI编程工具Cursor的收购后,OpenAI随即宣布切断Cursor用户对其模型的直接访问,截止日期为11月12日。表面理由是合同终止,深层原因是OpenAI担心Elon Musk旗下公司借助付费调用其模型来蒸馏训练数据,尤其担心即将发布的高能力新模型Astra的优势被竞争对手获取。Anthropic此前已多次以相同理由对XAI、Windsurf等实施类似封禁。双方高层的公开互怼进一步激化矛盾,Cursor所称OpenAI仅占5%流量的说法因忽视token效率差异而受到质疑。对依赖Cursor作为多模型聚合平台的开发者而言,直接订阅官方实验室或转向开源工具成为主要出路,而这场AI供应链的政治博弈预计还将持续升级。
AI编程工具圈子刚刚经历了一场地震。OpenAI宣布终止与Cursor的合作,计划在11月12日切断Cursor用户对OpenAI模型的直接访问。这背后的导火索,是SpaceX对Cursor的收购,以及Elon Musk与OpenAI之间长期积累的深层矛盾。这不只是一次普通的商业分手,更像是AI大模型时代供应链博弈的一个缩影。
事件全貌:SpaceX收购Cursor,OpenAI随即断供
据海外知名开发者博主(T3创始人Theo)的紧急解读,整个事件的脉络逐渐清晰。SpaceX原本计划与Cursor进行联合合作,方案有两种:要么SpaceX AI向Cursor支付100亿美元换取数据和RL(强化学习)工程能力,用于提升Grok模型;要么在年底以600亿美元直接收购Cursor。最终SpaceX选择不再等待,直接完成了收购。
博主本人透露,他曾是Cursor的早期投资人,如今随着收购完成,他与Cursor的利益绑定其实已经结束,因此表示会更客观地评论此事。他同时强调自己在OpenAI没有任何财务关联,反而是重度付费用户,Anthropic才是他花钱最多的公司。
OpenAI的官方措辞是:由于SpaceX收购Cursor,他们决定终止提供OpenAI模型的合同,关停日期定为11月12日——这已经是合同允许的最长通知期。表面看是「好聚好散」,但真正的原因藏在后面。
断供的真正原因:蒸馏、数据与即将发布的Astra
OpenAI在声明中给出了关键理由:基于Elon Musk旗下公司「违反合同」的过往经验,他们无法确信SpaceX会在服务条款范围内使用其技术。
这里的核心担忧是模型蒸馏(distillation)。Elon本人已在公开记录中承认,XAI会从OpenAI模型中蒸馏数据来改进自家模型。而Cursor作为AI编程工具,长期积累了海量的真实编程数据——正是这些数据让Cursor自研的Composer模型表现出色。如今这些数据归属SpaceX,也就是归属Elon。OpenAI显然不希望竞争对手通过付费调用其模型,反手获取训练数据。
更关键的一层,是OpenAI即将发布的新模型Astra。博主指出,OpenAI真正担心的是Astra能力的领先性被竞争对手蒸馏。声明中明确提到「随着AI能力提升,我们对即将发布的模型Astra有新的问责要求」。换句话说,这次断供的时间点选择,与Astra的发布节奏密切相关。
博主也指出了其中的商业逻辑:Cursor享受的并非订阅用户那种80%-95%的巨额补贴,其调用价格折扣大约在20%-30%区间。如果Cursor付费调用OpenAI模型,同时又保留调用产生的数据用于训练,就相当于「双重获利」——向客户收费的同时白拿了训练素材(前提是用户没有勾选「不使用我的数据」)。
模型蒸馏(Model Distillation) 是一种将大型、高性能模型的"知识"迁移到小型模型的技术。传统蒸馏是让小模型(学生)模仿大模型(教师)的输出分布,从而在不直接访问原始训练数据的情况下逼近大模型的能力。在AI竞争语境下,"蒸馏"的含义被进一步延伸:通过大量调用某个模型的API,收集其输入输出对,再用这些数据微调或训练自家模型——本质上是用付费调用变相"购买"训练数据。这种行为通常被各大模型厂商的服务条款明确禁止,但实操中极难取证。Cursor积累的海量真实编程场景数据尤为珍贵,因为这类数据反映了专业开发者在实际工作中的代码写法、调试习惯和问题解法,是通用语料中极难获取的高质量信号,对提升代码生成类模型能力有直接价值。
历史先例:Anthropic早已多次出手
这种「断供防蒸馏」的操作并非首次。博主梳理了几个先例:
- 当Windsurf传出被OpenAI收购时,Anthropic曾封禁其在Windsurf中访问Claude模型,理由同样是担心用于蒸馏。
- 年初时,XAI就已被禁止通过Cursor使用Anthropic模型,理由是担心XAI用这些数据做RL训练。
- Anthropic还曾撤销OpenAI对Claude API的访问权限,据传是因为OpenAI用它做基准测试对比。这也解释了为什么OpenAI自己的benchmark里很少出现Anthropic模型。
有意思的是,Anthropic与XAI表面上是竞争对手,但因为Anthropic严重依赖SpaceX提供算力,加上双方都对OpenAI心怀敌意,反而结成了微妙的同盟。Anthropic的算力负责人甚至在此事中公开示好SpaceX,表示会继续为Cursor增加算力支持——尽管紧接着Claude Code的使用额度又被下调了约17%。
博主对整个生态的评价一针见血:所有人都在蒸馏,Elon承认了,这本不该是大问题。数据就是数据,OpenAI和Anthropic早年趁互联网尚未设防大量采集数据,本身就占了先发优势。如今却对付费获取数据的行为严防死守,「对整个生态不是好事」。
强化学习(RL,Reinforcement Learning) 在此语境中特指RLHF(基于人类反馈的强化学习)及其变体,是当前训练顶级大语言模型不可缺少的对齐与能力提升阶段。简单来说,模型先生成多个回答,再由人类或另一个"奖励模型"对这些回答打分,通过反复迭代让模型学会产出更高分的回答。真实用户在实际场景中的使用数据——比如Cursor用户真实的编程请求——比人工标注数据更能反映"好答案"的标准,因此对RL训练极具价值。Anthropic和OpenAI担心的正是:竞争对手通过付费调用API获取大量真实的输入输出对,将其作为RL训练的正样本或奖励信号,从而以极低成本大幅提升自家模型在编程等垂直领域的能力。
公关口水战:5%流量数字之争
事件发酵后,双方高层的隔空互怼让局面更加难看。Cursor方面(Michael)发文称OpenAI模型仅占Cursor用户流量的约5%,试图淡化影响。但博主认为这个数字「有点过分」。
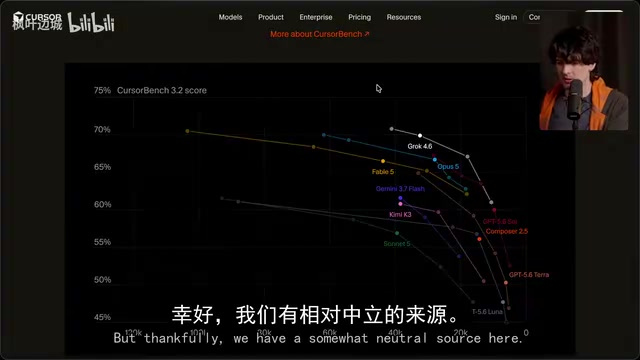
问题的核心在于token效率。OpenAI模型的token效率远高于竞品,如果单纯用token数量衡量使用占比,OpenAI模型天然会「看起来很少」。博主引用Artificial Analysis和Cursor自己的benchmark数据说明:GPT-5.6 Sol完成任务约需17k-28k token,而Anthropic的Fable则需要36k甚至103k token,差距超过3倍。这意味着按token算的5%,若换算成实际请求或价值,可能更接近15%。
OpenAI的Thibaut也回击称「token不是收入或价值的代理指标,OpenAI模型处于token效率的最前沿」——博主认为这话虽然正确,但同样没必要挑起个人恩怨。他调侃道,公司高层公开搞beef「影响的是用户」,而Thibaut和Michael本人的生计并不会因此受损,这种争吵「显得幼稚且没有必要」。
Token(词元)是大语言模型处理文本的基本单位,大致上英文每个单词约对应1-1.5个token,中文每个汉字约1-2个token。模型的调用成本和使用量通常按token数计费。Token效率指的是模型完成同等质量任务所消耗的token数量——效率越高,完成相同任务所用token越少。不同模型在token效率上可能存在数倍差异:同样是完成一个编程任务,效率高的模型可能只需要20k token,效率低的模型可能需要60k甚至更多。这意味着如果仅用token消耗量来衡量"使用占比",高效率模型会系统性地被低估——其产生的实际业务价值和请求数量远超token数字所反映的比例。这正是Cursor所报告的5%数字存在争议的技术根源。
用户该如何应对?
对于依赖Cursor作为「一站式」多模型平台的开发者,博主的建议相当直接:如果你想用一个订阅搞定所有模型,基本没戏了。
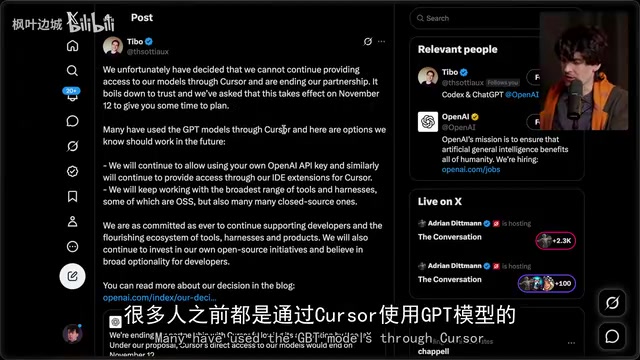
现实是,直接向模型厂商订阅(如200美元的Claude Code或Codex订阅)拿到的额度和补贴,远超任何聚合服务。聚合平台无法提供实验室级别的补贴——同一个prompt,T3Chat可能成本2美元,而ChatGPT只需20美分,根本无法竞争。
可行的过渡方案包括:
- 继续在Cursor中使用自己的OpenAI API key;
- 通过OpenAI的IDE扩展(如Codex插件)在Cursor内调用;
- 转向直接订阅官方实验室。
如果愿意接受Grok,Cursor+XAI的生态仍然可用。博主坦言Grok 4.5和4.6已能胜任不少真实编程工作,但还不算Frontier级别,用惯了Fable和Sol的人会感觉「像回到石器时代」。
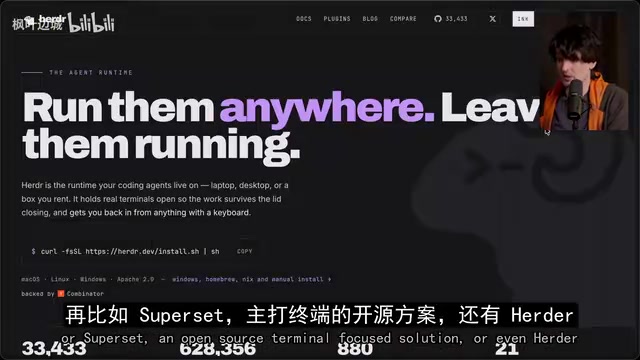
他还推荐了几款开源的终端/面板类工具作为统一入口,包括Gene、Superset以及新出现的Herder,这些都是开源方案。博主特别强调开源工具的优势:「不太可能被封禁」。他借此呼吁开发者「拥有自己的工具,让你和依赖产品的关系是直接的,而不是经过中间层」。
博主还顺带吐槽了Google——虽然模型不是最落后的,但因为封号策略最激进、桌面应用(Antigravity)体验糟糕,导致无法安全集成其订阅。
这只是开始
博主给出的判断值得警惕:这不会是一次性事件,而更可能是「结束的开始」。随着模型能力竞争白热化,Anthropic、OpenAI,乃至Google和SpaceX,都可能做出更多类似的断供动作。对开发者而言,这意味着「一站式多模型平台」的黄金时代正在褪色,供应链的政治博弈将越来越多地传导到终端用户身上。
对于每天在Cursor里用GPT-5.6 Sol写代码的人来说,11月之后将无法在Cursor中访问任何OpenAI模型,也无缘即将发布的Astra。这场「爸妈打架」的结局,最终由用户买单。
相关推荐
本地部署私人DeepSeek全攻略:联网+知识库+隐私安全
手把手教你用Ollama、Chatbox、AnythingLLM搭建纯本地、可联网、带知识库的私人DeepSeek。涵盖蒸馏版模型选择、RAG知识库原理与API调用,隐私安全零门槛部署全流程干货。
AI Agent开发四阶段学习路线:从入门到企业级实战
AI Agent开发零基础学习路线全解析:从核心概念、ReAct范式,到多智能体协作、Prompt调优与企业级实战项目,系统掌握规划、记忆、工具调用、RAG与MCP,帮你少走弯路成为AI核心人才。
DeepSeek Harness 新玩法:Agent 监督 Agent 的自进化实验
一位 B 站 UP 主基于 DeepSeek Harness 实现「Agent 监督 Agent」的自进化实验:用官方原版 DSH 作稳定监督者,驱动自研 Agent 完成任务并自动修复 bug,配合台账机制和 CDP、Chrome DevTools MCP 实现近乎无人值守的软件迭代。