OpenLLM:让AI令牌跨工具自由流动
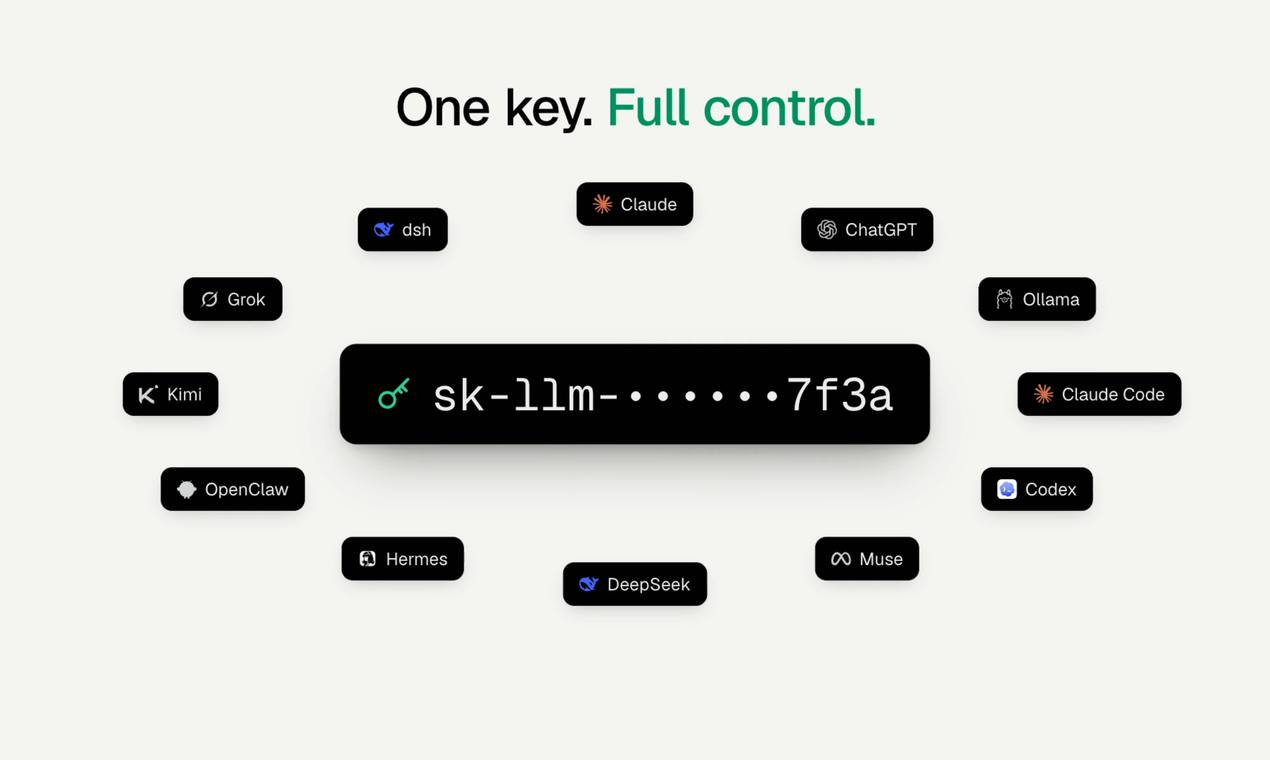
OpenLLM将订阅、API Key和本地模型统一为可跨工具调用的令牌池,实现额度接力与远程会话。
OpenLLM是一款在Product Hunt上亮相的开发者工具,目标是解决AI令牌被锁在不同平台、无法共享的问题。它把用户的ChatGPT订阅、Claude API Key和本地开源模型统一成一个可调用的令牌池,支持在Codex、任意编码Agent和Mac版ChatGPT应用中消费。核心能力包括跨工具调用、额度耗尽时自动切换以保持会话继续,以及远程启动编码会话让计算跑在家用机器上。产品定位介于代理层和开发工具之间,不做模型而是做令牌路由。目前Product Hunt获76票、排名第13,热度中等偏上,可能处于早期阶段。其实际价值取决于切换是否无缝、远程会话稳定性以及不同模型输出质量差异是否可接受。
为什么需要OpenLLM?
开发者常常面临一个尴尬局面:你在ChatGPT订阅里有一堆令牌,在Claude API里充了钱,本地还跑着开源模型,但这些资源被锁在不同的工具和平台里。写代码时用的Agent、聊天用的ChatGPT桌面端,彼此之间无法共享这些额度。一旦某个服务触达限制,工作流就断了。
OpenLLM在Product Hunt上打出的口号是“Take your AI tokens anywhere”,正是瞄准了这个痛点。它要做的,是把你的订阅、API Key和本地模型统一成一个可调用的池子,让令牌跟着人走,而不是跟着工具走。
核心功能:一个令牌池,多处消费
根据产品描述,OpenLLM提供三层能力:
- 跨工具调用:你可以在Codex或任意编码Agent中使用自己的订阅和API Key,也能在Mac上的ChatGPT应用里调用本地模型。
- 额度接力:当某个服务达到限制时,OpenLLM会自动切换,让会话继续下去,而不是直接中断。
- 远程启动会话:你可以在任意地点发起编码会话,实际的计算跑在家里的机器上。
这三点组合起来,本质上是把AI令牌从“平台绑定”变成了“用户资产”。对于同时使用多个模型服务的开发者来说,这种灵活性有实际价值——你不必因为某个工具的额度耗尽而停下手中的活。
令牌池(Token Pool) 是理解OpenLLM的核心概念。在传统模式下,每个AI服务的访问凭证(如ChatGPT订阅的OAuth令牌、Anthropic的API Key)都与特定平台强绑定,彼此隔离。令牌池则将这些分散的凭证抽象为一个统一的资源集合,由中间层按需调度。这类似于云计算中的“资源池化”:用户不再关心底层是哪个具体实例,只关心池中还有多少可用容量。实现上,OpenLLM需要维护各来源的凭证映射、配额状态和健康检查,并在请求时动态选择最合适的后端。这种模式的关键挑战在于,不同服务的认证协议和速率限制策略差异很大,池化层必须做精细的适配才能避免单点故障。
额度接力(Quota Failover) 借鉴了高可用系统中的故障转移机制。当某个AI服务的额度耗尽或触发速率限制时,系统自动将后续请求路由到池中其他可用来源,而不是向用户返回错误。这与负载均衡器在服务器宕机时切换后端节点的逻辑类似。实现无缝接力需要解决两个问题:一是状态同步,即切换后能否延续之前的对话上下文;二是质量一致性,不同模型的输出风格和能力不同,用户需要感知到切换的发生。OpenLLM的产品描述没有说明切换时是否保留完整上下文,这直接影响体验的连贯性。
设计思路与潜在场景
OpenLLM的定位介于“代理层”和“开发工具”之间。它不生产模型,而是做令牌的路由和调度。这种模式在API网关领域并不新鲜,但把它做到编码Agent和桌面应用层面,并且支持本地模型,是它比较特别的地方。
典型的使用场景可能包括:
- 白天在公司用Codex写代码,额度用完后自动切到家里的本地模型继续跑;
- 在Mac的ChatGPT应用里直接调用本地部署的模型,而不必另行配置;
- 出门在外时通过远程会话,让家里的机器执行编码任务。
这些场景对独立开发者和经常切换工具的人比较有吸引力。不过,远程会话的延迟、本地模型的响应速度,以及不同服务之间的切换是否平滑,都会直接影响体验。这些细节在Product Hunt页面上没有展开,需要实际使用才能判断。
本地模型(Local Model) 指运行在用户自己硬件上的开源大语言模型,如通过Ollama、llama.cpp或LM Studio部署的Llama、Mistral、Qwen等。与云端API相比,本地模型没有按令牌计费的成本,数据不出本机,隐私性更好,但受限于本地算力,推理速度和模型规模通常不及云端。OpenLLM将本地模型纳入令牌池,意味着它需要提供一个兼容层,把本地模型的推理接口伪装成云端API的格式,让编码Agent和桌面应用无需修改就能调用。这层兼容通常通过OpenAI兼容API实现,即本地模型服务器暴露一个与OpenAI Chat Completions格式一致的端点。真正的难点在于工具调用(function calling)、流式输出和上下文窗口管理,不同本地模型的实现成熟度参差不齐。
编码Agent(Coding Agent) 是能自主执行编程任务的AI系统,典型代表包括GitHub Copilot、Cursor、Codex CLI以及基于Claude的编程助手。这类工具通常需要配置模型后端,传统上只能指向官方API或特定云服务。OpenLLM声称可以让编码Agent使用用户的订阅和API Key,本质上是在Agent和模型服务之间插入一个路由层,拦截Agent发出的API请求并转发到池中选定的后端。这要求OpenLLM精确复现目标API的请求和响应格式,包括流式传输、错误码和重试语义。如果格式不完全兼容,Agent可能出现解析失败或行为异常。
市场反馈与竞争位置
OpenLLM在Product Hunt上获得了76票,排名第13,评论数3条。这个数据说明它引起了一定关注,但还没有形成广泛讨论。在开发者工具类别中,这个热度属于中等偏上,产品可能还处于早期阶段。
从竞争角度看,市面上已有一些做API聚合和路由的工具,但多数聚焦于云端API,对本地模型的支持有限。OpenLLM把本地模型纳入令牌池,算是差异化的一步。不过,它面临的挑战也很明显:不同模型的接口协议、计费方式、上下文长度都不一样,要做到无缝切换并不容易。如果切换过程中出现上下文丢失或响应格式错乱,用户体验会大打折扣。
值得关注的几点
OpenLLM的思路是让AI令牌回归用户控制,而不是被锁在某个平台里。对于需要同时管理多个模型来源的开发者,这种工具能减少切换成本,也能在额度紧张时提供备选路径。
但它的实际价值取决于细节:切换是否真正无缝、远程会话的稳定性如何、本地模型和云端模型的输出质量差异是否可接受。这些都需要在真实工作流中验证。目前Product Hunt页面提供的信息有限,建议有兴趣的开发者先从小范围试用开始,观察它在自己常用工具链中的表现。
背景补充
API网关(API Gateway) 是位于客户端和后端服务之间的中间层,负责请求路由、认证、限流和协议转换。OpenLLM的令牌路由思路与API网关高度相似,但传统网关主要面向微服务架构中的内部服务调用,而OpenLLM面向的是AI模型服务,且需要处理流式响应、长上下文和异构计费模式。另一个相关概念是LLM路由器,如OpenRouter,它聚合多个云端模型的API并提供统一入口,按使用量计费。OpenLLM与OpenRouter的区别在于:前者强调使用用户已有的订阅和本地资源,不额外加价;后者则作为转售商统一计费。此外,OpenLLM支持远程启动会话,这涉及反向隧道或中继服务器技术,即家用机器主动连接公网中继,外部请求经中继转发到内网机器,从而绕过NAT和防火墙限制。延迟和带宽是这类方案的主要瓶颈。
相关推荐
WorkBuddy AI智能体实战:从大模型到Agent的落地差异
通过批量转PDF实战对比,解析WorkBuddy AI智能体与大模型产品的本质差异,涵盖授权执行、积分消耗、场景适配与落地认知,帮你判断Agent工具是否适合当前工作流。
GrokBot之父:月合千个PR,智能体自动合并的工程心法
SpaceX背景AI工程师分享GrokBot工作流:一个月合入约千个PR,智能体自动合并20个。核心方法论围绕验证技能、EVAL测试、Dune架构与硬性CI约束,揭示如何从本地信任走向云端代理自动化。
Bright Data评测:免费额度、AI智能体MCP服务器与定价
Bright Data 提供免费 5000 额度、开源 MCP 服务器及代理/抓取 API。了解其定价模式、AI 助手集成方式和合规注意事项。