OpenReel开源视频创作台:一句话生成短片,ComfyUI交给Agent
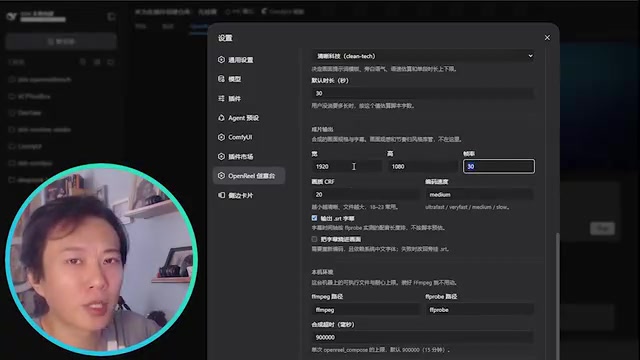
OpenReel用AI Agent接管ComfyUI工作流,实现一句话生成图文解说短片的开源创作台
OpenReel是B站UP主Ayan(欧阳)基于DeepSeek-Harness框架开发的开源视频创意工作台,核心思路是用AI Agent替代人工调度ComfyUI工作流,让创作者专注于内容本身。系统采用双插件分层架构:底层ComfyUI插件管理工作流与Skill预设的导入导出,上层OpenReel创作台负责内容生成与调整。完整管线覆盖立项、脚本、分镜、配音、配图到FFmpeg合成成片的全流程,内置工具调用、审计、创意三层共约12个Skill。声音模块依托TTS Audio Suite集成通义千问等多款TTS引擎,通过预设音色库实现Agent自动设计播报风格。作者的核心理念是让机器负责自动化生产,人专注创意决策,后续计划接入MiniMax H3视频生成、多语言支持及Web Research能力。
从一句话到成片:Agent接管ComfyUI的创作实验
B站UP主Ayan(欧阳)近期发布了一款名为 OpenReel 的开源视频创意工作台,核心思路是把繁杂的 ComfyUI 工作流调度交给 AI Agent,让创作者专注于内容本身。这款工作台构建在 DeepSeek-Harness(DSH)框架之上,目前处于测试版阶段,主要打通了图像生成、声音生成,并在分镜(PPT式画面)层面完成解说类视频的制作。
作者坦言这只是一个「相当于测试版本」的整合成果,还没有完全发挥 ComfyUI 的全部能力,但已经能演示出「一句话出一部片」的完整管线:从创意立项、脚本撰写、分镜规划、配音生成、配图生成,直到最终合成视频。有了分镜之后,转视频「已经是很轻松的一件事」,后续管线开发会加快。
两个插件分工:一个管ComfyUI,一个管创作
作者特别强调了架构上的分层设计。整个系统由两个插件构成,各司其职:
- ComfyUI 插件(此前欧阳开发的那个):负责管理底层工作流,属于「基建」层。这次为配合视频做了小更新,新增了工作流预设的导入导出功能——可以把调整好的工作流连同植入的 Skill(告诉 Agent 如何使用工作流、提示词怎么写)一起批量导出为文件,方便迁移与对接。
- OpenReel 创作台:只负责「生成什么样的内容、如何调整内容」,属于上层创作维度。
两者是分离的两个维度。作者的理念是:ComfyUI 相当于底层设施,工作流可以自由发挥,而创作台专注于让人真正发挥创意,「摆脱 ComfyUI 对我们的枷锁和束缚」。
DeepSeek-Harness(DSH)是一个以大语言模型为核心引擎的Agent编排框架,其设计思想类似于LangChain或AutoGen,但更侧重于将模型能力以"Skill"(技能)的形式模块化封装,再由调度层按需组合调用。框架本身并不绑定特定模型,但与DeepSeek系列模型有较好的协同优化。OpenReel选择在DSH之上构建,意味着所有对ComfyUI的操作指令都经过一个"模型→Skill路由→API调用"的链路,而非用户直接拖拽节点——这既是它的灵活性来源,也是对网络延迟和模型理解能力有所依赖的原因。
版本兼容性:DSH 需1.2以上,避开破坏性更新
值得注意的一个技术细节是版本兼容问题。作者提到 DSH 目前实时更新到 1.25,而在 1.2 版本前后官方做了一次「破坏性更新」,导致协议 API 接口发生变化。1.2 之前的插件在新版 DSH 上无法直接运行,必须让语言模型改协议,或者直接使用高于 1.2 的版本。作者建议用户「不要低于 1.2」,以避免插件冲突。
声音管理是关键:为什么选TTS Audio Suite
工作台对 ComfyUI 的兼容要求中,生图和视频模型「都无所谓」,最主要的是声音,因为声音涉及一个音色库的管理机制。作者选用了 GitHub 上的综合类声音插件 TTS Audio Suite,理由是它支持的模型极为齐全:F5-TTS、Chatterbox、通义千问(Qwen)、Fish、Index、RVC 变声,甚至可以融合音效。
实际使用中不需要全部下载,用到哪个装哪个。作者本次测试用的是通义千问的 TTS,看重它的声音设计功能——可以让 Agent 设计符合节目调性的播报声音。该插件自带一套音色库,创作台正是引用了这个音色库来选音色,而非散落在 ComfyUI 各处的文件夹。如果只需要参考音而不用音色库,走 Index 或 F5 即可,也就不必安装此插件。
TTS Audio Suite所集成的几款主流TTS模型各有侧重:F5-TTS和Index-TTS以中文韵律自然度见长,支持参考音克隆(给一段几秒的参考音频即可复刻音色);Chatterbox是Resemble AI开源的情感TTS,擅长英文表达;通义千问(CosyVoice)系列则提供了多语言+预设音色库+声音设计的组合能力,适合需要对音色进行细粒度风格控制的场景;RVC(Retrieval-based Voice Conversion)严格来说是变声而非TTS,通常用于把已有语音转换成指定人物的音色。OpenReel选择通义千问的核心原因正是其预设音色库与"声音设计"参数(可调节年龄感、情绪基调、语速),使Agent能够根据节目调性自动选配合适的播报风格,而不是每次都让用户手动挑选。
完整管线演示:从乌合之众到成片
作者用一个颇有深度的选题做了完整演示——主题是「当下高认知人群的个体崛起和群体的消散」,借鉴《乌合之众》的社会心理学观点。整个流程分为清晰的阶段:
立项(Brief)
一句话发送后,Agent 先给出项目策划:判断合适时长、片子的整体结构(钩子、段落划分)、风格建议。作者没有硬性指定时长,让 Agent 「根据脚本预判内容」。这一步生成的项目会出现在工作台中,可指定投放平台(横竖屏,如小红书 3:4)和风格(科技风、温暖记录风、扁平风等)。
脚本与分镜
下一步生成脚本,并自动分出段落与分镜。演示中一共分出约 25 段分镜,每段标注语气(陈述句、钩子反转等)和预估时长。作者强调段落与分镜是两个不同概念——一个段落可以拆成两个分镜、对应两张画面。系统还有一套基于规范的审批机制,对时间进行运算评估,因为创作者「对时间往往没有太多概念」。
配音生成
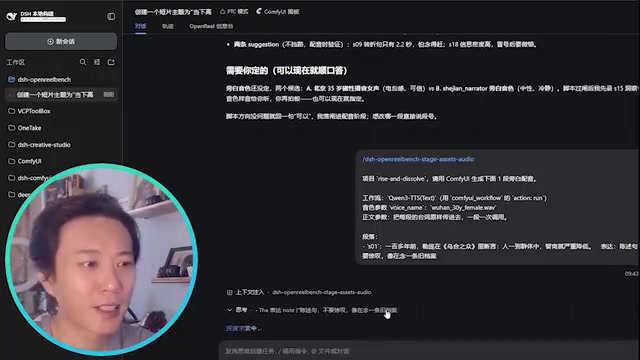
配音环节可从插件音色库选择音色(如作者预设的「30岁女性音色」),也可让 Agent 自动设计符合主题的配音音色。生成支持单条或批量(全部 25 段一次入队),但受并发上限限制(约 10 条),会分批处理。作者还加入了裁剪功能,可框选掉音频前后过长的停顿。
配图与镜头语言
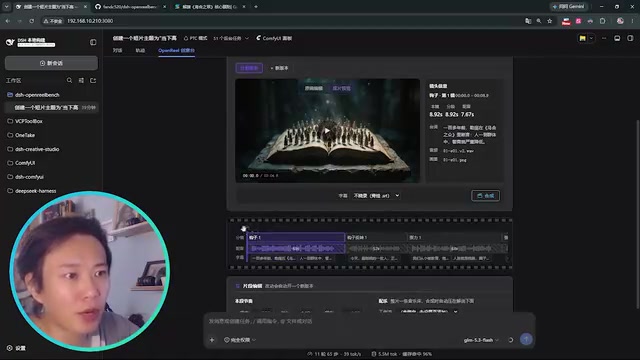
配图阶段选择生图模型后,Agent 会为每个分镜生成镜头语言:景别、焦距、焦段、景深、光线、色温(冷暖调)、运动等参数,再与画面描述合并成最终提示词。作者使用的工作流原生生成 1920×1080,画质无碍但耗时较长,「一个镜头大概两分钟」,20 多个镜头总共约 20 分钟。
成片与精修
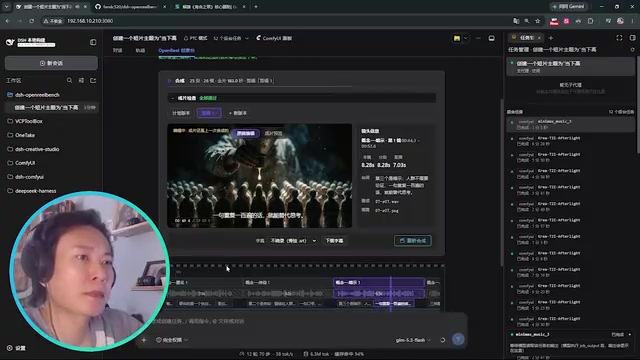
分镜通过后导入成片界面进行预览与剪辑。这里可以修剪片段的「留白」区间调节节奏、编辑字幕(延长/拆分/合并/缩短)、添加配乐(作者接入了 Music 工作流,但坦言配乐效果「还差点意思」),并设置声音回避(有旁白时背景音自动压低)。最终通过 FFmpeg 合成为带字幕的视频。
Skill三层架构与人机协作理念
作者透露,目前仅图文解说这一条管线就植入了约 11-12 个 Skill,底层设计分为三层:
- 工具调用 Skill:如创建项目、把资产放入时间轴、调度内容;
- 审计 Skill:对写稿、镜头感、节奏曲线等质量做评判;
- 创意创作 Skill:负责写稿、镜头语言等实际创作。
一个有意思的细节是,演示中 Agent 曾两次调错工作流——因为对话缺少上下文。但借助 Skill 的错误记录能力,Agent 会自动把错误记录下来(如 TTS 调用参数的问题),下次避免重犯。
作者反复强调其核心理念:机器负责自动化生成概要和内容,人则用「真正属于人的工作台」去调整、检测细节。他坦言这是一个「如何利用开源生态」的实验——比起纠结 1080 还是 4K、几次超分,真正的瓶颈在于「我们应该如何创作」。观众眼里 1080 和 720 差别不大,「调来调去都是为内容服务的,如果没有内容,分辨率再高有什么用」。
Skill在DSH框架中的角色相当于其他Agent系统里的"Tool"或"Action",但它额外携带了上下文描述,告诉模型:这个工具是做什么的、什么情况下调用、参数应该怎么填。三层架构(工具调用→审计→创意创作)本质上是一种职责分离原则:工具层保证操作可执行,审计层保证输出质量达标,创意层保证内容有意义。Agent调错工作流后能自我纠错,依靠的正是审计Skill将错误写入当前对话的上下文记忆,让模型在下一次决策时参考历史失败案例——这是一种轻量级的"反思(Reflection)"机制,无需重新训练模型即可提升任务成功率。
未来路线:视频解说、多语言与更多管线
当前版本停留在图文解说(静态图片分镜)。作者规划的后续方向包括:
- 接入 MiniMax(Hailuo/H3) 直接生成视频片段,做视频解说版;
- 多语言支持,如生成英文片;
- 通过 Web Research / Deep Research 能力,让 Agent 先搜寻话题相关的社会舆论,撰写更全面、更贴合当下的内容;
- GitHub 上预留的类型标签涵盖视频广告、创意广告、短片、数字人、短剧、动画片等待开发管线。
关于生成时间的现实提醒:若用 H3 做视频,普通民用机平均「一秒画面约一分钟生成时长」,180 秒的片子可能要跑两个小时——「够你睡一觉了」。
作者把整个项目命名为 OpenReel,意在强调这是一个开源影视创作台,目标不是教人怎么用 ComfyUI,而是调动 ComfyUI 的开源生态资源去服务创意本身。目前仓库已发布测试版,存在一些小 bug(例如选了 3:4 平台但生成非 3:4 导致的比例问题),作者希望感兴趣的用户尝试并反馈改进思路。
MiniMax的Hailuo/H3是国内目前生成质量较高的视频大模型之一,其H3版本支持最长数十秒的连续镜头生成,在运动一致性和画面细节上有明显提升。作者提到"一秒画面约一分钟生成时长"这一估算,对应的是在消费级GPU(如RTX 4090)本地推理的典型速度;若调用云端API则速度更快但成本更高。将H3接入OpenReel管线后,理论上可以把当前"静态图片+配音"的图文解说模式升级为"真实视频片段+配音",但随之而来的挑战是镜头间的风格一致性控制,以及如何让Agent的提示词精确映射到视频模型的运动参数上,这也是后续开发的主要技术难点。
相关推荐
OpenCode 入门到实战全攻略:AI编程工具安装与配置指南
OpenCode 是一款开源 AI 编程工具。本文梳理其入门到实战全流程:桌面端与 WSL 两种安装方式、模型与规则配置、Agent 分类、自定义命令工具、MCP 服务集成及 SQL 复用,助你系统上手 OpenCode。
10美元AI编程套餐怎么选?Go与Code额度对比拆解
DeepSeek涨价后,10美元AI编程套餐Go和Code怎么选?本文按Mimo、千问、DeepSeek V4、Kimi等常用模型逐一对比两家额度,揭示总额度背后的选购逻辑与请求次数口径陷阱。
多LLM对话真能提升任务表现吗?一个严谨实验设计的启示
一位研究者设计了一套严谨的对照实验,试图隔离多LLM来回对话与单向共享、自我精炼等机制的真实增益。本文解析其实验设计、预算核算与三个开放问题,为多智能体研究提供参考。