Opus 5.5 长文本表现惊艳:Anthropic 用户为何担心模型被"削弱"
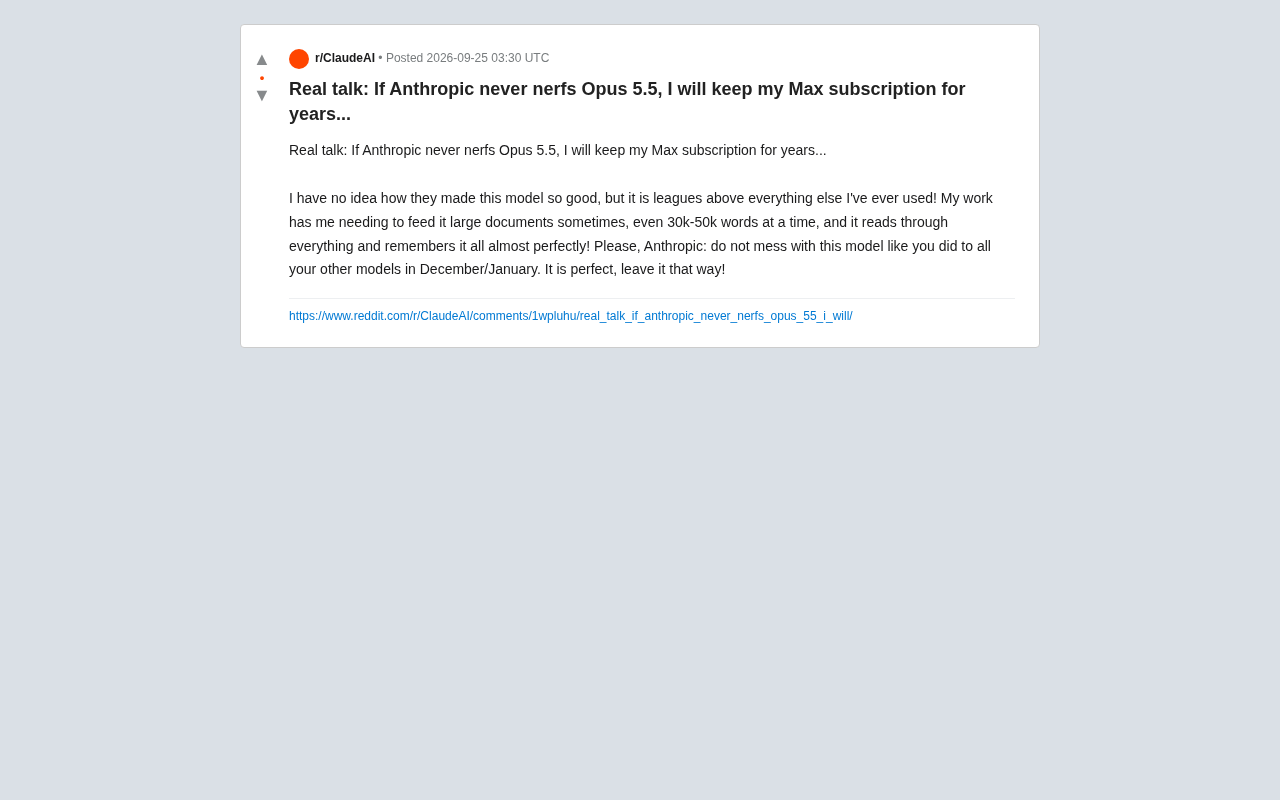
一位重度付费用户盛赞Claude Opus 5.5的超长文档处理能力,并呼吁Anthropic保持模型稳定性,折射出订阅制AI产品的信任隐忧。
一位使用Anthropic Max订阅的重度用户在Reddit发帖,称Claude Opus 5.5在处理3至5万字超长文档时表现卓越,能几乎完美地召回全部细节,并表示若Anthropic不"削弱"该模型,愿意长年续费。文章围绕这一反馈,剖析了长上下文利用质量(而非窗口标称长度)才是衡量模型实用性的真正标准,解释了AI社区中"模型被削弱"担忧的成因,并指出订阅制AI产品存在的结构性矛盾:用户为当下体验付费,却无法锁定未来模型行为。版本固定等机制被提出作为缓解重度用户焦虑的潜在方向。作者同时提醒,该反馈属单一用户主观体验,应理性看待。
一位重度用户的真实反馈
近日一位 Reddit 用户发帖,直言不讳地表达了对 Anthropic 最新模型 Opus 5.5 的赞赏。这位使用 Max 订阅的用户表示,如果 Anthropic 始终不"削弱"(nerf)这款模型,他愿意长年续订。
他的核心工作场景是处理超长文档——有时需要一次性喂给模型 3 万到 5 万字的内容。据他描述,Opus 5.5 能够"通读全部内容并几乎完美地记住所有细节"。这样的长上下文处理能力,在实际工作流中直接决定了模型的可用性,也是他给出"遥遥领先于此前用过的一切"这一评价的关键原因。
长上下文能力为何成为衡量标准
对于需要处理法律文书、研究报告、技术文档的专业用户来说,模型能否稳定地"记住"数万字输入,是决定生产力的核心变量。上下文窗口的标称长度往往容易达到,但真正难的是上下文利用质量——模型是否会在长文本中丢失中段信息(即业界常说的"lost in the middle"问题)。
这位用户强调的"几乎完美记住",正是指模型在超长输入下依然保持了信息召回的一致性。这种体验层面的稳定性,比参数或跑分更能反映一款模型在真实工作中的价值。
"Lost in the middle"是斯坦福大学研究团队在2023年提出并命名的现象:当输入文本超过一定长度时,大语言模型倾向于对位于文本开头和结尾的信息保持较高召回率,而对处于中间段落的信息出现显著的遗忘或忽略。实验表明,随着上下文长度增加,这一问题会愈发明显,导致模型在回答问题时遗漏关键证据或得出错误结论。这也是为什么"支持20万token上下文"和"能真正用好20万token"之间存在巨大差距——前者是工程参数,后者是实际推理质量。针对这一问题,业界陆续探索了位置编码改进(如RoPE缩放)、注意力机制优化以及专门的长文本训练数据等解决路径,但目前尚无一劳永逸的方案。用户在评测长上下文模型时,往往需要专门设计针对中段信息的召回测试,才能真实衡量模型的实际可用性。
用户为何担心模型被"削弱"
帖子中一个值得关注的细节是,这位用户明确请求 Anthropic "不要像去年 12 月/1 月对其他模型那样折腾这个模型"。
所谓 nerf(削弱),在 AI 社区语境中通常指用户感知到模型在某次更新后性能下滑——可能是响应质量下降、拒答变多,或推理能力变弱。这类抱怨在各大模型社区反复出现,背后往往涉及厂商在推理成本、安全对齐、服务负载之间的权衡取舍。
需要说明的是,这属于单一用户的主观感受,并非官方确认的性能变化。用户对模型"变差"的体感,有时源于实际调整,有时也可能来自使用场景的变化或心理预期。但这种普遍存在的担忧,反映出订阅制 AI 产品的一个结构性矛盾:用户为当下的体验付费,却无法锁定未来的模型行为。
模型"削弱"现象在AI社区有其技术背景。大模型在商业部署后,厂商通常会持续对其进行后训练(post-training)调整,包括基于人类反馈的强化学习(RLHF)、安全对齐微调以及针对特定有害输出的过滤增强。这些调整在提升安全性和降低滥用风险的同时,有时会附带影响模型的指令遵循能力、输出风格或特定任务的创造性表现。OpenAI曾在2023年公开承认GPT-4存在"变笨"的用户感知问题,并发布技术报告试图澄清。学界研究也发现,不同时间节点调用同一API端点,模型输出的确存在可统计的差异。这种"静默更新"(silent update)模式——即模型实质改变但不对外标注版本——是用户焦虑的重要来源之一,也推动了部分企业用户向要求明确版本锁定的API调用方式迁移。
订阅稳定性:厂商与用户的信任博弈
这条帖子的深层意义,其实是关于信任。当用户愿意为一款模型"续订多年"时,他购买的不只是当下的能力,更是对未来一致性的预期。
对 Anthropic 这类厂商而言,如何在持续优化成本结构的同时,维持用户可感知的稳定体验,是留住高价值付费用户的关键。任何被解读为"降级"的更新,都可能瞬间瓦解这种信任——哪怕背后有合理的工程理由。
从产品角度看,透明的版本管理、可选的模型固定(version pinning)机制,或许是缓解这类焦虑的方向。让重度用户能够继续使用他们验证过的模型版本,可能比单纯追求指标提升更能提升满意度。
小结
这条来自真实付费用户的反馈,虽然篇幅不长,却精准点出了 Opus 5.5 的强项——超长文档的稳定处理能力,以及 AI 订阅市场的核心痛点——用户对模型一致性的强烈诉求。对于评估是否订阅 Max 计划的用户,长上下文场景是一个值得重点验证的维度。同时也要理性看待社区中关于"模型被削弱"的说法,它更多是一种主观体感的表达,而非可量化的结论。
相关推荐

系统设计面试笔记开源项目:2.4万星的学习利器
开源项目 liquidslr/system-design-notes 整理了经典书籍《System Design Interview》的学习笔记,GitHub 收获 2.4 万 Star。本文解析其内容价值、适用人群及系统设计面试复习建议。
ArtCraft:面向创作者的意图驱动型AI创作引擎
ArtCraft 是一款面向艺术家、设计师和电影制作人的开源「意图驱动型」AI创作引擎,使用 Rust 开发,GitHub Star 数迅速突破 5900。本文解析其产品定位、技术选型与开源策略。
SLOA:无需训练的Transformer模型融合新方法
SLOA是一种免训练的Transformer模型融合方法,通过序列局部算子对齐实现多模型合并。本文解析其核心思路、技术价值与适用场景,帮助理解免训练模型融合技术的发展方向。