OrchSLM:小语言模型协同编排的机制探究
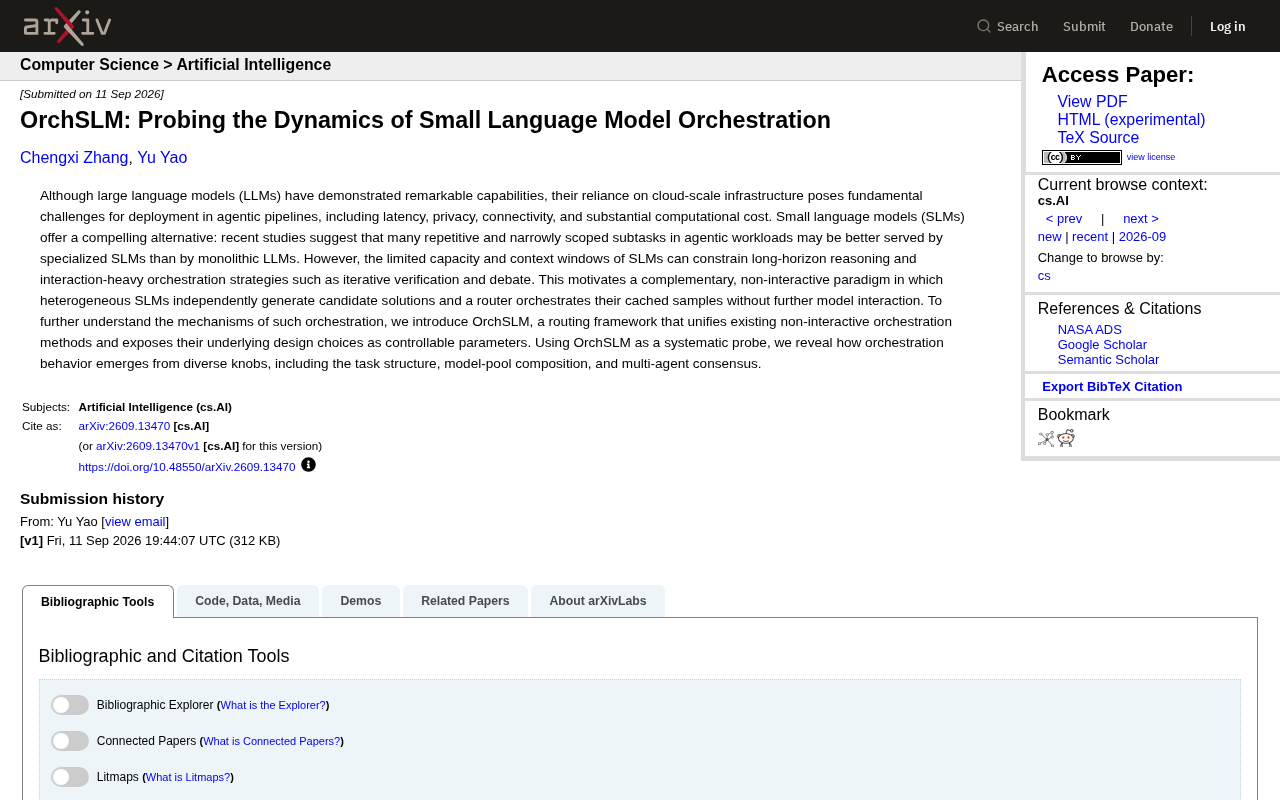
OrchSLM提出非交互式统一框架,系统分析多SLM协同编排的关键设计因素。
这篇论文介绍了 OrchSLM,一个针对小语言模型(SLM)协同编排的分析框架。面对大语言模型在 agentic 系统中存在的延迟高、成本贵、隐私风险大等结构性问题,SLM 是颇具吸引力的替代方案,但其有限的上下文窗口和交互能力又制约了复杂协作策略的落地。OrchSLM 为此提出「非交互式范式」:让多个异构 SLM 各自独立生成候选答案,再由轻量路由器完成编排,彻底绕开长程交互的瓶颈。框架将现有非交互式方法统一到同一坐标系下,并把各方法中隐含的设计选择显式化为可控参数,重点揭示了任务结构、模型池组成、多智能体共识三类因素对编排效果的影响。该工作的核心价值在于提供可量化的分析工具,而非某个具体的最优算法。
为什么小语言模型需要「协同编排」
大语言模型(LLM)在推理、生成等任务上展现出强大能力,但它们对云端大规模基础设施的依赖,在实际部署中带来了一系列结构性难题:延迟高、隐私风险、网络连通性要求、以及可观的算力成本。尤其是在 agentic pipeline(智能体流水线)这类需要频繁调用模型的场景里,这些问题被进一步放大。
小语言模型(SLM)由此成为一个颇具吸引力的替代方案。近期研究指出,agentic 工作负载中大量重复且范围狭窄的子任务,可能由专门化的 SLM 来处理会比使用一个庞大而单一的 LLM 更合适。换句话说,与其用一把「牛刀」处理所有琐碎任务,不如让一组各司其职的小模型分工协作。
不过,SLM 的能力和上下文窗口都相对有限,这直接制约了它们在长链条推理,以及依赖高频交互的编排策略(比如迭代式验证、多模型辩论)上的表现。这一矛盾,正是这项名为 OrchSLM 的研究试图正面回应的问题。
Agentic pipeline(智能体流水线) 是指由多个自主决策步骤串联而成的任务执行系统,通常包含规划、工具调用、自我反思与结果验证等环节。与单次问答不同,这类系统往往需要模型在同一任务中被反复调用数十乃至上百次。若每次调用都需访问远程 LLM API,累积的网络延迟和 token 费用将变得难以接受。以一个需要迭代修改代码的 agent 为例,每轮修改都可能触发多次模型调用,使云端 LLM 的成本呈指数级增长。正是这种「高频调用」特性,让专门化 SLM 的本地部署在 agentic 场景中具备了结构性优势,而非仅仅是「能力差一点但更便宜」的妥协选项。
非交互式编排:另一条技术路线
面对 SLM 交互能力的天花板,研究提出了一种互补性的非交互式范式(non-interactive paradigm)。它的核心思路很清晰:让多个异构的 SLM 各自独立地生成候选解答,然后由一个路由器(router)来编排这些已缓存的样本,整个过程不需要模型之间进一步的交互。
这种设计巧妙地绕开了 SLM 在长程交互上的短板。既然小模型难以支撑迭代验证或辩论这类「你来我往」的复杂协作,那就干脆让它们「各写各的」,把协调工作交给一个轻量的路由层来完成。这不仅降低了对单个模型上下文窗口的要求,也让整个系统的推理开销更加可控。
从工程角度看,这条路线的价值在于把「模型能力」和「编排逻辑」解耦——模型只负责产出候选答案,如何选择、如何融合则由外部机制决定。
与非交互式范式相对的是交互式编排策略,典型代表包括「多模型辩论(multi-model debate)」和「迭代式验证(iterative verification)」。在多模型辩论中,多个模型会相互阅读彼此的输出并多轮修正,逐步收敛到更优答案;迭代式验证则让一个模型生成解答后,交由另一个模型审核,再循环往复。这些方法在 LLM 上已被验证能提升推理质量,但它们要求模型在单次任务中维持长达数轮的对话上下文,对上下文窗口长度和每次调用的计算量要求较高——恰恰是 SLM 的两个主要瓶颈所在。非交互式范式通过将「生成」与「选择」彻底解耦,规避了这一依赖。
OrchSLM 框架:把设计选择变成可控旋钮
为了系统性地理解这类编排机制的运作原理,研究者提出了 OrchSLM —— 一个路由框架。它的定位并不是又一个新的编排方法,而是一个统一的分析工具。
OrchSLM 将现有的多种非交互式编排方法整合到同一套框架下,并把它们背后隐含的设计选择显式地暴露为可控参数(controllable parameters)。这意味着原本散落在不同方法中的「隐性决策」,被转化成了可以逐一调节、对比、测量的「旋钮」。
这种做法在方法论上颇具意义。以往不同的编排策略往往难以直接比较,因为它们在假设和实现细节上各不相同。OrchSLM 通过参数化的统一视角,让研究者得以在同一坐标系里探究不同设计的影响,从而把「编排为什么有效」这个模糊的问题变成可以实证探究的对象。
三类关键因素如何塑造编排行为
借助 OrchSLM 作为系统性的探针(probe),研究揭示了编排行为是如何从多个维度的调节中「涌现」出来的。文中重点提及了三类因素:
任务结构(task structure)
任务本身的性质——是简单的分类,还是需要多步推理,会显著影响哪种编排策略更有效。不同结构的任务,对候选解答的多样性和路由决策的敏感度并不相同。
模型池组成(model-pool composition)
参与编排的 SLM 集合如何搭配,同样是关键变量。是选择能力相近的同质模型,还是刻意引入异构、互补的模型,会带来不同的协同效果。
多智能体共识(multi-agent consensus)
当多个模型独立给出候选答案后,如何在这些答案之间达成「共识」——是简单投票,还是加权融合——直接决定了最终输出的质量。
这三个维度共同构成了编排行为的「参数空间」,而 OrchSLM 的贡献正是让人们能够观察到,编排效果是如何随着这些旋钮的调节而变化的。
多智能体共识机制在技术实现上有多种层次。最简单的是多数投票(majority voting),即直接选择出现频次最高的答案,常见于数学推理任务(如 self-consistency 方法)。更复杂的方案包括基于置信度的加权投票、利用小型验证模型对候选答案打分后选择最高分,以及训练专用的聚合模型来融合多个候选输出。不同共识机制对「候选答案多样性」的依赖程度不同:多数投票依赖足够多的模型给出相同正确答案,而基于验证模型的方案则更倚重验证器本身的可靠性。这也意味着模型池的组成策略与共识机制之间存在交互效应——这正是 OrchSLM 这类统一框架能够帮助研究者系统测量的核心问题。
研究意义与展望
OrchSLM 这项工作的价值,更多体现在分析与理解层面,而非提出某个性能更优的具体方案。在 SLM 逐渐被视为 agentic 系统重要构件的背景下,如何有效编排多个小模型,正成为一个绕不开的工程与研究命题。
它把一个原本依赖经验和直觉的领域,推向了更加可量化、可比较的方向。对于希望在边缘设备、隐私敏感场景或成本受限环境中部署智能体系统的开发者而言,理解「哪些设计旋钮真正影响编排效果」,比盲目堆叠模型更有实际意义。
需要说明的是,作为一篇 arXiv 上新发布的预印本,本文摘要主要交代了动机、框架定位和探究方向,具体的实验结论和量化数据尚需查阅论文全文。但仅从其提出的分析视角来看,它为「小模型协同」这一新兴方向提供了一个值得关注的研究工具。
相关推荐
用LTX+MiniMax H3打造AI科幻短片:ComfyUI克制镜头语言实战
AI科幻短片《REMAINDER》用LTX、MiniMax H3与ComfyUI打造克制的镜头语言,通过扁平化美学解决视觉一致性难题。拆解其多模型协作工作流与创作方法论。
LangChain Deep Agents 与 MDA 有何区别?开发者困惑解析
LangChain 的 Deep Agents 与 MDA(托管深度智能体)到底有何区别?本文从 create_deep_agent 与 define_deep_agent 的差异出发,解析自托管与托管两种智能体部署模式的取舍,帮助开发者理清选择思路。
廉价的OpenAI兼容API:开源大模型云端调用的机会与痛点
一位开发者在Reddit探讨:是否需要一个廉价、兼容OpenAI接口的开源模型API服务,让开发者无需GPU即可调用Qwen、Llama等模型。本文分析该设想的痛点、计费模式取舍与市场挑战。