Pangram:面向文本与图像的AI内容检测工具
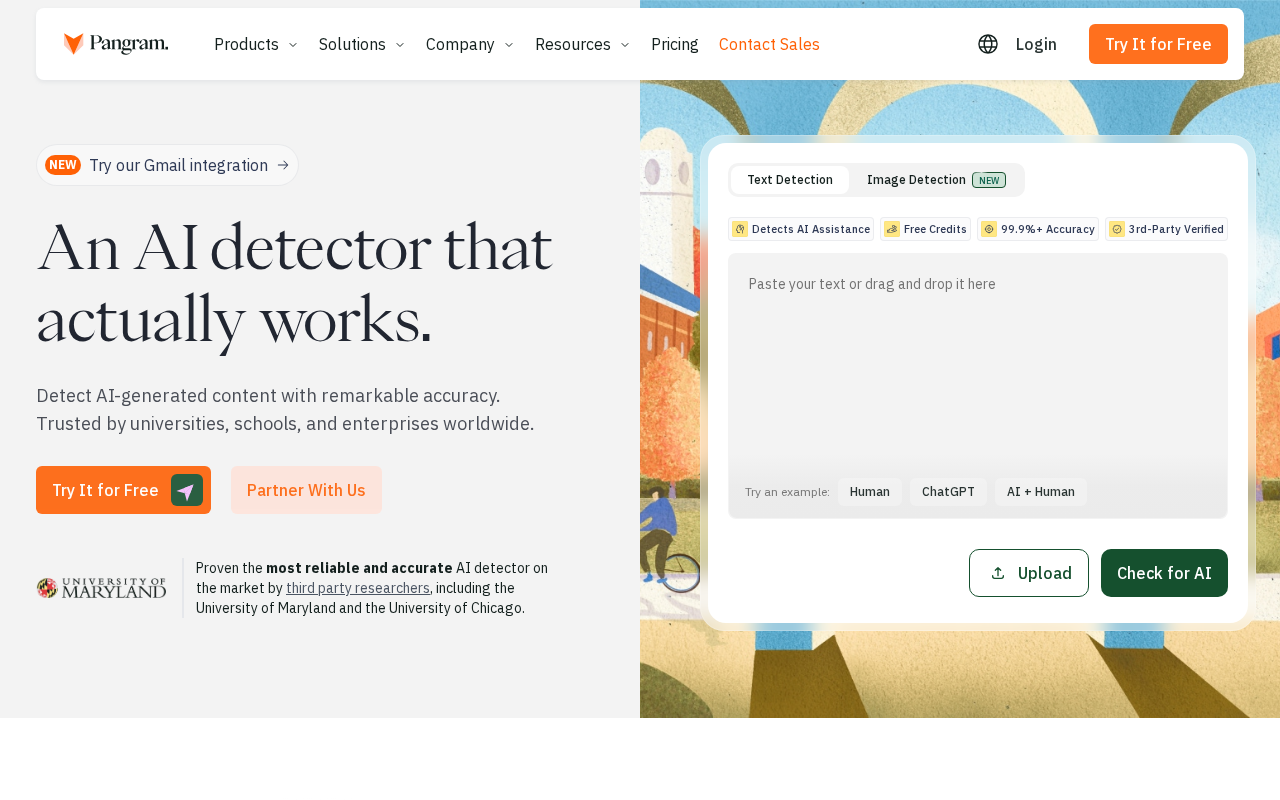
Pangram 是同时支持文本与图像的多模态 AI 内容检测工具,但实际效果有待更多验证。
Pangram 是一款针对 AI 生成内容的检测工具,同时覆盖文本和图像两类场景。文本检测依赖困惑度、突发性等统计特征区分人类与机器写作,应用于学术诚信、内容平台和招聘筛选;图像检测则通过像素伪影、频域特征和模型指纹识别 Midjourney、Stable Diffusion 等模型的合成图片。该赛道已有 GPTZero、Turnitin 等竞争者,核心难题是准确率与误判率的平衡——改写、翻译等后处理会显著降低检测可靠性,新一代生成模型也持续构成"军备竞赛"压力。目前 Pangram 的公开技术细节和第三方评测数据尚不充分,建议将其作为多种手段之一参考使用,而非将检测结果视为绝对证据。
Pangram 是什么
Pangram 是一款定位于 AI 内容检测的工具,主打对文本和图像两类内容的识别能力。随着生成式 AI 的普及,越来越多的文字、图片由大语言模型和图像生成模型批量产出,如何辨别一段内容是人类原创还是 AI 生成,成为教育、出版、招聘、内容审核等场景中的现实痛点。Pangram 正是瞄准这一需求推出的检测服务。
从产品命名看,"Pangram"(全字母句,指包含字母表所有字母的句子)暗示了它对语言结构和内容特征的关注。与市面上仅支持文本检测的工具不同,它同时覆盖图像检测,试图提供一个更全面的 AI 内容识别入口。
AI 检测工具解决的核心问题
文本检测
文本类 AI 检测器的原理通常基于统计特征和模型判别:AI 生成的文本在词汇分布、句式规律、"困惑度"(perplexity)和"突发性"(burstiness)等指标上,往往与人类写作存在可测量的差异。检测器通过训练分类模型,学习区分这两类文本的边界。
这类工具的典型应用包括:
- 学术诚信:判断学生作业、论文是否由 ChatGPT 等工具代写
- 内容平台:识别批量生成的低质量 SEO 垃圾内容
- 招聘筛选:辨别求职材料中的 AI 代笔部分
**困惑度(Perplexity)**衡量的是语言模型对一段文本的"意外程度"——模型越容易预测下一个词,困惑度越低。AI 生成的文本通常选用高概率词汇,困惑度偏低且稳定;人类写作则因个性化表达、情绪起伏而产生更多"意外"词汇,困惑度整体较高且波动较大。**突发性(Burstiness)**则描述句子长度和复杂度的变化幅度:人类写作往往长短句交替、节奏不均匀;AI 生成文本的句式往往更为均质,突发性指标偏低。检测器正是通过捕捉这两类信号(以及词汇分布、语义连贯性等更多特征)来训练分类模型,判断一段文字更可能出自人还是机器。
图像检测
图像检测则面向 Midjourney、Stable Diffusion、DALL·E 等模型生成的合成图片。检测手段可能涉及像素级伪影分析、频域特征、以及模型"指纹"识别。随着深度伪造(deepfake)和合成图像的传播风险上升,图像来源鉴别的需求同样迫切。
频域特征分析是图像检测的重要手段之一。生成模型在上采样、反卷积等操作中会在图像的傅里叶频谱中留下规律性的网格状伪影,这类"频率指纹"在像素层面肉眼难以察觉,但可通过频域变换(如 FFT)检测。此外,GAN 和扩散模型各自有不同的生成机制,会在面部边缘、头发纹理、背景虚化等区域产生特定的统计规律,形成可被分类模型学习的"模型指纹"。深度伪造(Deepfake)特指将真实人脸替换或合成到视频/图片中的技术,其社会危害尤为突出,包括虚假新闻、身份冒充和非自愿色情内容传播,这也是图像来源鉴别需求快速增长的直接原因。
值得关注的行业背景
AI 检测赛道近年竞争激烈,已有 GPTZero、Originality.ai、Turnitin 等玩家。这个领域的核心挑战在于准确率与误判的平衡:检测器既要尽可能识别出 AI 内容,又不能把人类原创误判为机器生成——后者在学术和职业场景中可能造成严重后果。
多数研究和实践表明,当前所有 AI 文本检测工具都难以做到高可靠性,尤其是在文本经过改写、翻译或人工润色之后,检测准确率会明显下降。图像检测同样面临生成模型快速迭代带来的"军备竞赛"问题——新一代生成模型往往能绕过针对旧模型训练的检测器。
Pangram 同时布局文本和图像双检测,若能在准确率上建立差异化优势,将是其在拥挤市场中立足的关键。
使用这类工具需要注意什么
对于打算采用 AI 检测工具的用户,有几点务实的建议:
- 不要把检测结果当作绝对证据:任何检测器都存在误报和漏报,结果应作为参考而非定论
- 关注误判率指标:尤其在教育等高风险场景,误判成本远高于漏判
- 理解工具的局限:经过深度改写的内容、非英语文本、短文本的检测可靠性通常更低
小结
Pangram 代表了 AI 检测工具向多模态方向演进的一个方向,同时覆盖文本与图像检测的产品设计具有实用价值。不过,该工具目前在 Hacker News 上的讨论热度有限(7 个赞、0 条评论),公开的技术细节和第三方评测数据尚不充分,其实际检测效果仍有待更多用户实测验证。对于有内容鉴别需求的团队,可将其纳入候选评估名单,但建议结合多种手段综合判断。
相关推荐
EvolveTrade:让LLM交易智能体自我进化的策略优化框架
EvolveTrade 是一种自我进化的 LLM 交易智能体框架,将系统提示词视为可优化策略,通过决策轨迹与真实收益反馈持续迭代,在多个市场环境下提升夏普比率与累计收益。
GraphEcho:揭示LLM图智能体的证据冗余陷阱
arXiv新研究GraphEcho提出基准测试,揭示LLM图智能体会把重复路径误当额外证据佐证的结构性缺陷,并评估来源感知后训练PAPT的效果与局限,探讨高效探索与有效用证之间的鸿沟。
证据遮蔽如何提升AI组合泛化:60系统预注册实验揭秘
一项arXiv预注册研究通过60个四细胞系统实验证实:限制模块读取信息的「证据遮蔽」能显著提升AI组合泛化能力,两步与三步复合任务准确率提升中位数达0.846与0.859,但其内在机制仍待探索。