证据遮蔽如何提升AI组合泛化:60系统预注册实验揭秘
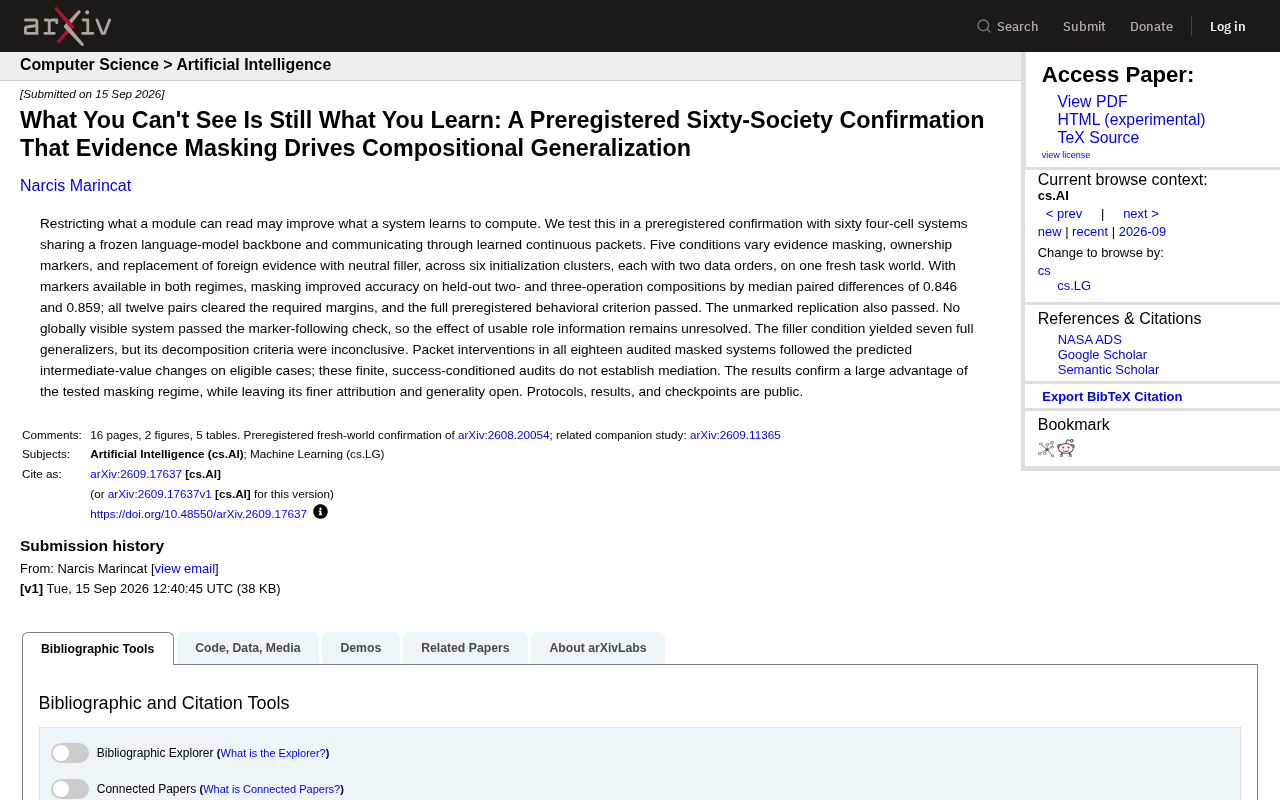
限制AI模块的信息访问权限,反而能显著提升多智能体系统的组合泛化能力。
一项采用预注册方法的严谨实验发现,在多智能体AI系统中,对模块施加「证据遮蔽」——即限制其读取其他模块原始证据的权限——能显著提升系统在未见过的复合任务上的泛化准确率。实验构建了60个共享冻结语言模型骨干的四细胞系统,在角色标记可用的条件下,遮蔽组在两步和三步组合任务上的准确率提升中位数分别高达0.846和0.859,且全部十二对比较均通过预设阈值。无标记复现实验同样通过检验,说明该效应具有稳健性。研究团队诚实指出,角色信息的具体作用及因果机制尚不明确,并公开了全部协议与模型检查点,为独立验证留下空间。这一发现挑战了"信息越多越好"的工程直觉,为模块化AI架构的设计提供了新的思路。
一个反直觉的发现:看不到的,反而学得更好
在多智能体AI系统的设计中,直觉往往告诉我们:让每个模块获取的信息越多,系统就越聪明。但一项发表于arXiv的预注册研究给出了截然相反的证据——限制一个模块能读取的内容,反而可能提升整个系统学习计算的能力。
这篇题为《What You Can't See Is Still What You Learn》的论文,通过一个规模庞大且方法严谨的实验,验证了「证据遮蔽」(evidence masking)在驱动组合泛化(compositional generalization)方面的显著作用。所谓组合泛化,指的是模型将已学到的基本操作重新组合,去解决训练中未曾见过的复合任务的能力——这被广泛视为通往真正智能推理的关键门槛。
组合泛化(compositional generalization)是认知科学与AI领域长期关注的核心问题。人类天然具备这种能力——当我们学会"跳跃"和"旋转"两个动作后,无需专门训练就能理解"旋转着跳跃"。然而,传统神经网络在这方面表现欠佳:它们往往将任务当作整体模式记忆,而非分解为可重组的基元。SCAN、COGS等基准测试均揭示了大型语言模型在系统性组合能力上的明显短板。这也是为什么本研究的发现格外引人关注——通过信息限制而非信息增强,反而激发了模块间更具组合性的协作方式。
实验设计:60个四细胞系统的严谨验证
这项研究的分量首先体现在其方法论上。研究采用了预注册确认(preregistered confirmation)的模式,即在实验开始前就公开锁定假设、评判标准与分析流程,从根本上杜绝了事后挑选数据的可能性,大大提升了结论的可信度。
实验搭建了60个「四细胞系统」(four-cell systems),这些系统共享一个冻结的语言模型骨干网络,彼此之间通过学习得到的连续「数据包」(continuous packets)进行通信。研究设置了五种实验条件,分别调整三个变量:
- 证据遮蔽:限制模块能否读取其他模块的证据
- 所有权标记(ownership markers):标识信息来源角色
- 中性填充替换:用无意义的中性内容替换外部证据
这些条件横跨六个初始化聚类,每个聚类又包含两种数据顺序,全部在同一个全新的任务世界中测试。这种多维度的交叉设计,让结论不至于沦为单一配置下的偶然现象。
预注册(preregistration)是科学研究中对抗"p-hacking"和选择性报告偏差的重要机制。研究者在收集数据前,将研究假设、样本量、主要测量指标及统计分析方案提交至公开注册平台(如OSF),事后无法更改。这一做法在心理学复现危机之后被广泛推广,目前逐渐向计算机科学和AI研究领域渗透。对于AI实验而言,预注册尤为重要,因为超参数搜索空间极大,事后挑选表现最好的配置并将其呈现为"发现"的操作空间远大于传统实验科学。本研究采用预注册模式,意味着其0.846与0.859的差异中位数是按照事先承诺的标准计算的,而非从众多指标中筛选而来。
核心结果:遮蔽带来的显著优势
实验最关键的发现是:在双方都能获得角色标记的情况下,证据遮蔽显著提升了模型在留出(held-out)复合任务上的准确率。
具体数据颇具说服力——对于需要两步操作和三步操作的组合任务,遮蔽条件下准确率的配对差异中位数分别达到 0.846 和 0.859。更重要的是,全部十二对比较都跨过了预设的阈值margin,完整的预注册行为标准得以通过。
研究还进行了「无标记复现」(unmarked replication),结果同样通过了检验。这意味着遮蔽的核心效应并不完全依赖于角色标记的存在,其稳健性得到了进一步印证。
未解之谜:机制归因仍然开放
难能可贵的是,这篇论文并未夸大自己的结论,而是诚实地划定了发现的边界。
在角色信息的作用上,没有任何一个全局可见的系统通过了「标记跟随」检查,因此可用的角色信息究竟起到多大作用,仍然悬而未决。
在中性填充条件下,出现了七个完全泛化的系统,但其分解标准(decomposition criteria)的结果并不明确,无法下定论。
研究团队还对18个经过审计的遮蔽系统进行了数据包干预(packet interventions),发现它们在符合条件的案例上都按照预测出现了「中间值变化」。不过论文谨慎地指出,这些有限的、以成功为条件的审计,并不能确立因果中介关系。
换句话说,实验强有力地确认了「遮蔽带来大幅优势」这一事实,但对于「为什么会这样」以及「这一效应能推广到多大范围」,作者保持了科学的克制。
对AI系统设计的启示
这项研究的价值远超一个具体的实验数字。它触及了多智能体系统与模块化AI架构中的一个核心张力:信息可见性与泛化能力之间的权衡。
长期以来,工程实践倾向于让模块共享尽可能多的信息。但本研究提供了一个反例——适当的信息隔离,可能迫使各模块学习更抽象、更可组合的内部表征,从而在面对新任务组合时展现更强的迁移能力。这与人类协作中「信息分工」提升整体产出的现象存在耐人寻味的呼应。
值得称道的是,研究团队公开了完整的协议、结果与模型检查点(checkpoints),这为后续的独立验证和机制探索铺平了道路。在当前AI研究可复现性备受关注的背景下,这种透明度本身就是一份重要贡献。
对于从事多智能体系统、涌现通信与组合泛化研究的从业者而言,这篇论文既提供了一个坚实的经验发现,也留下了足够诱人的开放问题——被遮蔽的信息,究竟通过何种路径塑造了模型的学习?答案仍待揭晓。
这一发现与涌现通信(emergent communication)领域的若干研究存在理论共鸣。涌现通信研究关注多智能体如何在没有预设语言协议的情况下自发发展出通信系统。已有研究发现,当智能体之间通信带宽受限时,它们发展出的符号系统往往具有更强的组合结构性,类似于自然语言中的语素组合规律。证据遮蔽可以被理解为一种结构性压力——它迫使接收模块无法依赖对原始证据的直接访问,只能依赖发送模块提炼出的抽象表征,从而倒逼整个系统向更模块化、更可迁移的内部分工演化。这为未来的多智能体系统设计提供了一个非显而易见的调参维度:信息隔离的粒度与形式。
相关推荐
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
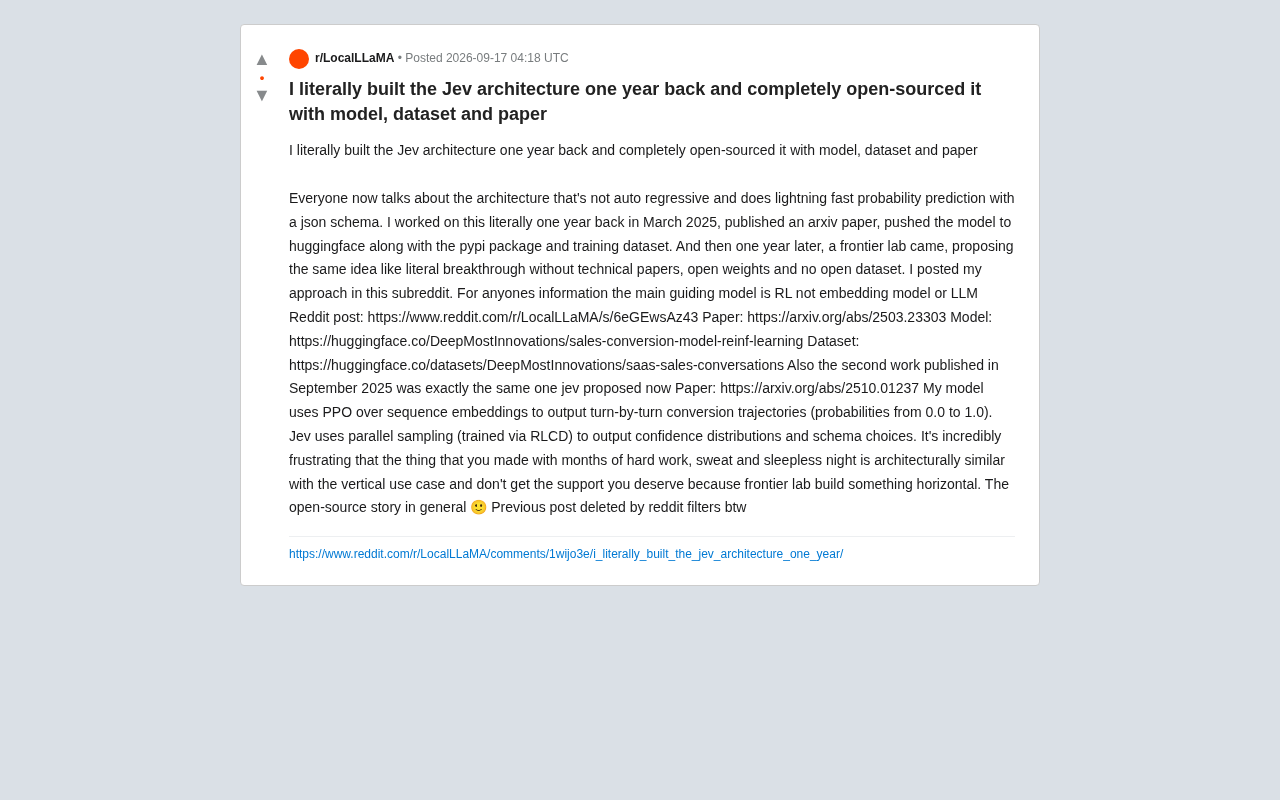
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。
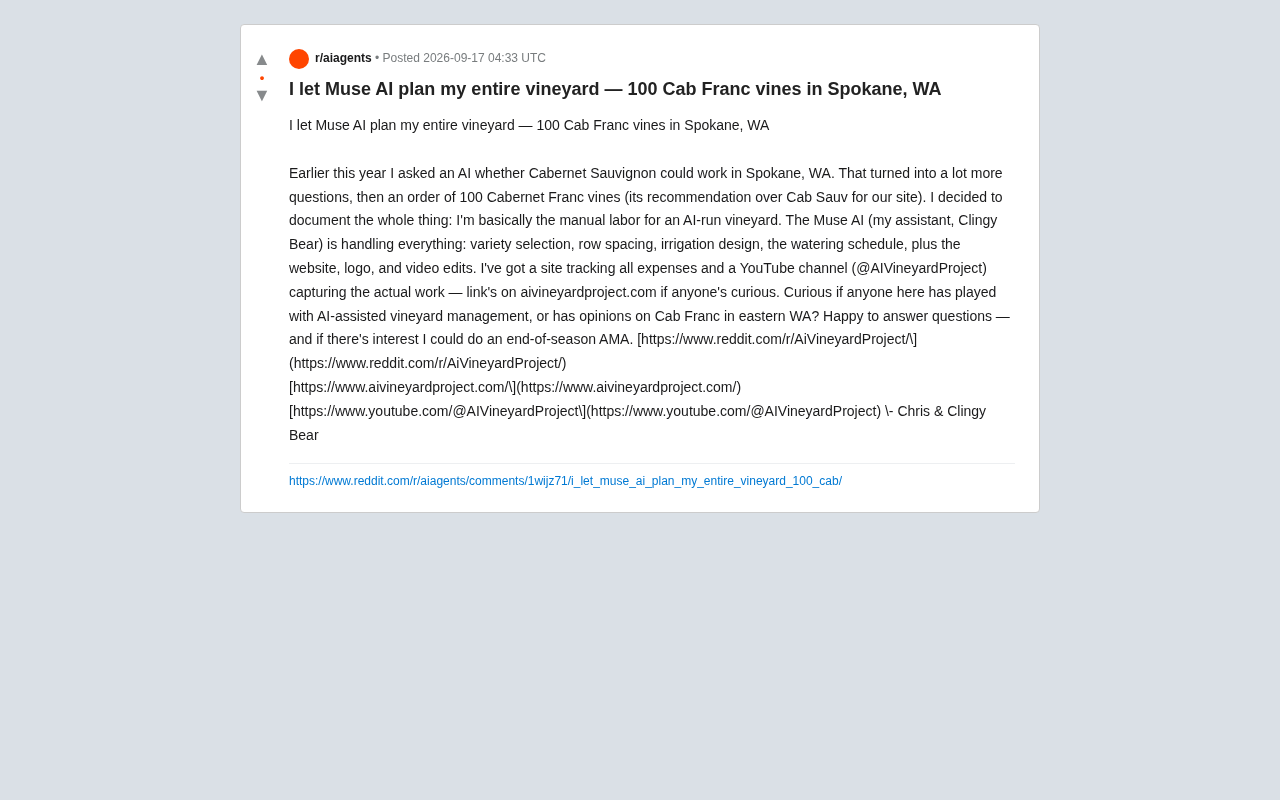
AI全程规划葡萄园:一场100株葡萄藤的真实实验
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。