彭博社解读:中国AI逼近美国,低价与开源却成变现难题
中国AI以低成本与开源快速追平美国,却深陷价格战与变现困局。
彭博社专题报道指出,中国AI产业正以字节跳动、阿里、DeepSeek等巨头与新锐并行的格局,在能力上快速逼近美国前沿模型,同时凭借廉价电力、低成本工程人才和开放权重模型的开源路线,在价格维度上形成显著优势。截至2026年,中美模型的能力差距已大幅缩小,"够用且便宜"的中国模型对全球用户颇具吸引力。然而,这套打法的另一面是一场愈演愈烈的逐底竞争——各厂商持续压价,叠加中国消费者付费意愿低迷,使得整个行业陷入技术高歌猛进、商业难以造血的核心矛盾。报道最终将问题抛给了更深处:技术差距消弭之后,谁能率先解开变现这道题,才是下一阶段竞赛的真正胜负手。
彭博社(Bloomberg Originals)近期发布了一期专题,聚焦中国AI产业的崛起。核心结论颇具张力:全球最强的AI模型或许仍来自美国,但过去一年里,中国竞争者正以更低的成本、逼近的能力抢占全球注意力。另一边,激烈的价格战和开源路线,也让整个行业陷入了一个尴尬的困境——技术越来越强,钱却越来越难赚。
中国AI阵营:巨头与新锐同台竞技
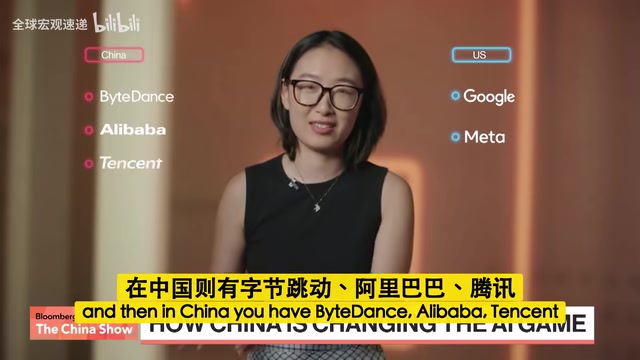
彭博社指出,中国的AI生态极为活跃。几乎任何一家你能叫得出名字的中国科技巨头,都拥有自己的AI模型或正在训练中的模型。报道将中美两国的格局做了直接对照:美国有Google、Meta等巨头,中国则对应ByteDance(字节跳动)、Alibaba(阿里巴巴)、Tencent(腾讯);美国有OpenAI、Anthropic这样的明星初创公司,中国则涌现出Moonshot(月之暗面)、DeepSeek、Zhipu(智谱)、Minimax等一批新锐。
报道评价这些中国公司「真正拿出了突破性创新」,并且在市场打法上极为激进。这种密集的参与者数量,本身就构成了中国AI产业的一个鲜明特征:不是少数几家寡头的赛跑,而是一场巨头与创业公司交织的全面混战。
成本,成了这场竞赛的关键变量
彭博社认为,成本已经成为AI竞赛中极其重要的因素,而在这一维度上,中国的产品「眼下要有吸引力得多」。报道引用了一句颇为传神的话:「你并不需要一个『上帝』来帮你写邮件。」
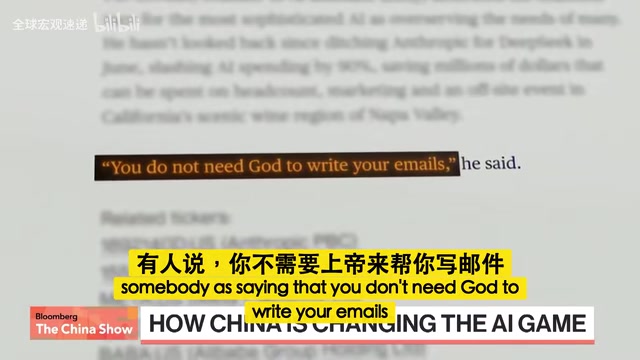
这句话点破了当下AI应用的现实逻辑——对绝大多数日常任务而言,用户真正需要的是「够用且便宜」,而非「最顶尖但昂贵」。因此,这场竞赛归根结底是成本与能力之间的平衡。中国模型恰恰在这个平衡点上占据了优势:能力足够接近前沿,价格却低出一大截。
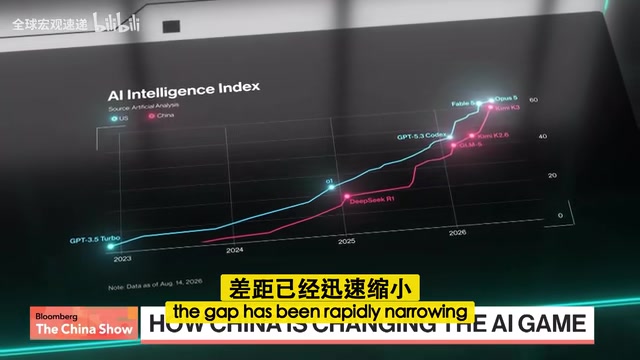
从时间线看,ChatGPT在2022年底发布后,美国前沿模型的性能持续攀升,中国模型曾落后数年。但报道明确指出,截至2026年,这一差距正在快速缩小。能力追平叠加价格优势,正是中国AI「抢眼球」的底层原因。
便宜从何而来:电价、人才与开源
为什么中国能把AI做得又快又便宜?彭博社给出了几层解释。
表层的原因是资源成本:中国的电力更便宜,训练AI所需的算力能耗支出因此更低;同时中国拥有充沛的工程人才,而其薪酬仅为美国顶尖工程师的一小部分。廉价的能源和人才无疑是助推器。
但报道强调,真正的关键在别处——开放权重模型(Open Weight Models)。
开源路线的价值在于,它让大量不同的研究者能够同时审视同一项技术。这种「众目之下」的协作模式,被认为是中国有机会追平差距的重要原因。当模型权重公开,全球开发者都能在其基础上迭代、优化、发现问题,事实上形成了一种分布式的研发加速器。这也解释了为何中国的开源模型近年在全球开发者社区中影响力持续上升。
**开放权重模型(Open Weight Models)**是指将模型训练完成后的参数(即"权重")向公众开放下载的模型形式。与完全闭源的API服务(如ChatGPT)不同,开放权重意味着任何人都可以在本地运行、修改和基于该模型进行二次开发。Meta的LLaMA系列、DeepSeek系列均属于这一类别。需要注意的是,"开放权重"并不等同于完全意义上的"开源(Open Source)"——后者通常还要求公开训练数据、训练代码等完整技术栈,而前者仅开放模型权重文件本身。尽管如此,开放权重已足以让全球开发者对模型进行微调、评估和改进,从而形成报道中所说的"分布式研发加速器"效应。正是这一路线,让资源相对有限的团队得以站在巨人肩膀上快速迭代,而无需从头承担动辄数亿美元的预训练成本。
硬币的另一面:没人真正搞懂怎么赚钱
开源和低价带来了追赶速度,却也埋下了一个尚未解决的难题:变现。彭博社直言,「没有人真正搞清楚该怎么赚钱」。
报道用「逐底竞争(race to the bottom)」来形容过去一年多的市场状态——各家公司在价格上互相压低,形成恶性循环。更棘手的是需求侧的现实:中国消费者并不太愿意为AI服务付费。供给端拼命降价,需求端付费意愿低迷,两者叠加,让商业化前景变得相当艰难。
这构成了中国AI故事的核心矛盾:技术层面高歌猛进,商业层面却难以自我造血。开源可以帮助赢得口碑和生态,价格战可以帮助抢占市场份额,但当整个行业都陷入价格与免费的漩涡时,如何建立可持续的盈利模式,成了悬在头顶的问题。
「逐底竞争(Race to the Bottom)」这一概念源自经济学,描述市场参与者为争夺份额而持续压低价格或标准,最终所有参与者集体受损的动态。在AI行业,这一现象在2024年的中国市场表现得尤为显著:各大厂商相继将API调用价格压至接近成本线甚至低于成本,部分服务甚至直接免费开放。这种打法的短期逻辑是以亏损换用户规模和数据积累,寄希望于未来通过生态绑定或增值服务实现盈利。然而,当竞争对手同步跟进时,所有人都在烧钱却无人能建立真正的护城河。与此同时,中国消费者在数字服务付费上本就存在"免费惯性",进一步压缩了直接向C端收费的空间,使得整个行业的商业化路径至今尚不明朗。
结语:追赶之后是更难的一课
彭博社这期报道勾勒出的图景相当清晰:中国AI在能力上正快速逼近美国,在成本上已具备明显吸引力,开源生态更是其加速追赶的独特武器。但这套打法的代价,是一场看不到尽头的价格战和悬而未决的变现困局。
对于观察全球AI格局的人来说,这提出了一个更深层的问题——当技术差距不再是主要瓶颈,谁能率先解决「赚钱」这道题,或许才决定了下一阶段竞赛的真正胜负手。
相关推荐
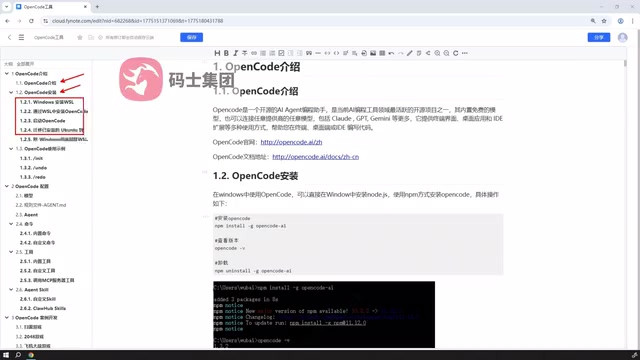
OpenCode 入门到实战全攻略:AI编程工具安装与配置指南
OpenCode 是一款开源 AI 编程工具。本文梳理其入门到实战全流程:桌面端与 WSL 两种安装方式、模型与规则配置、Agent 分类、自定义命令工具、MCP 服务集成及 SQL 复用,助你系统上手 OpenCode。
10美元AI编程套餐怎么选?Go与Code额度对比拆解
DeepSeek涨价后,10美元AI编程套餐Go和Code怎么选?本文按Mimo、千问、DeepSeek V4、Kimi等常用模型逐一对比两家额度,揭示总额度背后的选购逻辑与请求次数口径陷阱。
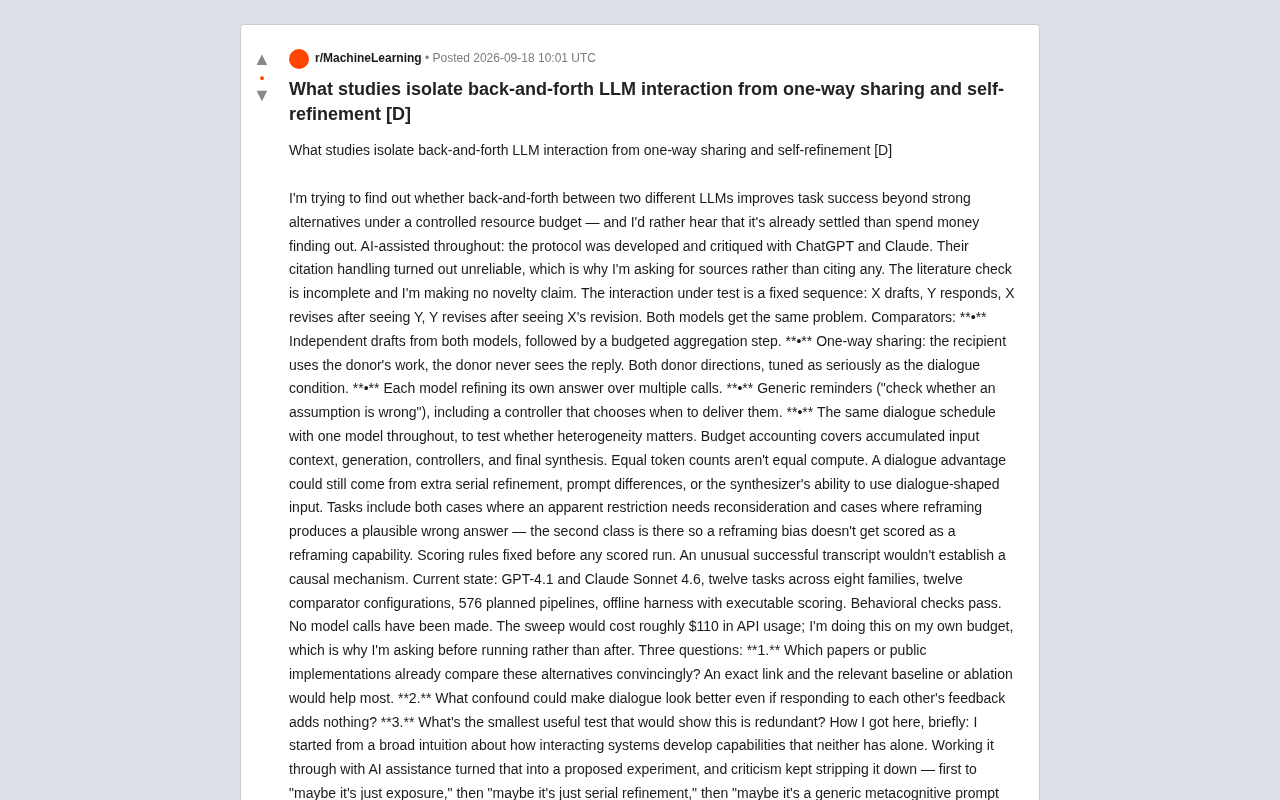
多LLM对话真能提升任务表现吗?一个严谨实验设计的启示
一位研究者设计了一套严谨的对照实验,试图隔离多LLM来回对话与单向共享、自我精炼等机制的真实增益。本文解析其实验设计、预算核算与三个开放问题,为多智能体研究提供参考。