Perplexity自研CobbleDB:2名工程师+数百AI智能体2个月造就搜索基础设施

Perplexity披露用2名工程师加数百AI智能体、两个月内构建自研键值数据库CobbleDB的技术成果。
Perplexity近期公布了其自研键值数据库CobbleDB的技术研究,该数据库负责为其AI搜索产品提供网页内容的存储与检索服务。最受行业关注的不是产品本身,而是其开发模式:仅由两名工程师搭配数百个主动常驻的AI智能体,在两个月内完成核心基础设施建设。这一案例被视为AI智能体从编程辅助工具走向研发主力的潜在转变信号——少量资深工程师负责架构决策,大规模AI智能体承担实现与迭代工作。文章同时提示,目前信息主要来自官方宣传,AI贡献占比与效率数字仍待完整技术报告验证,应理性看待其中的营销叙事成分。
Perplexity公布CobbleDB技术细节
Perplexity近期宣布发布关于其自研键值数据库 CobbleDB 的技术研究成果。这套数据库承担着为Perplexity搜索提供网页内容存储与检索的核心职责,是支撑其AI搜索产品的关键底层设施。
据Perplexity官方披露,CobbleDB的核心基础设施仅由 两名工程师 加上 数百个主动、常驻的AI智能体(AI agents) 组成的团队,在 两个月 内构建完成。这一开发模式本身,比数据库产品本身更值得科技行业关注。
为什么搜索引擎需要自研键值数据库
键值数据库(Key-Value Database)是一种以"键-值"对形式存储数据的NoSQL数据库,因其读写高效、水平扩展能力强,被广泛用于需要高吞吐、低延迟的场景。
对于Perplexity这类AI搜索产品而言,系统需要抓取、存储并快速检索海量网页内容。通用数据库方案往往难以在成本、延迟和规模三者间取得理想平衡。自研CobbleDB意味着Perplexity可以针对搜索内容服务的具体访问模式做深度优化——例如面向网页文档的读密集型负载、大规模并行检索等,从而在关键路径上获得更好的性能与成本控制。
对搜索类产品来说,内容服务层的效率直接影响响应速度与运营成本,掌握底层数据库的自主权具有战略意义。
在搜索引擎领域,键值数据库通常用于存储网页的原始内容、索引元数据或爬取快照。主流的开源选项包括RocksDB(Facebook开发,基于LSM树结构,写入吞吐极高)和LevelDB(Google开发),许多大型系统会在其上构建自己的封装层。Perplexity选择从头自研而非沿用这些成熟方案,可能意味着其访问模式或部署约束存在较特殊的需求——例如针对AI检索管线的向量邻近查询优化、特定的压缩策略,或是对云原生存算分离架构的深度适配。自研的代价是需要独立承担正确性验证、故障恢复和长期维护,这也是为何此前只有Google、Meta等极少数公司会走这条路。
"2人+数百AI智能体"开发模式的意义
这条消息中最具讨论价值的,是其披露的开发方式:两名工程师主导,配合数百个"always-on"的AI智能体协同完成核心基础设施建设。
AI智能体从辅助走向主力
过去一年,AI编程工具主要扮演"结对编程助手"的角色,帮助开发者补全代码、生成片段。而Perplexity所描述的场景更进一步——AI智能体不再只是被动响应,而是"proactive、always-on"(主动且常驻),成为工程团队中可编排的生产力单元。
如果这一说法属实,它代表了软件工程组织形态的一种潜在转变:少量资深工程师负责架构决策与方向把控,大量AI智能体承担实现、测试、迭代等繁重工作。数据库这类对正确性、并发安全要求极高的系统级软件,历来被视为AI较难胜任的领域,Perplexity的案例因而更具信号意义。
目前业界对"AI智能体"的定义尚不统一,但在软件工程场景中通常指能够自主规划子任务、调用工具(如代码执行、文件读写、测试运行)并根据结果迭代的自动化系统,代表性框架包括Devin、SWE-agent以及各类基于大模型的多智能体编排系统。与传统代码补全工具(如GitHub Copilot)的最大区别在于,智能体可以跨越单次提示的边界,持续执行多步骤任务。"数百个常驻智能体"的描述暗示Perplexity可能使用了大规模并行的智能体集群——每个智能体处理独立的子任务(如编写单元测试、实现特定模块、修复lint错误),由少数工程师在顶层进行任务分配与结果审核。这种模式下,工程师的核心价值从"写代码"转向"定义正确性标准与验收条件"。
需要审慎看待的部分
值得提醒的是,目前信息主要来自Perplexity官方的宣传性推文,缺乏第三方对开发过程、代码质量与AI贡献占比的独立验证。"两个月"完成的具体是哪一部分"核心基础设施"、AI智能体在其中承担了多少实际决策,都还有待完整技术研究报告披露后进一步评估。作为营销叙事的一部分,其中的效率数字应结合官方公开的研究细节理性看待。
对行业的启示
CobbleDB案例反映出两个趋势的交汇:一是AI公司越来越倾向自建关键基础设施以掌控性能与成本;二是AI智能体正在被引入到自身产品的研发流程中,形成"用AI造AI"的闭环。
对于工程团队而言,这提示出一种值得关注的组织实验方向:通过智能体规模化承担实现层工作,压缩交付周期。但同样重要的是配套的验证、审查与可靠性保障机制——尤其在数据库这类容错空间极小的领域。
Perplexity已表示将发布相关研究,完整的技术文档将是判断这一模式成色的关键。感兴趣的从业者可关注其后续公开的研究成果,从中获取更具体的工程实践细节。
相关推荐
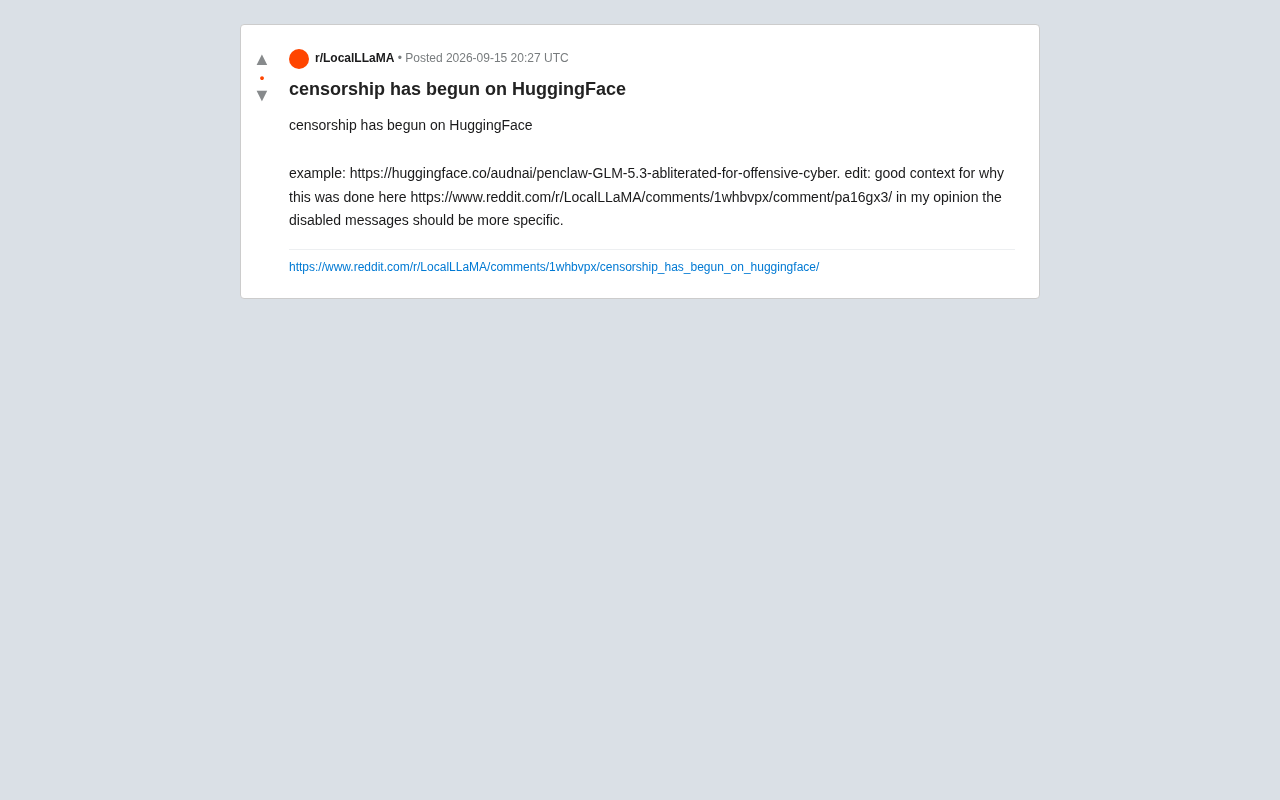
HuggingFace开始内容审查?下架模型引发社区争议
HuggingFace下架一个标注「用于网络攻击」的去审查GLM模型,引发开源社区关于内容审查的争议。本文梳理事件始末,分析abliterated模型的敏感性,以及平台治理透明度这一真正痛点。
Cayu:构建长周期领域智能体的开源Python框架
Cayu 是一个用于构建领域专用、长周期 AI 智能体的开源 Python 框架。它让开发者围绕工具、知识与业务规则组装 harness,并提供集成的持久化运行时处理会话、状态、恢复、审批与可观测性。本文解析其核心思路与落地场景。
社交媒体真的在伤害青少年吗?一场悬而未决的科学争论
社会心理学家乔纳森·海特在《焦虑的一代》中将青少年心理健康下滑归咎于社交媒体,但这一论断在学术界引发分歧。本文探讨相关性与因果关系的争议,以及这场辩论对公共政策的现实意义。