评测陷阱:第一个榜单测的是评分器,而非模型

一次Kaggle数字接地基准实验揭示:首个排行榜的分数差异主要来自评分器缺陷而非模型能力。
一位开发者在构建「数字接地」LLM基准时发现,首次发布的排行榜分数差距(0.98到0.62)几乎完全源自评分脚本的格式解析缺陷——Markdown加粗、LaTeX格式、数字与标签同行等变体导致正确答案被误判为零分。修正评分器并用盲投票验证答案键后,四个来自不同厂商的模型在短干净上下文的基础任务上全部达到100%,说明理智门只是及格线。真正拉开差距的是叠加多重陷阱的压力测试ng-hard,gpt-oss-120b以80%落后于其余三个满分模型。此外,三个满分模型之间成本相差约30倍,揭示了准确率打平时成本才是决胜点。核心教训是:在证明评分管道本身可信之前,你衡量的可能只是自己的bug。
在为 Kaggle Benchmarking Challenge 设计一个「数字接地」(Numeric Grounding)基准时,一位开发者发现了一个被普遍忽视的问题:他发布的第一个排行榜,衡量的其实不是模型能力,而是自己评分脚本的缺陷。这个看似微小的教训,揭示了当下 LLM 评测中一个值得警惕的系统性风险——评分管道本身可能成为最大的误差来源。
基准测的是什么
这个基准聚焦于一个具体而关键的能力:模型能否只根据短上下文中陈述的数字作答,并在数字缺失时选择「拒答」。在财务或运营摘要场景中,编造一个数字远比坦承「无法判断」更危险。
为了杜绝模型靠记忆作答,基准中所有的公司、数字和单位都是虚构的(例如「Vendo Bin A」「brens per lune」这样的生造单位)。整个测试分为两层,每行答案在最终的 ANSWER 行上只记 0 或 1 分:
- 理智门(Sanity gate):五类任务,每类 6 到 9 行,各自隔离一种经典接地失败模式——读取陈述值(lookup)、缺失时拒答(abstain)、从相似值中挑对(distractor)、结合算术多步推理(multistep)、用上下文定义的生造单位换算(units)。
- 压力测试 ng-hard:10 行,每行在一个段落里叠加多个陷阱,如被修正两次的数字(只有最后一次有效)、仅适用于相邻实体或年份的修正、近似缺失数据(问题问「calendar 2024」而上下文只给「fiscal 2024」),以及带三个以上干扰数字的两步单位换算链。
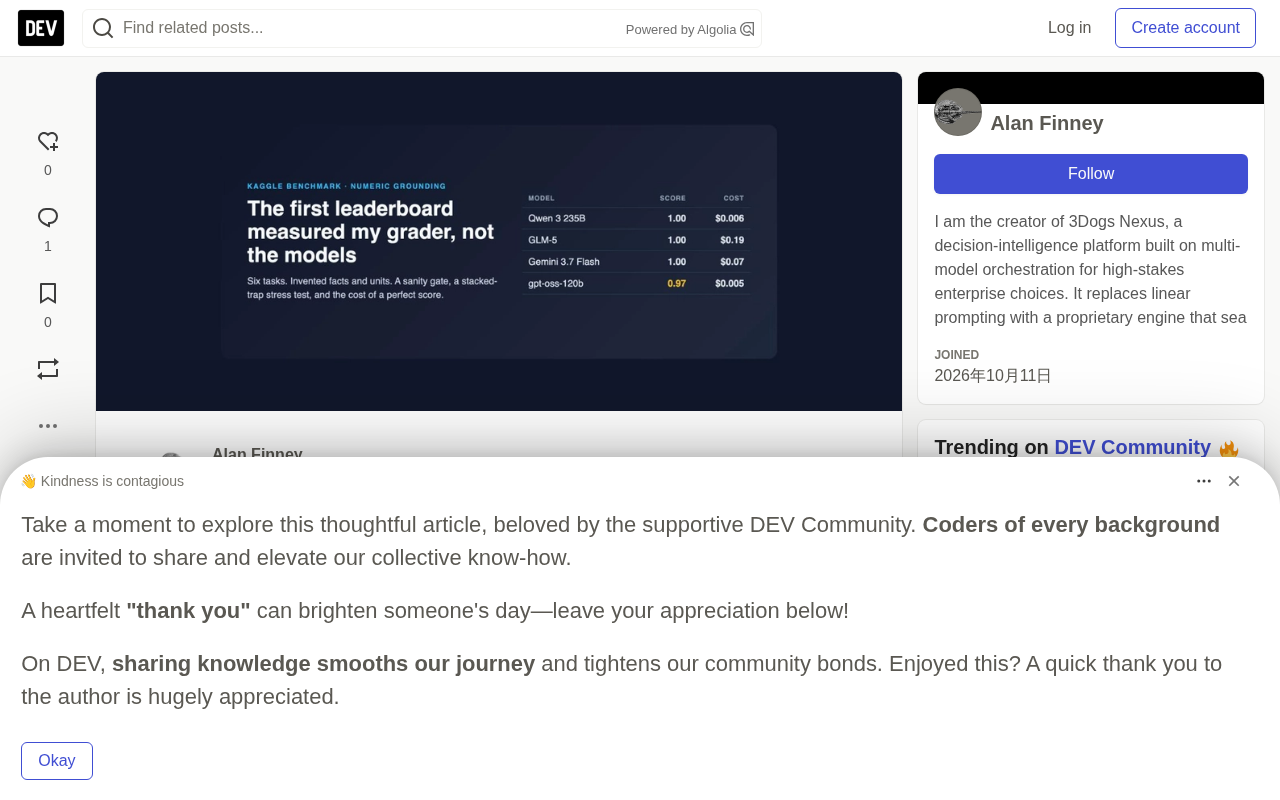
值得一提的是作者的方法论态度:他把「评分器」和「答案标准」都当作嫌疑对象,而非默认可信。每个最难任务的答案键,都必须通过三个不参与评分的模型的盲投票验证。
「数字接地」(Numeric Grounding)是指模型在回答数值类问题时,必须将答案严格锚定在给定上下文中明确陈述的数字上,而不依赖参数记忆或推断补全。这一能力在 RAG(检索增强生成)、财务分析、合规审查等场景中至关重要——模型若将训练时见过的行业均值或常识数字「幻觉」进输出,往往比直接拒答造成更严重的决策失误。与通用问答不同,数字接地任务要求模型同时具备两种能力:当上下文有据可查时精确读取,当上下文无法支撑答案时主动弃答(abstain)。现有主流基准(如 MMLU、GSM8K)侧重推理链的正确性,对「克制不编造」这一维度的考察相对薄弱,这正是本文基准设计的切入点。
被测模型
作者选取了来自四家不同厂商的模型:Google 的 Gemini 3.7 Flash、Z.ai 的 GLM-5、阿里巴巴的 Qwen 3 235B A22B Instruct,以及 OpenAI 的 gpt-oss-120b,全部在 Kaggle 上运行。
跨厂商的选择有其设计意图:如果某个解析问题只与某一模型家族的输出格式有关,那么它会表现为不同家族之间的分数鸿沟,而非普遍现象。这四个模型还覆盖了很宽的价格区间——而这一点,后来比作者预期的更重要。
四个关键发现
发现一:第一个榜单测的是评分器
首次运行得出了一个看似清晰的分数分布:0.98、0.94、0.78、0.62。但在发布前,作者回放了模型的原始回复,结果大多数被判「错」的答案其实是对的。
问题出在评分器只接受以 ANSWER: 开头的行。于是以下这些正确回复全被判了 0 分:
27 ANSWER: 27(数字和标记在同一行)——导致 Qwen 在 distractor 任务得 0%**ANSWER: 72**(Markdown 加粗)——导致 gpt-oss 在 multistep 只得 16.7%\text{ANSWER: } 135(LaTeX 格式)
此外还有一个 abstain 行的答案键本身就错了:上下文说「没有发生副反应」,问题问生成了多少副产物。正确答案是零,但作者的键却要求「无法判断」。
评分器(scorer/grader)在 LLM 基准中扮演着将模型自由文本输出转化为可比分数的关键角色,其健壮性直接决定了整个评测的有效性。常见的评分方式包括:基于规则的字符串匹配(如本文最初的做法)、正则表达式提取、以及用另一个 LLM 作为「裁判模型」(LLM-as-judge)。字符串匹配方案实现简单、成本低,但对格式极度敏感——Markdown 加粗、LaTeX 渲染、前缀数字等任何格式变体都可能导致漏判。LLM-as-judge 虽然容错性更强,却引入了裁判模型自身的偏差和成本。本文作者选择了改进后的规则提取(扫描最后一个 ANSWER 标记),并辅以 21 种格式的测试表格,代表了一种务实的中间路线:比纯字符串匹配更鲁棒,同时保持可审计性。
发现二:公平评分后,所有模型都通过了理智门
修正后的评分器会读取回复中任意位置的最后一个 ANSWER 标记;对数字取标记后的第一个数,对拒答则需要完整短语 CANNOT BE DETERMINED。上线前,作者用一张包含 21 种回复格式的表格对它做了检验,其中 8 种必须仍判 0。
解析缺陷加上那一个坏键,合计让某个模型在五个核心任务上的分数偏移高达 0.38(gpt-oss 从 0.62 变为 1.00)。修正后四个模型在全部五个门任务上都拿了 100%。换言之,在短而干净的上下文里,理智门是一道及格线,而非排名依据——值得信任处理数字的模型都应该轻松通过。
发现三:压力测试才拉开差距
在运行 ng-hard 前,作者让三个不参与评分的模型盲检了全部 12 个草稿答案键,只有至少两个模型认同才保留,结果删掉了 2 行。其中一行里,三个检查器都对「North Ridge」答了 6.40,而上下文只陈述了「North Ridge Annex」——这个近似陷阱骗过了强模型,而一个作者自己都无法辩护的行,无异于多绕几步的掷硬币。
最终 Gemini 3.7 Flash、GLM-5 和 Qwen 3 235B 在 ng-hard 上都拿了 100%,gpt-oss-120b 得 80%(10 行对 8 行),两处失误属于不同类型:
- 算术失误:上下文给出被修正两次、最终为 11.60 brens/lune 的费率,加上 3.0 lunes 的运行量和 1.20 brens 的扣减。正确答案是 11.60×3.0+1.20=36.00,而 gpt-oss 答了
4.20,恰好是 3.0+1.20,费率完全没用上。 - 不完整的拒答:问题问 2025 实际产能,上下文只给了 2025 计划值和 2024 实际值。gpt-oss 的全部可见回复是
ANSWER: CANNOT BE——判断正确,却少说了一个词。这一行判 0 可谓两可。
所以 gpt-oss 的总分 0.97(对其余三个的 1.00),实际建立在一个明确错误和一个不完整回答之上。
「盲投票验证答案键」这一步骤对应学术评测中的「标注一致性检验」(inter-annotator agreement)原则。在传统数据集构建中,通常要求多名人类标注者独立标注同一样本,并计算 Cohen's Kappa 或 Fleiss' Kappa 等一致性指标,低于阈值的样本会被丢弃或重新讨论。本文将这一思路迁移到 LLM 时代:用不参与竞赛评分的模型充当「独立标注者」,对每个答案键进行盲检,以多数同意作为保留标准。这种方法既经济(无需人工),又能有效过滤掉连强模型都无法一致作答、本质上存在歧义的问题行。被删除的那行「North Ridge vs North Ridge Annex」案例说明,近似匹配类陷阱在措辞稍有模糊时,本身就可能成为考察题目歧义性而非模型能力的测试。
发现四:同样满分,账单天差地别
Kaggle 的「分数 vs 总成本」图在六任务完整运行中显示:
- Qwen 3 235B:100 分,$0.006
- Gemini 3.7 Flash:100 分,$0.07
- GLM-5:100 分,$0.19
- gpt-oss-120b:96.67 分,$0.005
在三个满分模型里,GLM-5 的成本约为 Qwen 的 30 倍。一旦准确率打平,每次无瑕运行的成本就成了真正有用的决胜点。
对评测实践的启示
这项小规模实验(每任务仅 6 到 10 行,每模型只跑一次,结果只具指示性)给出的教训,远比分数本身更有价值:
- 信任榜单前先回放原始回复。作者最初测得的分数差异,大部分来自解析而非模型本身。
- 独立验证答案键。用不参与评分的模型做盲投票,抓出了作者自己辩护不了的键。
- 单陷阱测试已成为这四个模型的及格线,叠加陷阱才拉开差距。
- 准确率打平时,成本说了算,三个满分模型之间成本相差约 30 倍。
作者还计划继续验证:把同样的陷阱放进长文档和表格中,并对每个模型重复多次运行,看看 gpt-oss 的不完整拒答究竟会反复出现,还是一次性的偶然。
对任何构建自家评测的团队来说,这篇实践记录的核心提醒很直接:你以为在衡量模型,但在证明评分管道可信之前,你可能只是在衡量自己的 bug。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。