屏幕阅读器读不到的界面,正在训练你的AI助手

论文量化计算机使用代理继承的无障碍标签缺失问题,发现新旧数据集描述覆盖率相差39.5个百分点。
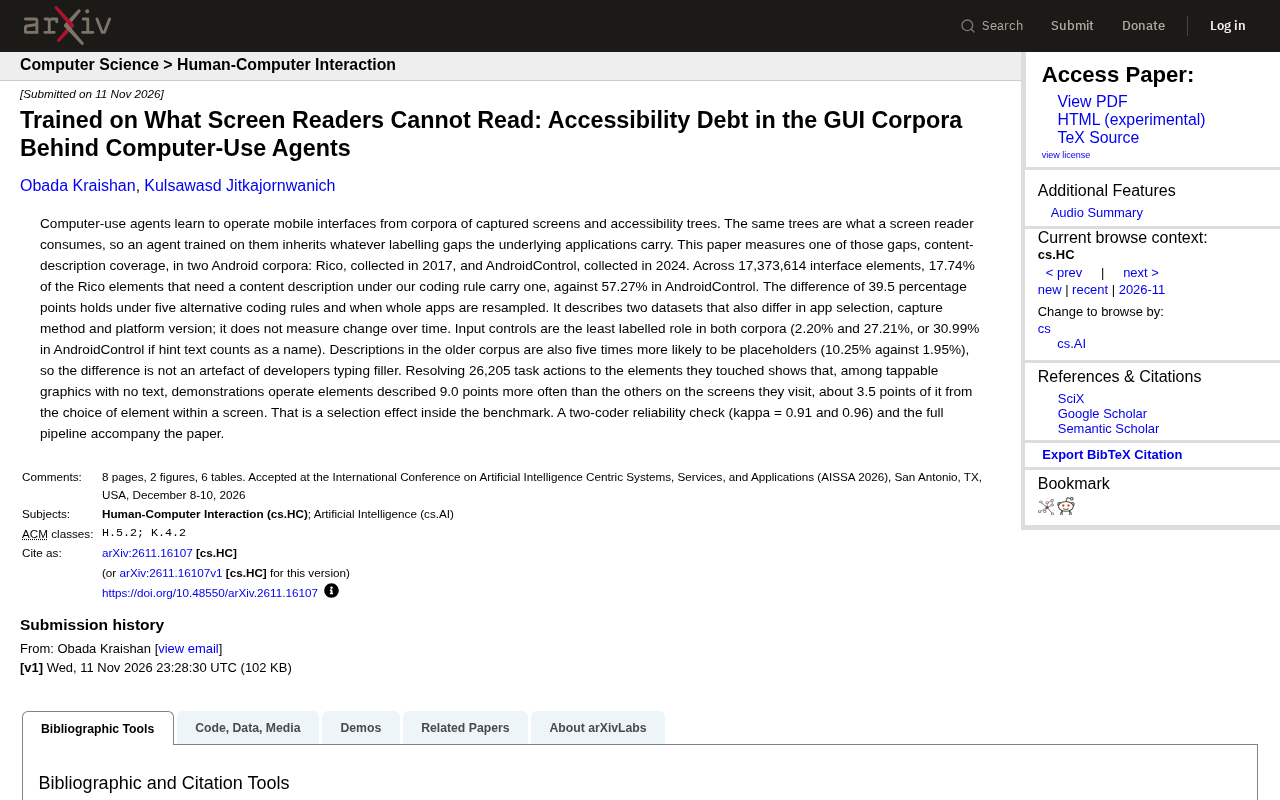
研究首次提出并量化「无障碍债务」:计算机使用代理与屏幕阅读器消费同一棵无障碍树,代理训练语料因此继承了应用的标签缺失问题。在两大数据集超1737万个界面元素上,2017年的Rico仅17.74%应标注元素带有内容描述,2024年的AndroidControl为57.27%,差距39.5个百分点且在五种编码规则下稳健。输入控件标签覆盖率最低。旧数据集描述为占位符的概率是新数据集的五倍。演示数据还存在选择效应:无文本可点击图形中被操作元素的标注率高9.0个百分点。作者克制因果推断,并公开流水线与双编码者信度检验。
计算机使用代理(computer-use agents)通过分析屏幕截图和无障碍树来学习操作移动界面。而同一棵无障碍树,也是屏幕阅读器为视障用户解析界面的依据。这意味着,代理在训练中会继承底层应用所携带的任何标签缺失问题——一篇新论文将这种现象称为「无障碍债务」(accessibility debt),并首次对其进行了量化。
两个数据集,一道39.5个百分点的鸿沟
研究测量了内容描述(content-description)的覆盖率,对象是两个 Android 界面数据集:2017 年收集的 Rico 和 2024 年收集的 AndroidControl。在超过 1700 万个界面元素中,按照作者设定的编码规则,Rico 中需要内容描述的元素仅有 17.74% 实际带有描述,而 AndroidControl 中这一比例为 57.27%。两者相差 39.5 个百分点。
这个差距在五种替代编码规则下、以及对整个应用进行重采样后依然成立,说明它不是某一种标注口径的偶然产物。不过作者明确提醒:这两个数据集在应用选择、采集方法和平台版本上也存在差异,因此该数字描述的是两个数据集之间的不同,并不能直接解读为「无障碍标注随时间改善了」。
输入控件是最薄弱环节
在两个数据集中,输入控件(input controls)都是标签覆盖率最低的角色类型:Rico 中仅为 2.20%,AndroidControl 中为 27.21%;若把提示文本(hint text)也算作名称,AndroidControl 可提升至 30.99%。输入框恰恰是代理执行搜索、填写表单等任务时最常打交道的元素,标签缺失意味着代理只能依赖视觉线索来猜测其用途。
Rico 是 Google 于 2017 年发布的 Android 界面大规模数据集,包含约 7.2 万个屏幕、近 10 亿个 UI 元素,长期被用于界面理解、生成和自动化测试研究。其采集方式是通过众包在真实设备上解析界面层级(view hierarchy),因此反映了当时大量主流应用的无障碍标注状况。AndroidControl 则是 2024 年发布、面向计算机使用代理的基准数据集,采集自更新的 Android 版本,并附带任务指令与操作轨迹。两者在采集年份、应用池和界面规模上都有明显差异,这也是作者强调不能将覆盖率差距直接解读为时间趋势的原因。
无障碍树(accessibility tree)是操作系统根据界面组件构建的一棵语义化结构树,每个节点携带角色(role)、名称(name)、内容描述(content description)、状态等属性。屏幕阅读器通过遍历这棵树来朗读界面,计算机使用代理同样通过它定位可交互元素。内容描述(content description)是当组件没有可见文本时由开发者手工提供的替代标签,用于告诉辅助技术「这个东西是什么」。而角色(role)决定元素的语义类型,如按钮、输入框、复选框等。内容描述缺失或角色定义模糊时,屏幕阅读器只能朗读「按钮,未加标签」,代理则失去可靠的语义信号,只能退回到基于像素的视觉猜测。
占位符污染:旧数据集的问题不止是「少」
覆盖率低只是问题的一面。研究进一步发现,旧数据集中带有描述的元素,其描述是占位符(placeholder)的可能性是新数据集的五倍——10.25% 对 1.95%。换句话说,Rico 中不少「有描述」的元素实际上挂着开发者随手填入的填充文本,对屏幕阅读器和代理都没有实际信息量。这一发现排除了「差距只是因为开发者填了废话」的替代解释,反而说明旧数据的描述质量问题比覆盖率数字显示的更严重。
演示数据中的选择偏差
论文将 26,205 个任务动作解析到它们所触碰的具体元素,考察了一个更微妙的效应:在可点击但无文本的图形元素中,演示数据所操作的元素,其被描述的比例比同屏其他元素高出 9.0 个百分点。其中约 3.5 个百分点来自「在同一屏幕内选择了哪个元素」——即标注更完善的元素更容易被选为演示对象。
这是一个基准内部的选择效应(selection effect):演示数据天然偏向那些已经被良好标注的元素,而代理在真实世界中遇到的界面未必如此。用这样的数据训练出的代理,在部署时面对标签缺失的界面,泛化能力可能被高估。
选择效应(selection effect)在统计学中指样本并非随机抽取,而是因某种筛选机制系统性地偏向特定类型的个体。在演示数据采集中,标注者或自动化流程会优先选择容易操作、语义清晰的元素,导致训练语料中的元素分布与真实界面分布不一致。这种偏差会让模型在基准测试中表现良好,却无法泛化到标签缺失的真实应用。作者用「同屏对比」的方式巧妙地将它拆解为两部分:跨屏差异(哪些界面被选中)与屏内差异(同一界面中哪个元素被选中),后者约 3.5 个百分点,是纯粹的采集行为造成的偏差。
对计算机使用代理意味着什么
这项工作的价值在于把两个此前分开讨论的问题连接了起来:无障碍工程和代理训练数据质量。屏幕阅读器的用户和计算机使用代理消费的是同一份无障碍树,前者的人道主义诉求与后者的性能诉求在此重合。当应用开发者忽视内容描述时,受损的不仅是视障用户,还包括未来依赖这些界面数据训练的自动化系统。
作者公开了完整流水线,并进行了双编码者信度检验(kappa 值分别为 0.91 和 0.96),为后续研究提供了可复现的基础。对于构建计算机使用代理的团队而言,这项研究提示了一个务实的检查项:在评估训练语料时,除了任务多样性和界面覆盖率,还应统计无障碍标签的完备程度——它可能直接影响代理在真实设备上的鲁棒性。
局限与开放性
论文本身对因果推断保持了克制:39.5 个百分点的差距横跨七年和两套不同的采集方法,不能简单归因于时间推移。更严谨的结论需要同一应用、同一采集协议下的纵向对比。此外,内容描述覆盖率只是无障碍债务的一个维度,角色语义、焦点顺序、状态播报等方面的缺口尚未被纳入测量。
相关推荐
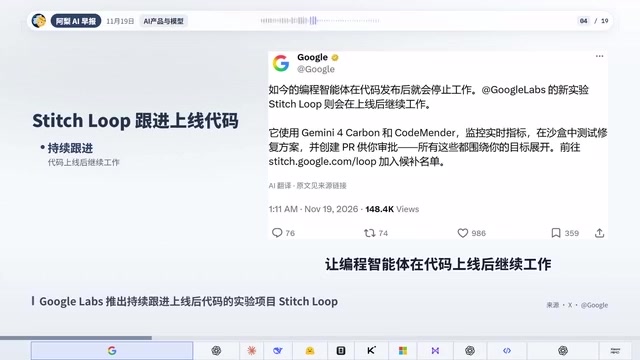
Gemini 4 Neon发布:编程登顶,Gemini 4世界模型开放
谷歌发布Gemini 4 Neon,编程代理指数登顶、支持百万Token上下文;Gemini 4世界模型开放Project Genie;DeepSeek联网搜索免费;微软公开Windows端侧小模型;白宫讨论要求美企披露是否使用中国开源模型。
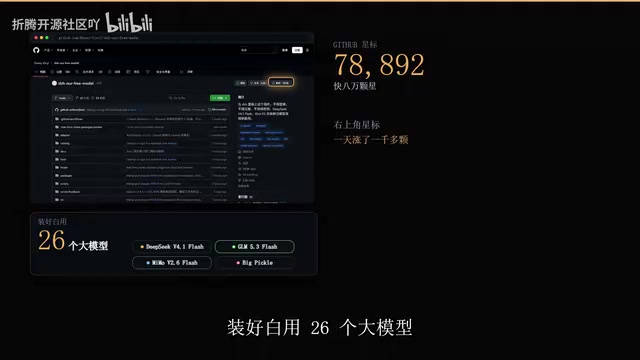
近8万星开源项目:本地白用26个大模型,DeepSeek、GLM全有
B站视频介绍一个近8万星开源项目,装好后本地白用26个大模型,DeepSeek、GLM全在里面,不用注册、不用填密钥,还能开本地地址供其他软件接入,适合不想充AI会员的轻量用户。
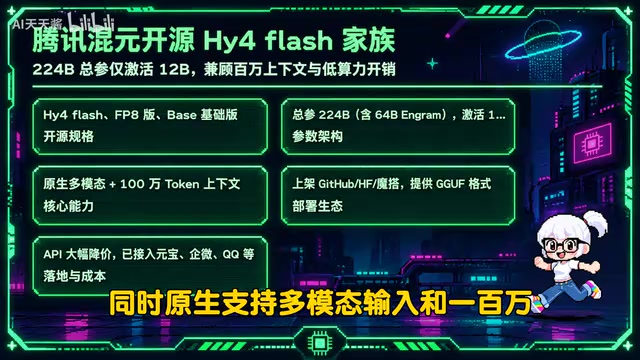
谷歌Gemini 4 Neon发布:百万元Token仅3美元,AI价格战再升级
谷歌发布Gemini 4 Neon,输入仅3美元/百万Token;腾讯混元开源Hy4 Flash;DeepSeek取消搜索抓取接口费;微软推出图像与语音新模型;英伟达停止向中国发运H200;花旗银行明确AI理财盗刷不兜底。一文速览当日AI硬核动态。