PIVOT:在线教师纠正如何突破RLVR稀疏奖励瓶颈

PIVOT 用教师轨迹纠正加 token 级 KL 监督,破解 RLVR 稀疏奖励困境。
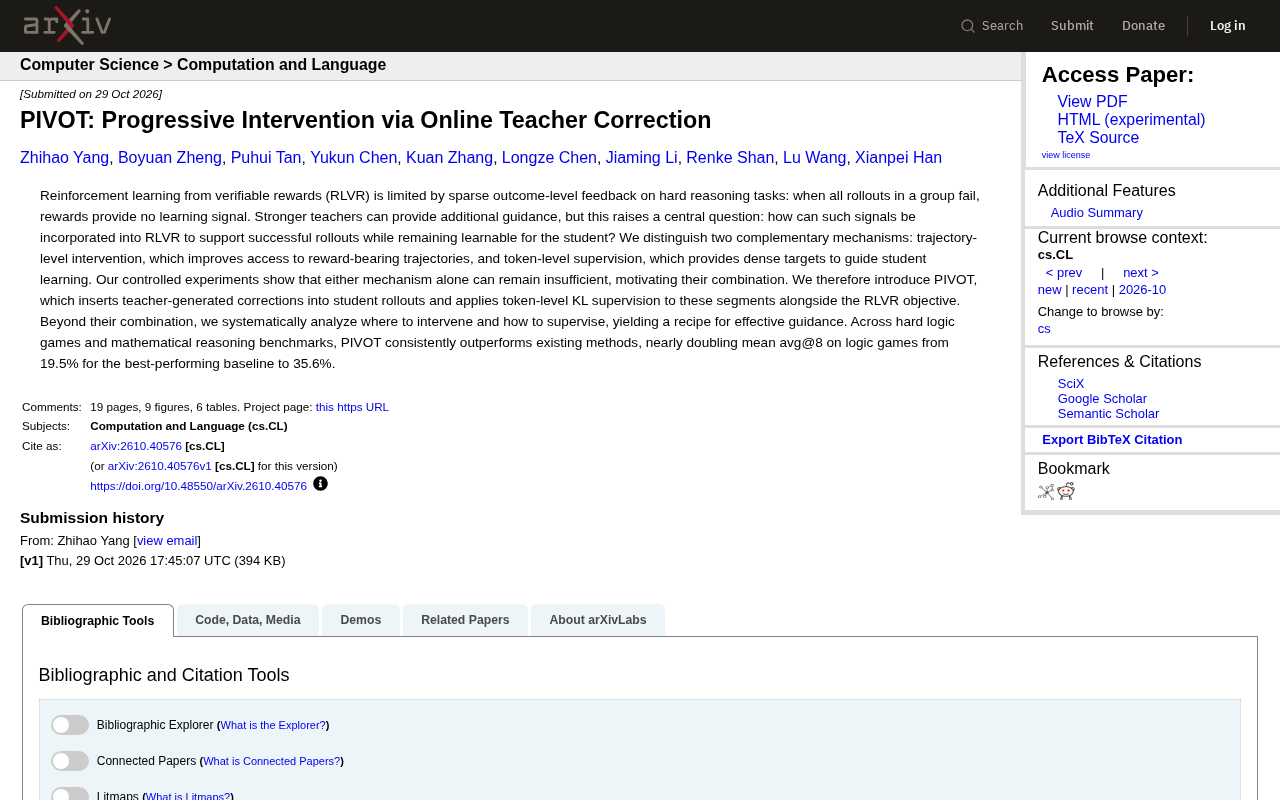
文章介绍 RLVR 在困难推理任务上的核心瓶颈:一组 rollout 全部失败时奖励为零,策略梯度无法更新。新方法 PIVOT 引入教师模型,在学生轨迹中插入教师纠正片段,使失败轨迹有机会进入带奖励区域,同时对纠正片段施加 token 级 KL 监督提供稠密信号,并与原始 RLVR 目标联合优化。控制实验表明轨迹干预与 token 监督单独使用均不充分,组合才有效。在逻辑游戏基准上,PIVOT 将 avg@8 从最佳基线的 19.5% 提升至 35.6%,数学推理基准也验证了泛化性。论文还系统分析了干预位置与监督方式,形成可复用的引导配方。
强化学习从可验证奖励中学习(RLVR)是当前提升大模型推理能力的主流范式,但它存在一个根本性瓶颈:当一组 rollout 全部失败时,奖励信号为零,模型无法从中学到任何东西。尤其在困难推理任务上,稀疏的结果级反馈让训练效率大打折扣。
一项名为 PIVOT 的新研究提出了针对性解法——将教师模型的在线纠正插入学生轨迹,并对纠正片段施加 token 级 KL 监督。在逻辑游戏和数学推理基准上,PIVOT 将逻辑游戏的平均 avg@8 从最佳基线的 19.5% 提升至 35.6%,接近翻倍。
稀疏奖励困境:全盘失败时无信号可学
RLVR 的核心假设是:模型生成一组候选答案,只要其中有一个能通过验证器,就能获得正奖励并强化对应的推理路径。但在困难任务中,这一假设经常落空——整组 rollout 全部失败,组内奖励方差为零,策略梯度更新无从谈起。
论文指出,这正是 RLVR 在困难推理任务上的关键限制:稀疏的结果级反馈在模型最需要学习的场景下恰恰失效。解决思路是引入更强的教师模型提供额外引导,但随之而来的问题是:教师信号如何融入 RLVR 框架,既能帮助学生产生成功的 rollout,又保持在学生可学习的范围内?
RLVR 与策略梯度:RLVR 通常采用 GRPO 等组相对策略优化方法,对同一 prompt 采样一组 rollout,用结果验证器给出 0/1 奖励,再以组内奖励的标准化值作为优势函数更新策略。这种设计依赖组内奖励存在方差:若全部成功或全部失败,优势全为零,梯度消失。全失败在困难任务中尤为常见,因为验证器只认最终答案,中间推理步骤再合理也得不到任何信号。这解释了为何纯结果级奖励在推理任务上扩展性受限,也构成了引入教师模型进行过程级引导的直接动机。
两种机制的互补性:轨迹干预与 token 监督
论文将教师引导拆解为两个互补机制:
- 轨迹级干预:在学生生成的轨迹中插入教师纠正,让原本失败的 rollout 有机会触达带奖励的轨迹区域。这解决的是“有没有成功经验可学”的问题。
- token 级监督:对纠正片段提供稠密的目标信号,直接指导学生在每个 token 上的学习方向。这解决的是“有了成功轨迹后怎么高效学”的问题。
控制实验显示,单独使用任一机制都不够充分:只有轨迹干预,学生缺少细粒度指导;只有 token 监督,又难以获得足够多带奖励的轨迹样本。这促使研究者将两者结合,形成 PIVOT 方法。
PIVOT 的方法设计:插入纠正 + KL 监督
PIVOT 的具体做法是:在学生 rollout 中插入教师生成的纠正片段,然后对这些片段施加 token 级 KL 监督,与原始 RLVR 目标联合优化。
研究团队并未止步于简单组合,而是系统分析了两个关键设计维度:在哪里干预(插入位置的选择)和如何监督(KL 监督的作用方式)。这些分析得出了有效引导的“配方”,使方法具备可复现性和可迁移性。
你可能没注意到,这种设计保持了学生模型的自主性——教师纠正只在需要时介入,而非替代学生完成整个推理过程。
Token 级 KL 监督的含义:KL 散度衡量两个概率分布之间的差异。在 PIVOT 中,对教师纠正片段所在的 token 位置,约束学生模型在该位置上的下一 token 分布靠近教师分布,即最小化 KL(学生‖教师)。与对纠正片段直接做交叉熵(硬标签)不同,KL 监督使用教师的完整 soft 分布作为软目标,保留了教师对各候选 token 的相对置信度,信号更平滑,也更不容易让学生过拟合到单一答案。由于监督只作用于插入片段,原始学生 token 仍由 RLVR 奖励驱动,两类损失联合优化,从而在保持学生自主探索的同时获得稠密的过程级指导。
实验结果:逻辑游戏性能接近翻倍
在困难逻辑游戏和数学推理基准上,PIVOT 一致优于现有方法。最突出的数据来自逻辑游戏:平均 avg@8 从最佳基线的 19.5% 提升到 35.6%,接近翻倍。这一提升幅度说明,稀疏奖励问题一旦被缓解,模型在困难任务上的推理潜力能够显著释放。
数学推理基准上的表现也验证了方法的泛化性——PIVOT 并非只对某一类任务有效,而是适用于需要多步推理的广泛场景。
avg@8 指标:avg@8 指对同一问题独立采样 8 条推理轨迹,统计其中答对的比例,再在所有问题上取平均。它衡量的是模型在多次尝试下的期望正确率,比单次 pass@1 更能反映模型在困难任务上的潜力分布。该指标对稀疏奖励方法尤其敏感:若模型偶尔能成功,avg@8 会明显高于贪心解码的准确率;若整组全失败,则接近零。因此从 19.5% 到 35.6% 的提升,意味着模型从“几乎无法触及正确答案”变为“多次尝试中约三分之一能成功”,反映的是可学习成功轨迹数量的实质增加。
对 RLVR 研究的启示
PIVOT 的价值不仅在于性能提升,更在于它提供了一个清晰的框架:将教师引导分解为“轨迹可达性”和“token 级监督”两个正交维度。这一分解方式对后续研究有直接参考意义——任何试图引入外部引导的 RLVR 改进,都可以从这两个维度审视自身设计的完备性。
论文对干预位置和监督方式的系统分析,也提醒研究者在组合不同机制时不能停留在“堆叠”层面,而需要理解每个设计选择的作用边界。对于受困于稀疏奖励的推理任务训练,PIVOT 提供了一条可操作的渐进式干预路径。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。

Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。