Project Lily揭秘:正在阅读你ChatGPT对话的人
与ChatGPT的对话并不私密,人类审阅员读取用户对话是AI行业训练模型的普遍做法。
本文围绕「Project Lily」这一在Hacker News引发关注的话题,揭示了AI对话领域一个被广泛忽视的现实:为实现模型对齐与内容过滤,人类审阅员读取用户对话是主流大语言模型产品的行业标配。文章指出,真正的风险并非审阅行为本身,而在于三个层面的透明度缺失:用户输入的内容往往高度敏感(涉及健康、法律、财务等),服务商的去标识化承诺在技术上存在局限,且大多数用户从未获得清晰的知情权与便捷的退出选项。文章建议用户主动调整隐私设置、避免输入可识别身份的信息,并呼吁AI行业建立更透明的数据使用披露机制。
当AI对话不再私密
一则名为「Project Lily」的报道在 Hacker News 上引发讨论——标题直指一个许多用户忽视的事实:与 ChatGPT 的对话,可能并非只有你和机器之间的秘密。在这个项目名称背后,指向的是一个长期存在但少被公开讨论的现实:人类审阅员(human reviewers)会读取部分用户与 AI 的对话内容。
需要坦率说明的是,本文所依据的原始素材信息量非常有限——仅有一个标题、13 个赞与零条评论,缺乏对 Project Lily 的具体细节、运作机制和涉及主体的详细披露。因此下文更多是围绕这一话题所引出的行业背景与隐私议题展开分析,而非对该项目本身的事实性还原。
人类审阅:AI 训练中公开的秘密
对于任何一款主流大语言模型产品而言,人类参与数据审阅几乎是行业标配。这背后有其技术逻辑:模型需要通过人类反馈强化学习(RLHF)来对齐输出、过滤有害内容、修正错误回答。要完成这些工作,就必须有人接触真实的用户对话样本。
换句话说,所谓「与 AI 私密对话」在很多情况下是一种误解。多数 AI 服务的隐私政策中,都会以相对模糊的措辞说明:为改进服务,部分对话可能被用于训练或人工审阅。问题在于,绝大多数用户从未仔细阅读过这些条款,也不清楚「部分」究竟意味着多大比例、由哪些人、在什么条件下阅读。
RLHF(基于人类反馈的强化学习)是目前主流大语言模型对齐技术的核心环节。其流程通常分为三步:首先用监督学习微调基础模型,然后让人类标注员对模型的多个输出进行排序或评分,以此训练一个「奖励模型」(Reward Model),最后用强化学习算法(如 PPO)让语言模型在奖励模型的引导下调整输出倾向。正是第二步中,真实用户对话或刻意构造的测试对话需要被人类标注员读取、评判。OpenAI、Anthropic、Google 等主流厂商均依赖规模不等的标注团队完成这一工作,其中部分外包给第三方数据服务公司。这意味着「读取对话」的主体并不局限于产品公司内部员工,而可能延伸至外部合作方,进一步增加了数据流转的复杂性与隐私管控难度。
用户该担心什么
真正值得关注的并非「有人读取」这一行为本身,而是几个关键的透明度问题。
数据的敏感性
用户在与 ChatGPT 这类工具交流时,往往会输入远比社交媒体更私密的内容——健康咨询、法律问题、财务细节,甚至情感倾诉。这些内容一旦进入人工审阅流程,其敏感程度远超普通网页浏览记录。
匿名化是否可靠
服务商通常声称审阅前会对数据做去标识化处理。但研究早已表明,仅靠删除姓名等直接标识符,难以完全防止重新识别(re-identification),尤其当对话中包含大量独特的个人细节时。
「去标识化」(de-identification)与「匿名化」(anonymization)在学术与法律语境中含义有所区别。去标识化仅移除直接标识符(如姓名、邮箱),而真正的匿名化要求即便结合外部数据集也无法还原个人身份。2000 年代初,研究者 Latanya Sweeney 证明仅凭邮政编码、性别与出生日期三项信息,便可唯一识别美国约 87% 的人口;2006 年 Netflix 匿名化数据集被成功重新识别的案例,则成为隐私研究领域的经典警示。对话文本因包含大量语境细节(特定经历、地点、人际关系描述),其重新识别风险往往高于结构化数据,这使得服务商声称的「去标识化保护」在实践中存在相当的局限性。
知情与选择权
更核心的是用户是否拥有清晰的知情权和退出机制。部分产品提供了「关闭聊天记录用于训练」的选项,但这类设置往往藏得较深,默认状态也倾向于开启。
如何保护自己的对话隐私
在无法完全掌控服务商行为的前提下,用户仍可以采取一些务实措施:
- 查看并调整 AI 产品的隐私设置,关闭「用于模型训练」的选项(如果提供)
- 避免在对话中输入真实姓名、身份证号、银行卡等可直接识别身份的信息
- 对高度敏感的咨询,优先考虑提供企业级隐私承诺或本地部署的方案
- 定期清理对话历史,减少长期留存的数据面
结语:透明度才是关键
「Project Lily」这个标题之所以能触动神经,是因为它把一个抽象的隐私条款,具象成了「有人正在读你的对话」这一画面。对 AI 行业而言,人类审阅短期内难以完全消失——它是模型质量与安全的必要环节。真正需要改进的,是让这一过程更加透明:清晰告知用户数据如何被使用、由谁审阅、如何保护,并提供简单可及的选择权。
(提示:本文基于有限的公开信息撰写,关于 Project Lily 的具体运作细节仍有待更多权威来源披露,读者应以官方与可信媒体的后续报道为准。)
相关推荐
Swift-Qwen3.8-27B:削减58%思考token,推理速度翻倍
UkisAI 开源 Swift-Qwen3.8-27B,通过定位并惩罚"过度思考"token,配合在线策略蒸馏,实现思考token削减58%、推理速度提升1.95倍,准确率损失控制在1%以内。本文详解其技术路径与基准测试数据。
习近平倡议金砖国家建设开源AI合作区
习近平在金砖国家峰会上提出建立开源AI合作区,推动成员国加强人工智能领域合作。本文解析这一倡议背后的战略意图、开源路线选择及其对全球AI格局的深远影响。
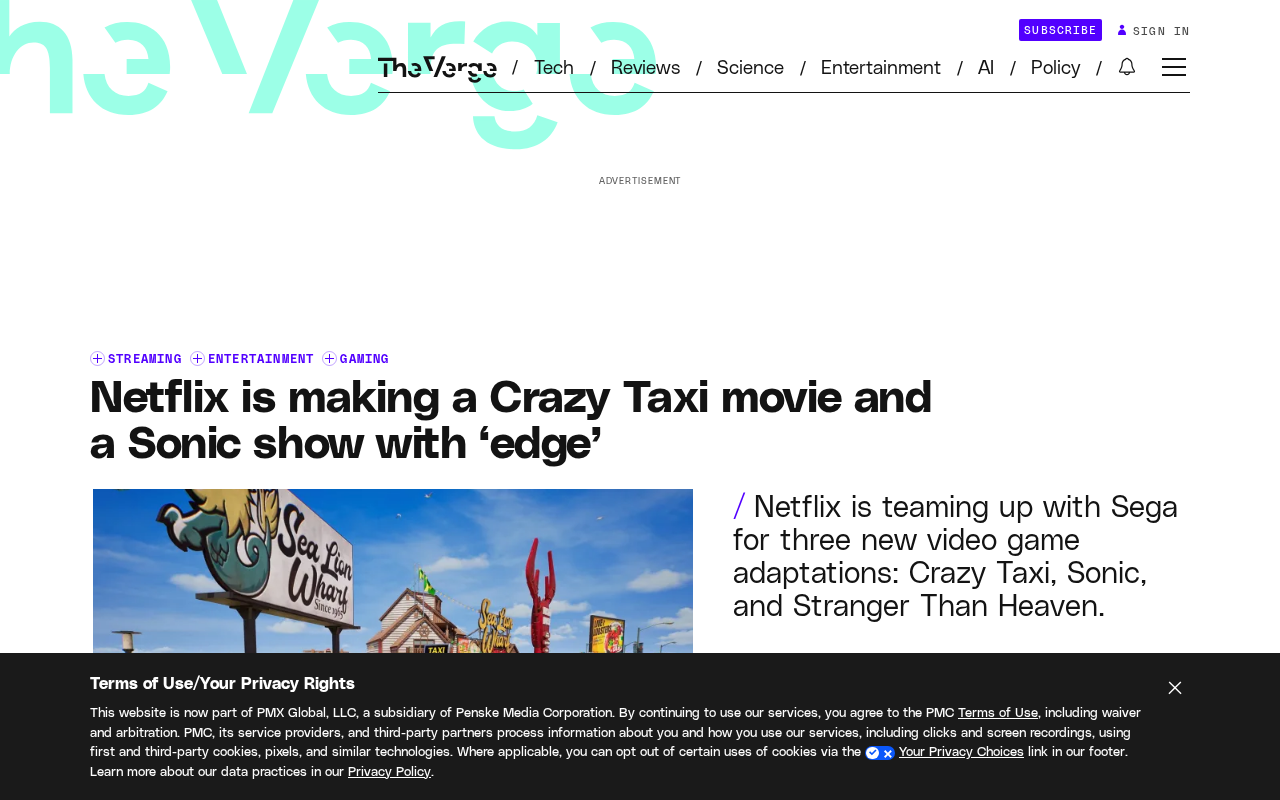
网飞牵手世嘉:《疯狂出租车》电影与全新索尼克动画来袭
Netflix 宣布与世嘉合作改编三部游戏 IP:《疯狂出租车》电影、全新《索尼克》动画剧集,以及基于《如龙》开发商新作《Stranger Than Heaven》的真人电影,游戏改编热潮再添力作。