Python实战:Agentic AI、AI Agents与生成式AI的核心区别
从Python项目实战出发,厘清生成式AI、AI Agent与Agentic AI的能力边界。
文章通过一个完整的Python项目搭建流程,演示了生成式AI、AI Agent和Agentic AI三个概念在工程实现上的差别。生成式AI(LLM)的本质是输入输出映射,知识受训练截止日期约束,无法回答实时问题;AI Agent的核心是给LLM接上至少一个外部工具(如Tavily联网搜索),使其突破知识边界;Agentic AI则是多工具、多智能体的进阶架构,涵盖Plan-and-React、ReAct和多智能体协作等模式。文中还记录了环境搭建、依赖与密钥管理、工具函数docstring如何被模型理解,以及GPT-6 Astra不支持function calling这一踩坑经历,最终结论是企业级自动化必须依赖Agentic AI。
生成式AI、AI Agent和Agentic AI这三个词经常被混着用,但在工程实现上它们对应的是完全不同的能力层级。一位B站UP主通过完整的Python项目搭建流程,从零演示了三者的边界在哪里,以及为什么企业级自动化真正需要的是Agentic AI而不是单纯的生成式AI。
项目结构搭建:从VSCode到虚拟环境
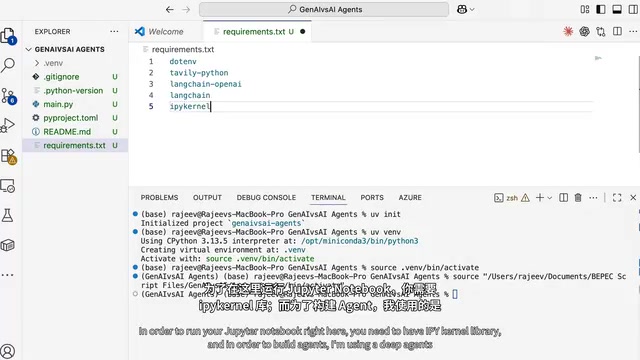
视频从一个干净的VSCode环境开始。UP主的做法是先建立规范的项目结构,而不是直接在Jupyter Notebook里写代码。他在文档文件夹中创建了名为"G9 vs AI Agents"的项目文件夹,随后在终端中使用UA(uv)工具进行依赖管理。
选择UA而非PIP的原因很直接:安装库和创建虚拟环境的速度要快得多。执行pip install UA之后运行UA init,项目结构会自动初始化,包含Gitignore文件、Main.py、pyproject.toml以及README.md等标准文件。
虚拟环境的激活遵循同样的最佳实践。UP主强调,生产环境中不需要安装所有库,只需要运行脚本所需的那部分。执行UV-W创建虚拟环境后,将链接复制到终端即可激活。
依赖管理与API密钥配置
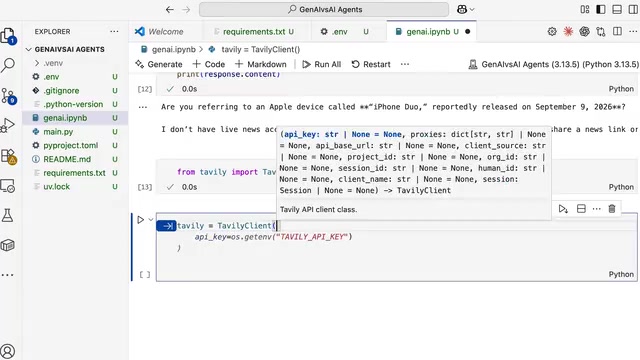
requirements.txt文件中列出了这个项目需要的全部Python库:python-dotenv用于加载环境变量,LangChain和LangChain OpenAI用于构建Agent,IPI Kernel库用于运行Jupyter Notebook,Deep Agents库则是构建Agent的核心依赖。通过UV pip install -r requirements.txt一次性安装完成。
API密钥的配置涉及两个服务。OpenAI的API密钥用于调用大语言模型,Tavily的API密钥用于联网搜索。UP主特别指出,直接把API密钥写进Python代码不是规范做法,正确的方式是创建.env环境变量文件,通过load_dotenv加载后从OS环境中读取。
为什么用 .env 而不是硬编码密钥:把 API 密钥写在 Python 源码里存在两个实际问题。一是版本控制风险——一旦代码被提交到 Git 仓库,密钥就会留在提交历史中,即使后续删除也难以彻底清除;二是环境隔离问题——开发、测试、生产环境的密钥不同,硬编码会导致每次切换都要改代码。.env 文件的做法是把密钥与代码分离,python-dotenv 的 load_dotenv() 会读取该文件并将其内容注入到进程的环境变量中,代码通过 os.getenv() 或 os.environ 读取。配套的实践是把 .env 加入 .gitignore,只提交一份不含真实密钥的 .env.example 作为模板。这样同一个代码库可以在不同环境中以不同凭据运行,也便于在 CI/CD 流水线中通过密钥管理服务注入。
生成式AI的能力边界:知识截止日期问题
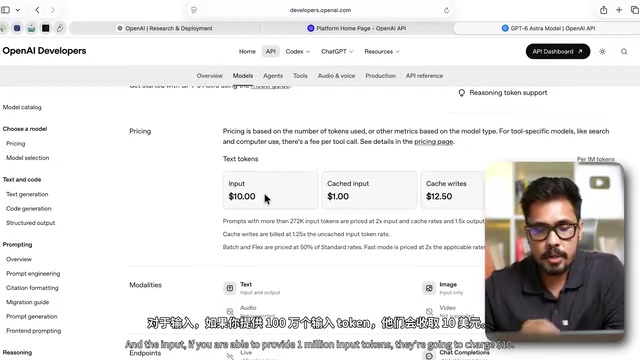
配置完成后,UP主用ChatOpenAI创建了一个基础LLM实例,并选择了GPT-6 Astra模型。这个模型的上下文窗口达到100万token,知识截止日期为2026年4月30日。定价方面,每百万输入token收费10美元,每百万输出token收费50美元——相比GPT 5.6的4美元输入和20美元输出,成本明显更高。
最简单的测试暴露了生成式AI的根本局限。UP主询问了一个发生在2026年9月9日的iPhone新品发布新闻,模型的回复是:知识截止到2026年4月30日,无法获取实时资讯。
这就是生成式AI的定义特征——提供输入,获得输出,模型的知识完全受限于训练数据的截止时间。UP主将这种能力称为LLM(大语言模型),并指出如果企业试图用这种状态下的LLM处理实时业务,基本没有实用价值。
AI Agent:给LLM接上第一个工具
突破知识截止日期限制的思路很清晰:连接外部工具。UP主使用Tavily的搜索API构建了一个互联网搜索工具函数。
这个函数的关键在于docstring——当把这个函数注册给LLM时,模型通过docstring理解工具的用途。函数定义中包含了查询参数和结果数量参数,UP主设置默认从互联网获取5条结果。
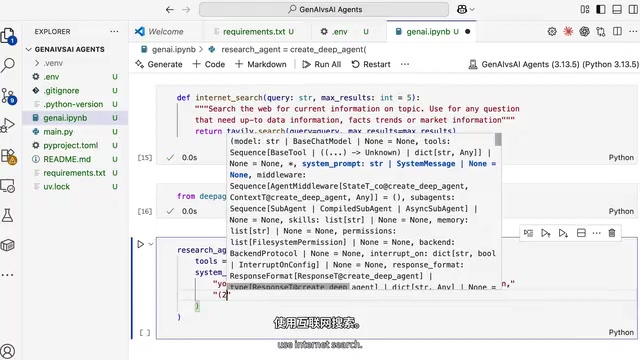
工具创建完成后,通过Deep Agents库的create_deep_agent函数创建了一个研究智能体。这个Agent的配置包含三部分:工具列表(互联网搜索)、系统提示词(包括始终写to-do list、使用互联网搜索获取最新信息、保存研究结果到文件、写最终报告)、以及模型(此处需要支持工具调用的模型)。
UP主特别提到一个踩坑经历:GPT-6 Astra不支持工具调用,报错后切换到支持function calling的模型才能正常运行。
当Agent接收到关于iPhone新品的查询时,它判断自己的知识不足以回答,于是触发互联网搜索工具,将搜索结果整合后输出回复。UP主将这种"只有一个工具"的架构称为AI Agent。
function calling 与 docstring 的关系:LLM 本身不会执行代码,它只能生成文本。所谓工具调用(tool calling / function calling),是指模型在生成回复时输出一个结构化的调用意图(包含函数名和参数),由外部程序解析并真正执行该函数,再把返回值塞回对话上下文交给模型继续推理。模型判断"该调哪个工具、传什么参数"的依据,正是函数的名称、参数签名和 docstring——这些信息会被序列化成 JSON Schema 一并发送给模型。因此 docstring 写得清楚与否直接决定工具调用的准确率。这也解释了为什么 GPT-6 Astra 在这条链路上不可用:模型必须在训练中经过专门的对齐,才能稳定地输出符合 Schema 的调用请求,不具备该能力的模型只会把工具描述当成普通文本看待。
Agentic AI:多工具、多Agent的复杂架构
如果连接多个工具并引入更复杂的架构,就进入了Agentic AI的范畴。视频中提到的架构模式包括:
- Plan and React架构:Agent先制定计划,再根据执行结果做出反应和调整
- ReAct架构:推理与行动交替进行
- 多智能体协作:包括顺序智能体和集群智能体等不同组织形式
UP主的核心观点是:生成式AI本身无法支撑真正的实时应用,必须将生成式AI与AI Agent结合才能释放价值。而Agentic AI才是企业级自动化所需的工具,这也是为什么各公司都在要求员工了解Agentic AI的原因。
对于想进入这个领域的开发者,UP主的建议是通过Python掌握这些能力,因为它们最终需要被集成到Web应用中,而不仅仅是停留在ChatGPT的对话框里。这也是软件工程基础知识在AI工程中依然重要的原因。
ReAct 与 Plan-and-React 的区别:ReAct(Reasoning + Acting)的思路是让模型在一个循环里交替进行"思考一步、行动一步、观察结果、再思考",每一步都基于上一步的实际反馈来决定下一步做什么,适合路径不确定、需要边探索边修正的任务。Plan-and-React 则把过程拆成两个阶段:先由模型一次性产出完整的任务计划(通常是待办清单),再逐步执行并在出现偏差时修订计划。前者的优势是灵活、对反馈响应快,劣势是容易在多步任务中迷失方向、消耗更多 token;后者的优势是全局结构清晰、便于人类审阅和干预,劣势是初始计划如果判断失误,后续执行会整体跑偏。工程上常见的是两者混合——用计划确定骨架,用 ReAct 循环填充每个子任务的执行细节。
相关推荐

AI数字分身实战:用DOT自动追踪Bug与用户反馈
DOTS 团队工程师演示如何用 AI 数字分身 DOT 跨平台收集用户反馈、自动归类问题主题、开线程调查 Bug 根因并直接提交 PR,展示 AI 代理参与缺陷分诊的完整工作流与可审计设计。

晶体管为何不再扁平?从平面到环绕栅极的演进
晶体管从平面到FinFET再到环绕栅极的演进:为何栅极需要从三面包裹到四面环绕,以抑制短沟道效应和泄漏电流,延续摩尔定律。

蜂群思维=单个RL智能体?多臂老虎机等价性证明
一篇论文证明蜂群通过局部模仿进行的集体决策,在数学上等价于单智能体强化学习。N个盲目模仿者相当于N个并行环境采样,有效学习率为1/N。本文解读Maynard-Cross Learning算法的推导与影响。