强编排模型让本地小模型提速2.6倍:GPT-6.1 Sol实测观察

云端强模型做编排、本地小模型做执行,实测速度提升2.6倍且成本降低77%。
一位开发者在实测中发现,用 GPT-4.1 Sol 作为编排者、本地 Qwen 27B 作为执行者的混合架构,不仅将三个编程任务的费用从 $0.75 降至 $0.17,还让本地小模型的完成时间缩短了约 2.6 倍,并解锁了其单独运行时无法完成的任务。作者推测,小模型的时间瓶颈并非生成速度,而是在没有明确计划时陷入决策迷失——反复试错、摇摆耗尽了大量 token 和时间。一旦强模型将任务拆解为清晰步骤,小模型只需专注执行,效率大幅提升。这提示「强编排 + 弱执行」架构的价值不仅限于成本优化,可能同时带来速度与成功率的提升,但该结论基于单次小样本实验,尚需更严谨的复现验证。
一次意外的实测发现
一位开发者在 Reddit 上分享了一组有趣的实验数据:当他用 GPT-6.1 Sol 作为「编排者」(orchestrator),指挥一个跑在单张 RTX 3090 上的本地 Qwen 3.8 27B 模型完成任务时,他原本只期待账单变便宜——结果确实便宜了(三个小游戏任务从 Sol 单独跑的 $0.75 降到 $0.17)。
真正让他意外的是速度。同样的模型、同样的显卡、同样的提示词,加上一份「自上而下」的执行计划后,本地小模型的完成时间几乎缩短了一半以上。
这个观察触及了一个容易被忽视的问题:小模型的时间成本,到底花在了哪里?
GPT-4.1 Sol(文中称 GPT-6.1 Sol,可能为作者对该模型系列的简称)是 OpenAI 面向开发者的云端推理模型,以较强的指令遵循和规划能力见长,但按 token 计费,调用成本较高。Qwen 3 系列是阿里云广告开源的多规格语言模型,其中 8B/27B 参数版本可在消费级 GPU(如 RTX 3090,24GB 显存)上本地运行,推理成本几乎为零,但在复杂规划任务上与顶级云端模型存在差距。这种「云端大模型 + 本地小模型」的组合使用方式,近年来随着开源模型质量提升和本地推理框架(llama.cpp、vLLM 等)成熟而日趋普及。
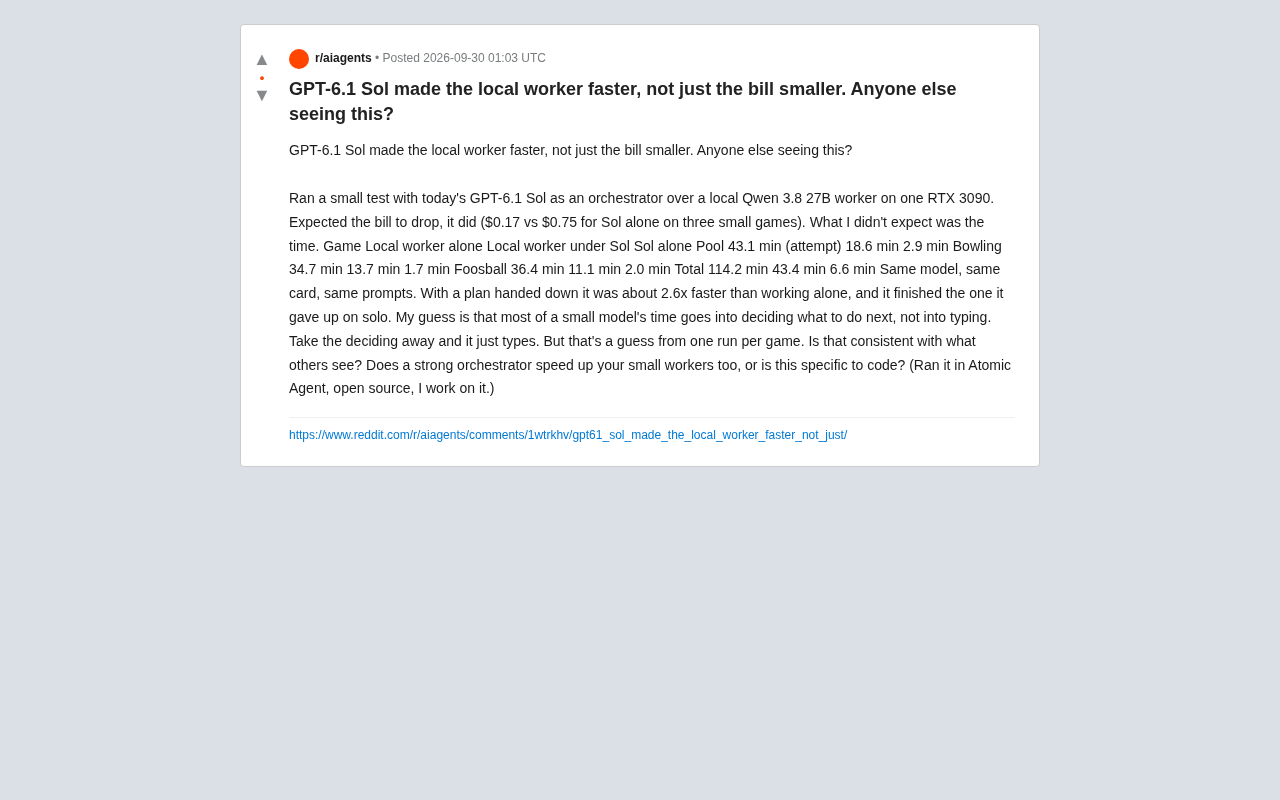
数据说了什么
作者在开源框架 Atomic Agent(他本人参与开发)中运行了三个编程小游戏任务,对比了三种配置:本地小模型单独工作、本地小模型在 Sol 编排下工作、以及 Sol 单独完成。结果如下:
| 任务 | 本地模型单独 | 本地模型 + Sol 编排 | Sol 单独 |
|---|---|---|---|
| Pool(台球) | 43.1 分钟(尝试) | 18.6 分钟 | 2.9 分钟 |
| Bowling(保龄球) | 34.7 分钟 | 13.7 分钟 | 1.7 分钟 |
| Foosball(桌上足球) | 36.4 分钟 | 11.1 分钟 | 2.0 分钟 |
| 合计 | 114.2 分钟 | 43.4 分钟 | 6.6 分钟 |
从数据看,本地模型在编排下比单打独斗快了约 2.6 倍。更值得关注的是 Pool 这一项——本地模型单独运行时标注为「attempt(尝试)」,意味着它没能独立完成;而在 Sol 给出计划后,它顺利跑完了这个原本放弃的任务。
一个关键假设:小模型的时间花在「决策」上
作者提出了一个颇具启发性的推测:
小模型的大部分时间,可能都花在「决定下一步做什么」上,而不是花在「打字」(即生成代码)本身。把决策这一环节拿掉,它就只需要老老实实地输出。
这个假设如果成立,会改变我们对小模型能力瓶颈的理解。传统上我们倾向于认为,小模型慢是因为它「算得慢」或者「能力弱」。但这组数据暗示,瓶颈可能更多在于规划与推理的迷失——小模型在没有明确路径时会反复摇摆、试错、重新思考,消耗掉大量 token 和时间。
一旦有一个更强的模型把任务拆解成清晰步骤,小模型的角色就从「既要想又要做」退化为「只需要做」,效率自然大幅提升。这也解释了为什么它能完成原本放弃的任务:不是能力突然变强,而是不再卡在决策死循环里。
从 token 生成的角度来理解这一假设:语言模型的推理时间主要由两部分组成——「prefill」(处理输入提示词)和「decode」(逐 token 生成输出)。在没有明确计划时,小模型往往需要在每一步都重新评估当前状态、回顾上下文、生成大量中间推理文本,这些都会拉长 decode 阶段并增加总 token 数。一旦编排者预先输出了结构化的执行步骤,小模型的每次调用输入更短、任务边界更清晰,decode 所需 token 数大幅减少,累计下来便体现为整体速度的提升。这与「思维链(Chain-of-Thought)提示」的逆向视角相呼应:CoT 让模型自己生成推理步骤以提升准确率,而编排模式则是由外部强模型代劳推理步骤,让弱模型跳过这一开销。
编排架构的价值:不只是省钱
这类「强模型编排 + 弱模型执行」的架构近年来越来越常见,通常被视为一种成本优化手段——用便宜的本地模型承担大部分算力,只在关键决策点调用昂贵的云端大模型。
但这次实测提出了一个新的视角:编排的价值可能不止于省钱,还能同时提升执行速度和成功率。如果强编排者的规划能力能显著减少弱执行者的无效探索,那么这套架构就是「又快又便宜又更靠谱」的三赢,而不是在成本和质量之间做权衡。
对于本地部署 LLM 的开发者来说,这意味着单张消费级显卡(如 RTX 3090)上的小模型,配合一个好的云端编排层,或许能胜任比想象中更复杂的任务。
「强模型编排 + 弱模型执行」在学术和工程领域通常被称为 LLM-as-Orchestrator 或 Multi-Agent 架构。其核心思想是将一个复杂任务分解为「规划」和「执行」两层:编排层(Orchestrator)负责任务理解、拆解与步骤分配,执行层(Worker/Executor)只需按照已明确的子任务逐步输出结果。这一模式的理论基础来自认知科学中的「工作记忆负荷」概念——当智能体同时承担规划与执行时,两类认知负荷叠加会导致效率下降;拆分后每一层只专注单一职责,整体吞吐可以显著提升。Atomic Agent 是作者开发的开源框架,提供了一套标准化接口来定义编排者与执行者角色,并管理它们之间的消息传递。
需要保持的谨慎
作者本人非常克制地强调了这项测试的局限性:
- 样本极小:每个游戏只跑了一次,缺乏重复实验来排除随机性。
- 任务单一:三个都是编程类小游戏,结论未必能推广到其他领域。
- 利益相关:他是 Atomic Agent 框架的开发者,测试环境与结论存在潜在偏向。
因此他在帖子里主动向社区求证:这种「强编排者加速小模型」的现象,是否与其他人的经验一致?它究竟是编程任务特有的,还是一种更普遍的规律?
结语:一个值得复现的问题
这条来自 Reddit 的单点观察,本质上是一个有待验证的假设,而非定论。它的价值不在于那组具体数字(2.6 倍、$0.17 vs $0.75),而在于它把一个平时被忽略的问题摆到了台面上:
当我们让强模型给弱模型「派活」时,我们究竟在优化什么——是钱,是速度,还是任务成功率?
如果你也在做本地模型 + 云端编排的架构,不妨用更严谨的多次实验去验证这个现象。如果它能被稳定复现,那么它对边缘部署、成本敏感型 AI 应用的意义,会远超一次偶然的测试。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。