Qwen 4 Max预览版:评测争议下的真相与开发者指南
阿里Qwen 4 Max Preview无官方基准引发第三方评测矛盾,揭示AI模型评判困境。
阿里巴巴发布Qwen 4 Max Preview,支持100万token上下文和工具调用,但未公布官方基准分数,且预览版仅存活至11月25日。第三方评测结果矛盾:Model Dial给出78.8分排名第14,知识约90分、编码约80分但代码质量仅59分;GameField基准却称其不如旧版Qwen。分歧部分源于测试构建每日更新(如Qoduck)导致评测对象不一致。文章还从Qwen 3.8 Flash Next窥见MoE架构线索(总参数1250亿、每词激活60亿),并指出Max无开放权重。最终建议开发者用真实问题试用、通过标准接口连接以便切换,暂不构建产品依赖。
阿里发布了其史上最大AI模型Qwen 4 Max Preview,但官方未公布任何基准分数,第三方评测结果却大相径庭——有人称其出色,有人指其不如旧版。这场争议揭示了我们评判AI模型的深层问题。
发布即争议:一个没有成绩单的模型
11月11日,阿里巴巴推出Qwen 4 Max Preview。名字中的每个词都值得推敲:Qwen 4是家族,Max是最大成员,Preview意味着它只是试用版。它支持文本、图像和视频理解,具备思考后回答的能力,还能调用工具执行操作,而非仅停留在对话层面。
最引人注目的数字是100万token的上下文窗口——相当于一次对话就能容纳一座小型图书馆。但有个关键限制:这个预览版有保质期,11月25日结束,届时该模型将退役。阿里承诺之后会推出正式版,这相当于一场15天的试驾。
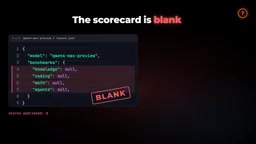
问题随之而来:这辆车到底怎么样?通常发布时会附带基准测试成绩单,但这次阿里的成绩单是空白的——没有基准表,没有分数,只有“更深的知识和更强的编码”的承诺。承诺不是测量。
上下文窗口(Context Window) 指模型单次能处理的最大token数量,包括输入和输出。100万token的上下文窗口意味着模型可以一次性阅读约75万英文单词或大量代码库、长文档、多轮对话历史。扩大上下文窗口的难点在于注意力机制的计算和内存开销随长度平方增长,以及模型在长上下文中保持关键信息的能力(即“有效上下文”)。实际使用中,模型未必能均匀利用窗口内的所有信息,因此长上下文能力需要专门评测。
第三方评测:同一模型,截然不同的结论
外界开始自行测试。独立评测机构Model Dial运行了私有的编码和知识测试,预览版得分78.8/100,在54个模型中排名第14。这个成绩不错,但算不上统治级。
更有趣的是分数模式:知识类任务约90分,编码类约80分,但代码质量和打磨程度只有59分。这意味着它是一个强大的思考者,但代码可能粗糙。
紧接着出现了令人困惑的转折。GameField是一个测试模型构建游戏能力的基准,其维护者报告称预览版得分低于更早的Qwen模型,并称整个情况“令人困惑”。话说回来,其他开发者发布了他们喜爱的网页演示。同一模型、同一周内,结论完全相反。
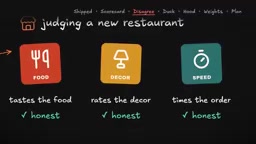
这怎么可能都成立?因为每个测试测量的东西不同。就像评判一家新餐厅:一位评论家品尝食物,另一位评价装饰,第三位只计算上菜速度。三人都诚实,但测量的不是同一件事——不同技能、不同设置、小样本。
“鸭子”插曲:测试的模糊性
还有一个更奇怪的原因导致结果分歧,涉及一只“鸭子”。发布前几天,一个名为QDAR的编码工具提供了一个神秘模型,名叫Qoduck,没有制作者信息,没有细节。人们猜测它是Qwen 4。发布当天,Qwen确认了这一点:Qoduck是Qwen的测试构建,而且这个构建每天都在更新。
想象两个人评测同一个应用:一个用周一的版本,另一个用周三的版本。他们可能根本不是在评测同一个东西。这不能证明GameField为何得分低,但阿里之外没人知道大家测试的是否是同一个模型。
引擎盖下:从Flash Next窥探架构
无法直接看到Qwen 4 Max的规模或设计,阿里并未分享。但有一条线索:8月发布的较小模型Qwen 3.8 Flash Next,官方称其预览了Qwen 4将采用的设计——混合专家(MoE)架构。
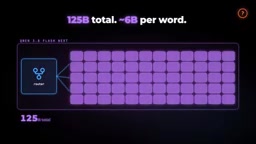
这种架构像一个专家团队藏在单个模型里:总参数约1250亿,但每个词只有约60亿参数被激活。如同拥有数百名医生的医院,你只需要看其中两位。这让模型保持快速且运行成本更低。这是家族配方,不是最终成品——Max的真实配置仍然未知。
混合专家(MoE)架构是一种让模型在推理时只激活部分参数的技术。传统稠密模型对每个输入都会调用全部参数,而MoE将模型拆分成多个“专家”子网络,并由一个路由网络决定每个词或token应该交给哪几个专家处理。这样总参数量可以做得很大,但实际计算量只与激活的专家数量成正比。例如Qwen 3.8 Flash Next总参数约1250亿,但每个词仅激活约60亿参数,从而在保持能力的同时大幅降低推理成本。MoE的挑战在于路由均衡和训练稳定性,但已成为当前大模型扩展的主流方向之一。
开源世界的追问:可下载的模型在哪?
9月,阿里公布了Qwen 4的四个层级,包括Max、Plus、Flash和一个270亿参数的开源模型。到目前为止,只有Max存在,且仅以预览形式。没有开放权重——没有可下载的模型文件。
拥有权重意味着可以在自己的机器上运行模型、定制它、永久保留它。订阅制的预览版做不到这一点。目前也没有简单的按使用量计价方案。
开放权重(Open Weights) 指模型训练完成后,将参数文件公开发布,任何人都可以下载、本地运行、微调甚至再分发。这与仅提供API访问的闭源模型形成对比。开放权重的价值在于:用户数据不出本地、可针对特定领域定制、不受服务商停服或涨价影响。但开放权重不等于开源,因为训练数据、代码和训练过程往往不公开。对于Qwen 4系列,目前只有Max以预览API形式提供,没有开放权重,意味着开发者无法真正拥有或掌控该模型。
开发者当下该怎么做
对于设计师或基础设施开发者,建议很直接:去试用它,但抛出一个真实问题,而不是演示demo。不要在产品上构建依赖——分数缺失、价格模糊、模型几天后就会过期。
一个聪明的做法是:通过标准接口连接模型,这样日后切换只是改一行代码的事。
回到最初的问题:Qwen 4 Max是出色还是更差?目前没人能诚实回答。而这正是真正的教训:基准测试只是一次测试,演示只是一个瞬间,两者都无法展示它如何应对你的实际工作。更好的模型,是那个能可靠地、每次都解决你真实问题的模型。
相关推荐
AI替你写代码,还要学Git吗?五个理由
AI编程代理能自动处理Git操作,还有必要学Git吗?本文提炼五个理由:与团队沟通、审阅代理提交的PR、监督代码改动、在AI宕机时兜底,以及学习本身的乐趣,并分析代理时代Git学习重心的转移。

Anthropic据报以每股83美元定价IPO,估值达1.5万亿美元
Anthropic据报以每股83美元定价IPO,高于预期发行区间,完全稀释估值达1.5万亿美元。本文分析此次定价的信号意义及其对AI行业融资环境的影响。

纳德拉预言:AI代理将重塑网络经济规则
微软CEO纳德拉预测AI代理将重新洗牌网络经济,冲击广告驱动模式,并迫使亚马逊等平台重新思考客户争夺方式。本文解析代理经济对广告、电商与平台竞争逻辑的影响。