Qwen3.8 Flash量化版实测超官方API,本地部署选谁?
实测显示Q4量化版在工程交付场景反超官方API,速度与稳定性成选型关键。
一项针对Qwen3.8 Flash(125B)的对比测试表明,在统一硬件和偏工程交付的评测集下,Anslows UD-Q4量化版的综合得分超过官方Flash API,Swift 1.5的IQ3版垫底。官方API因输出速度仅30-50 token/s,在20分钟限时内大量题目超时交白卷,零分项多达43道;Anslows Q4仅20道零分。剔除超时因素后,Anslows Q4仍略微领先。Q4量化并非全维度降级,UD算法对重要张量保留高精度并做矩阵校准。Swift 1.5速度最快(147.5 token/s)、总耗时最短(6.5小时),但精度牺牲导致得分最低。三个模型均存在子星环循环问题,建议开启循环检测与中断恢复。
本地部署大模型时,量化版和官方API到底选哪个?最近一项针对Qwen3.8 Flash(125B)的对比测试给出了反直觉的答案:Q4量化版在工程交付场景下的综合表现,反而超过了官方原版API。
这位B站UP主使用统一硬件(RTX 5090 32G、96G内存、R7 9800X3D)和自建评测集(803道题、920个执行实例),对比了三个版本:Anslows的UD-Q4量化版、官方Flash API、以及Swift 1.5的IQ3量化版。结果Anslows Q4以微弱优势登顶,官方API屈居第二,Swift 1.5垫底。
评测方法与维度权重
测试采用Qwen3.8 Max作为裁判,思考上限设定为100K token,每道题最长执行时间20分钟。题目分布明显偏向工程交付:编程占17%权重最高,数学12%、判决12%、承诺增强12%。这意味着榜单反映的是“工程任务交付能力”,而非模型全维度能力。
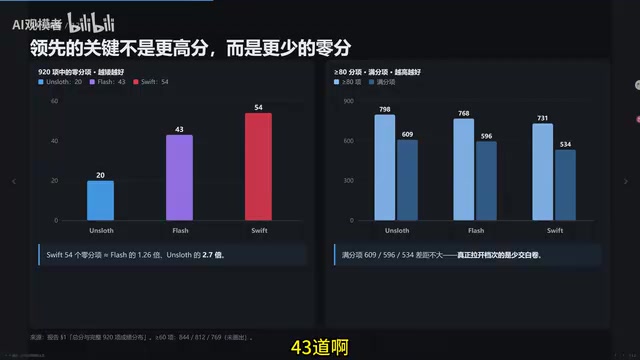
评分采用两种口径——加权总分和平均分,两者排名一致,说明测试具备稳定性。零分项数据更值得玩味:Anslows Q4仅20道题得零分,官方Flash有43道,Swift则高达54道。
推理速度指标:token/s 与端到端耗时
token/s(每秒输出token数)衡量解码阶段的吞吐,受模型大小、量化精度、批处理大小和硬件带宽共同影响。单并发下,官方API的30-50 token/s属于中等水平;多并发下Swift 1.5可达147.5 token/s,说明其批处理调度和算子融合更优。但用户感知更直接的是端到端耗时:20分钟限制内能否完成一道包含多轮思考、工具调用和代码执行的工程题。思考token占比高达95%意味着模型大部分时间在生成内部推理链而非最终答案,这会成倍放大解码速度的差距。因此评估部署方案时,不能只看峰值token/s,还需结合思考预算(thinking budget)和任务超时阈值综合判断。
官方API为何输给量化版?
按常理,官方原版API应该最强,但它的致命伤是速度太慢。Flash版本每秒仅输出30-50个token,在20分钟限制内大量题目无法完成,直接交白卷。UP主在日志中发现,原版思考内容占比高达95%,复杂题反复检查迟迟不进入交付环节。
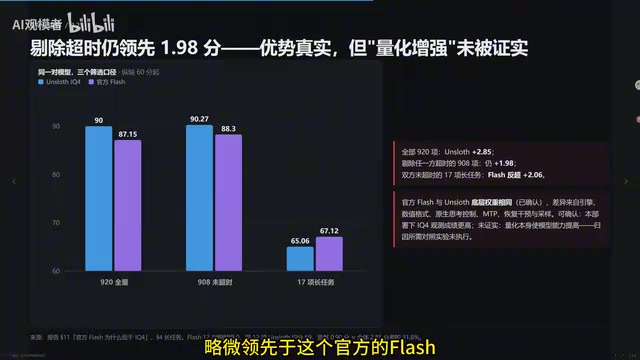
剔除超时因素、只看双方都完成的题目,Anslows Q4仍略微领先。唯一的翻转出现在长任务上——官方原版艰难扳回两分,因为任务越长,原版需要的时间越久,20分钟内很难完成交付。
这引出一个关键认知:Q4量化不等于全维度降级。Anslows的UD算法在量化时对重要张量保留接近原版的精度,仅在不重要模块降低等级,并做了矩阵校准。多位技术博主在实际对比中也难以分辨Q4与FP16的差异。
Q4量化与QD(量化降级)的基本原理
大模型量化是将浮点权重(如FP16/BF16)压缩为低比特整数(如4比特)以降低显存占用和加速推理的技术。Q4指权重平均位宽约4比特(如INT4或NF4),Q3约3比特。粗暴的逐张量均匀量化会显著损失精度,尤其对注意力层和FFN中的关键矩阵。UD(Unified Distillation)是一种混合精度量化算法:先通过敏感度分析识别对输出影响大的张量(如注意力输出投影、MLP的下投影),对其保留8比特甚至FP16精度;对不敏感模块(如部分嵌入层或浅层MLP)降至4比特,并引入矩阵校准(如GPTQ或AWQ的校准方式)补偿量化误差。因此Q4并非全维度降级,在高敏感路径上精度接近原版,这是Anslows UD-Q4能在工程任务中与官方FP16/FP8 API打平甚至略胜的前提。
速度、稳定性与成本的真实差距
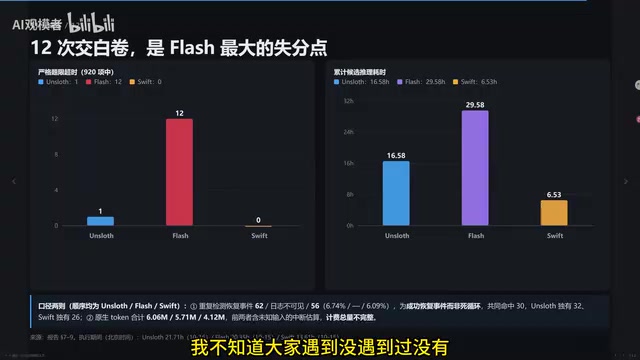
Swift 1.5在速度上优势明显:多并发下可达147.5 token/s,Anslows约90 token/s,官方Flash单并发仅53.8 token/s。完成全部测试的耗时差距更夸张——Swift仅6.5小时,Anslows 16.5小时,官方Flash 29.58小时,接近后者的5倍。
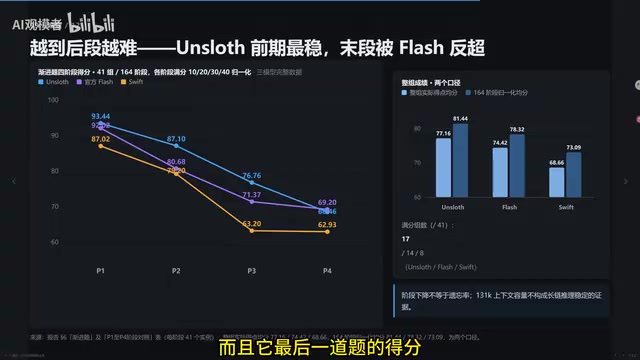
三个模型均出现“子星环”问题(长输入或长输出时陷入循环),Anslows检测到60余次,Swift约50次。目前框架已加入循环检测与中断恢复机制,建议用户在设置中开启。
“子星环”循环问题
“子星环”是社区对长上下文或长输出场景下模型陷入重复生成循环的俗称(类似复读机现象),表现为模型反复输出相同短语、步骤或代码块,无法收敛到终止符。诱因包括:量化误差导致注意力分布偏移、位置编码外推不稳定、训练数据中长尾模式被过度拟合,以及采样参数(如重复惩罚不足)设置不当。检测手段通常包括n-gram重复率监控、输出熵骤降告警和最大生成长度硬截断。中断恢复机制则在检测到循环后强制插入终止提示或回滚到上一检查点重新生成。对于本地部署,建议将重复惩罚调至1.05-1.15,并设置合理的max_new_tokens,以降低循环概率。
选型建议:按硬件和耐心对号入座
追求综合交付质量且硬件够用:首选Anslows UD-Q4。量化质量高,得分领先,速度可接受。
不想等、要快、能接受Q3精度:Swift 1.5是合理选择。83.62分虽低于另外两者,但对比27B模型仍有明显领先,且速度快、输出简短、耗时最短。
官方原版API:除非你愿意为中等或长任务等待一两个小时,且不介意付费,否则不推荐——又慢又花钱。
这套测试的口味偏向工程交付和推理,不能代表模型全部能力。但对于想在12G显卡上跑125B模型的用户来说,它提供了一个务实的选择框架:量化版未必是妥协,官方API也未必是终点。
相关推荐

AI数字分身实战:用DOT自动追踪Bug与用户反馈
DOTS 团队工程师演示如何用 AI 数字分身 DOT 跨平台收集用户反馈、自动归类问题主题、开线程调查 Bug 根因并直接提交 PR,展示 AI 代理参与缺陷分诊的完整工作流与可审计设计。

晶体管为何不再扁平?从平面到环绕栅极的演进
晶体管从平面到FinFET再到环绕栅极的演进:为何栅极需要从三面包裹到四面环绕,以抑制短沟道效应和泄漏电流,延续摩尔定律。

蜂群思维=单个RL智能体?多臂老虎机等价性证明
一篇论文证明蜂群通过局部模仿进行的集体决策,在数学上等价于单智能体强化学习。N个盲目模仿者相当于N个并行环境采样,有效学习率为1/N。本文解读Maynard-Cross Learning算法的推导与影响。