Qwen携手Cerebras:实用AI如何加速解决现实问题
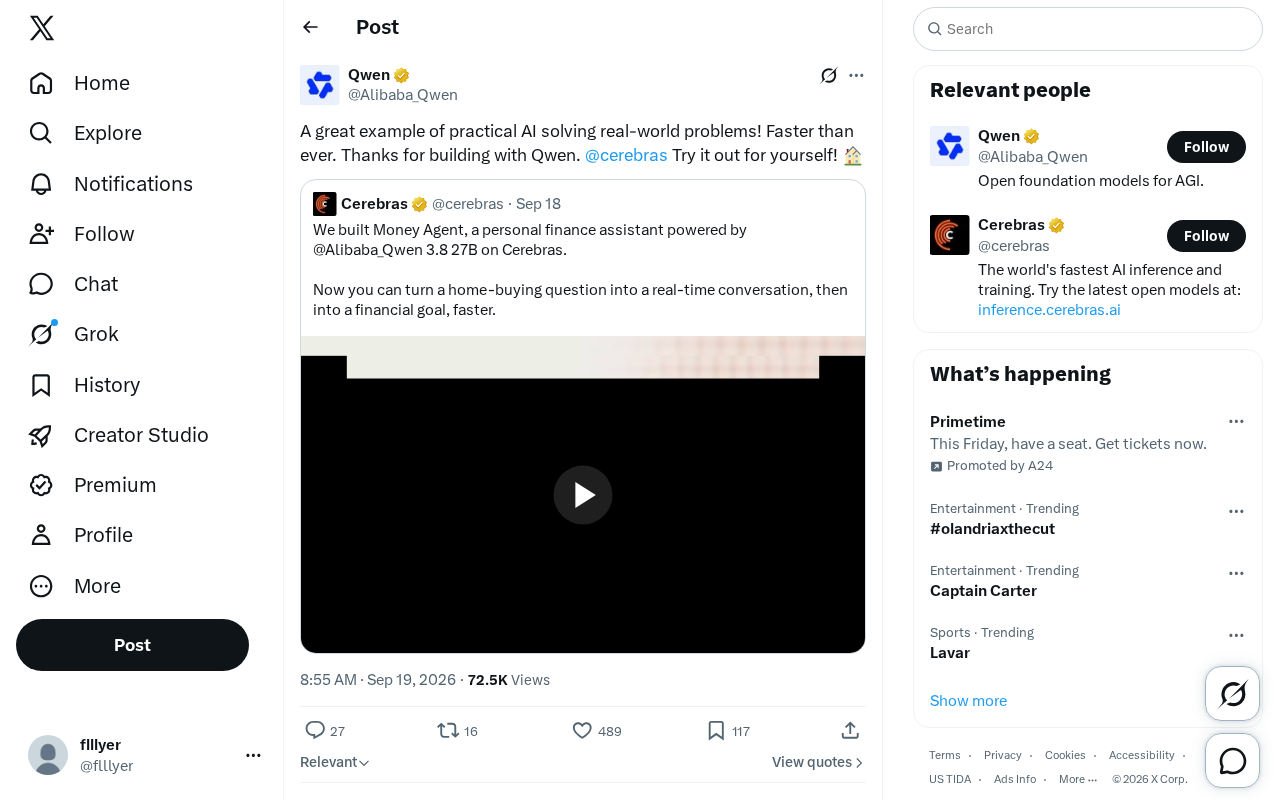
开发者结合Qwen开源模型与Cerebras专用推理硬件,打造出「快得前所未有」的实用AI应用,展示了模型+硬件+场景的落地新路径。
一条来自社区的推文展示了将阿里开源大模型Qwen与Cerebras晶圆级推理芯片结合构建实用AI应用的案例,被誉为「实用AI解决现实问题的绝佳范例」。文章以此为切入点,分析了当前AI落地的核心趋势:模型能力已不是主要瓶颈,真正决定AI能否嵌入日常场景的,是推理速度与部署成本。Qwen提供了开放权重、多语言支持的模型底座,Cerebras以晶圆级引擎大幅压缩响应延迟,两者结合让「跑得动」升级为「跑得快」。文章认为,「模型+硬件+场景」的协作模式将成为AI应用规模化的典型路径,开发者应关注这一方向。
一条推文背后的信号
近日,一条来自社区的推文引发关注:某开发者展示了基于 Qwen 模型、结合 Cerebras 硬件加速构建的实际应用,并称其为「实用AI解决现实问题的绝佳范例」,运行速度「前所未有地快」。
虽然这只是一条简短的分享,但它折射出当前 AI 落地的一个重要趋势:模型能力与专用推理硬件的结合,正在把「跑得动」变成「跑得快」,进而让 AI 真正嵌入日常场景。需要说明的是,本文基于该单一推文素材撰写,具体应用细节原文并未展开。
Qwen 模型的开放生态
Qwen(通义千问广告系列)作为阿里推出的开源大模型家族,近年来在开发者社区中积累了大量拥趸。其开放权重、覆盖多种参数规模、支持多语言与代码任务的特性,使它成为构建实际应用的常见底座。
推文中「Thanks for building with Qwen」的表述,正体现了开源模型的价值所在——开发者可以基于它自由构建产品,而不必受限于封闭 API。这种开放性降低了创新门槛,让「解决现实问题」的应用能够快速涌现。
Qwen 系列模型由阿里巴巴达摩院推出,覆盖从 0.5B 到 72B 的多种参数规模,并衍生出专注代码的 Qwen-Coder、专注数学的 Qwen-Math 以及多模态的 Qwen-VL 等子系列。模型权重以 Apache 2.0 或类似协议发布在 Hugging Face 和 ModelScope 上,允许商业使用,这一授权策略使其在开源社区的采用率迅速上升。与 Llama 系列相比,Qwen 在中文理解与生成上有明显优势,同时在多语言基准测试中也保持了较强的竞争力,因此在全球开发者中均有一定的用户基础。
Cerebras 带来的速度优势
推文特别提到了 @cerebras,并强调「Faster than ever」。Cerebras 以其晶圆级引擎(Wafer-Scale Engine)著称,在大模型推理速度上一直是行业中被讨论的焦点之一。
将 Qwen 这类开源模型部署在 Cerebras 的推理平台上,理论上能够显著降低响应延迟。对于面向用户的实时应用而言,速度不仅是体验问题,更直接决定了 AI 能否被真正用起来。一个需要等待数秒才响应的助手,与一个近乎即时反馈的助手,落地效果天差地别。
Cerebras 的晶圆级引擎(Wafer-Scale Engine,WSE)是其核心技术差异点。传统 GPU 芯片面积通常在 800mm² 以内,受限于光刻良率,多颗芯片之间需要通过 PCIe 或 NVLink 互联,跨芯片通信带来的延迟和带宽瓶颈在大模型推理场景下尤为明显。Cerebras 则将整块 300mm 晶圆直接制成单一处理器,其第二代 WSE-2 拥有 2.6 万亿个晶体管和约 40GB 片上 SRAM,内存带宽远超 GPU 集群方案。大模型推理的瓶颈往往不在于算力,而在于将模型权重从显存搬运至计算单元的带宽,WSE 的超大片上内存恰好消除了这一瓶颈,使 token 生成速度可以达到 GPU 方案的数倍乃至数十倍。
为什么「实用」比「强大」更重要
这条推文用了「practical AI」而非「powerful AI」的措辞,值得玩味。当下大模型的能力已经足够强,但真正制约其价值兑现的,往往是能否稳定、快速、低成本地服务于具体场景。
模型能力、推理硬件、应用场景三者的组合,才是 AI 落地的完整拼图。Qwen 提供了开放且能力过硬的模型底座,Cerebras 提供了极致的推理速度,开发者则负责把它们对准一个真实需求。这种「模型+硬件+场景」的协作模式,或许正是未来 AI 应用规模化的典型路径。
小结
受限于原始素材,我们无法得知这个应用具体解决了什么问题、面向哪类用户。但它传递的方向清晰:开源模型正在与专用推理硬件深度结合,把 AI 的可用性推向新高度。对开发者而言,这也是一个值得亲自「Try it out」的信号。
相关推荐
临床AI治理难题:Concurrence如何用Unity Gateway管控万亿Token规模
临床AI几乎没有容错空间。本文解析 Concurrence 如何借助 Unity Gateway 在万亿Token规模下治理医疗AI,实现访问控制、合规审计与可观测性的统一,探讨医疗AI规模化落地的治理路径。
让轮询 Agent 真正 7×24 运行:从会话内定时到外部调度
轮询 Agent 只在笔记本会话开着时才运行?本文解析如何用 cron、systemd timer、Task Scheduler 等外部调度器让 Agent 真正 7×24 运行,并通过硬性超时、错误退避与心跳告警避免静默失败。
幂等键难题:如何处理API重试中的“僵尸进程”
发送邮件不是幂等操作,API 重试时如何避免重复发送?本文剖析基于幂等键的抢占声明机制,以及进程崩溃导致“死亡持有者”这一分布式系统经典难题的权衡与解决思路。