RAG-CSI:用检索增强Transformer预测信道状态
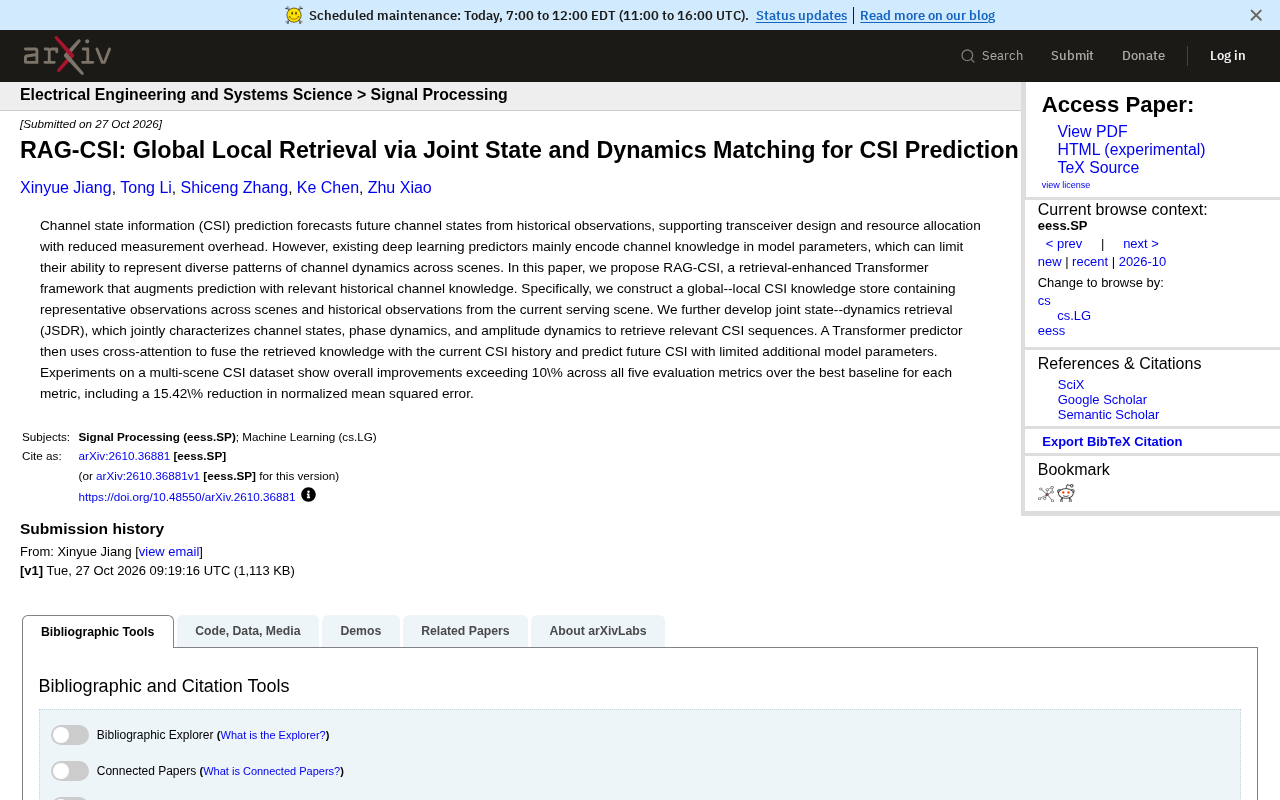
RAG-CSI 用检索增强与两级知识库突破纯参数化 CSI 预测的跨场景局限。
文章介绍了一篇将检索增强生成(RAG)引入信道状态信息(CSI)预测的新论文 RAG-CSI。作者指出,传统深度学习预测器把信道规律固化在模型参数中,难以灵活表征不同场景下的信道动态。RAG-CSI 构建全局—局部两级 CSI 知识库,并在预测时通过联合状态—动态检索(JSDR)同时匹配信道状态、相位动态与幅度动态,检索出的参考序列再由 Transformer 以交叉注意力与当前历史融合,仅增加有限参数。多场景数据集实验显示,五项指标整体提升超过 10%,NMSE 降低 15.42%。文章认为这为无线通信机器学习提供了把信道知识外置为可检索存储的可复用思路,同时指出知识库构建成本、跨场景检索稳定性与检索效率等局限尚待展开。
信道状态信息(CSI)预测是无线通信中的关键任务——它通过历史观测推断未来信道状态,从而降低测量开销、辅助收发机设计与资源分配。现有深度学习方案大多把信道知识“腌”进模型参数里,这导致模型难以灵活表征不同场景下信道动态的多样模式。一篇新论文提出的 RAG-CSI 框架,尝试用检索增强生成(RAG)的思路解决这一瓶颈。
问题:参数化编码的局限
信道具有强场景依赖性:不同传播环境下的多径结构、相位变化和幅度波动模式差异显著。传统深度学习预测器在单一或有限场景上训练,靠参数固化信道规律,一旦场景切换,模型往往需要重新训练或大量微调。
RAG-CSI 的作者指出,这种“知识全在参数里”的范式限制了模型对跨场景信道动态的表征能力。换句话说,模型缺少一个可动态调用的外部知识源。
信道状态信息(CSI) 是无线通信系统对收发机之间无线传播信道特性的数字化描述,通常包含每个子载波上的幅度与相位响应(在 MIMO-OFDM 系统中则是一个复数矩阵)。接收端通过导频信号估计 CSI,再将其反馈给发送端,用于预编码、波束赋形、自适应调制与资源调度。CSI 的准确性直接决定系统容量与可靠性,但频繁测量与反馈会带来显著的导频开销和上行信令负担。因此,CSI 预测——利用历史 CSI 序列推断未来若干个时刻的信道状态——成为降低开销的关键手段:若预测足够准确,就可以减少导频密度或反馈频率,同时为发送端提供前瞻性的调度依据。信道预测的难点在于无线信道同时具有时变性和场景依赖性,多径、多普勒与遮挡使未来状态既受确定性趋势支配,也含随机成分。
方法:全局—局部知识库与联合检索
RAG-CSI 的核心是构建一个全局—局部 CSI 知识库:全局部分收录跨场景的代表性观测,局部部分则来自当前服务场景的历史观测。预测时,模型从两个层级中检索与当前信道相关的历史序列,作为“参考样本”注入预测过程。
检索环节的关键设计是联合状态—动态检索(JSDR)。它不只看信道状态的相似性,还同时刻画相位动态与幅度动态,从而检索出在“状态”和“变化趋势”两个维度都匹配的 CSI 序列。这比单纯的状态匹配更贴合信道预测的需求——预测关心的正是未来的动态走向。
预测器:交叉注意力融合
检索到的知识序列随后交由 Transformer 预测器处理,通过交叉注意力机制与当前 CSI 历史融合,输出未来信道状态。作者强调,这种融合方式只引入有限的额外模型参数,却显著扩展了模型可用的信息面。
检索增强生成(RAG) 最初面向自然语言处理提出:模型在生成答案前,先从外部文档库中检索与问题相关的片段,再将这些片段作为上下文送入生成模型。其核心动机是把知识从模型参数中解耦出来,使模型无需重新训练即可访问最新或领域特定的信息,同时降低幻觉。RAG 一般包含检索器(常基于稠密向量相似度)与生成器两部分,检索质量与知识库覆盖度共同决定最终效果。将这一范式迁移到无线通信物理层时,“文档”变成了历史 CSI 序列,“语义相似度”则需替换为对信道状态与动态演化规律的匹配——这正是 RAG-CSI 需要重新设计检索准则的原因。
交叉注意力(cross-attention) 是 Transformer 中的一种注意力机制:以一路序列作为查询(query),另一路序列提供键(key)和值(value),从而让前者有选择地从后者中聚合信息。与自注意力不同,交叉注意力的两路输入来源不同,因此天然适合“当前观测”与“外部检索知识”之间的融合。在 CSI 预测中,当前历史序列生成 query,检索到的参考 CSI 序列生成 key 和 value,模型据此决定在哪些时刻、哪些维度上借鉴参考样本的动态模式。相比把检索结果直接拼接或取平均,交叉注意力能够按内容自适应地加权,并且只需增加少量投影矩阵,参数开销可控。
实验结果
论文在一个多场景 CSI 数据集上进行了验证。结果显示,在五项评估指标上,RAG-CSI 相对各指标的最佳基线均有超过 10% 的整体提升,其中归一化均方误差(NMSE)降低了 15.42%。这一幅度在 CSI 预测任务中相当可观,说明检索增强确实带来了参数化模型之外的信息增益。
归一化均方误差(NMSE) 是 CSI 预测与信道估计中最常用的精度指标,定义为预测值与真实值之差的平方范数除以真实值平方范数,通常以 dB 表示。它对信道整体能量做了归一化,因此不同场景、不同接收功率下的结果可以横向比较;数值越低(越负的 dB 值)表示预测越准确。需要注意的是,NMSE 的百分比降幅在低误差区间往往对应更大的实际难度提升,因此“降低 15.42%”应结合基线的绝对 NMSE 水平来解读,并配合其他指标(如相位误差、余弦相似度)综合判断预测质量。
值得关注的信号
RAG 从语言模型领域向无线通信物理层任务迁移,是近期一个值得留意的趋势。RAG-CSI 的贡献在于把“检索什么”和“如何匹配”做了更细粒度的设计——状态与动态联合匹配,而不是简单按相似度取 Top-K。
局限同样存在:全局知识库的构建成本、跨场景迁移时检索质量的稳定性,以及知识库规模增长后的检索效率,论文摘要未作展开。多场景数据集的具体构成与基线选择也需结合全文进一步判断。
对于从事无线通信机器学习研究的读者,这项工作提供了一个可复用的思路:把信道知识外置为可检索的存储,而非全部压进网络权重。
相关推荐
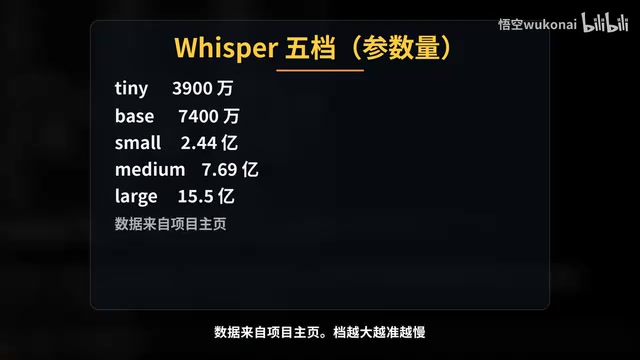
Claude Code实战:零代码搭建切片工厂,长视频自动变竖屏短视频
B站UP主悟空用Claude Code零代码搭建切片工厂,将35分钟长视频自动切成10条竖屏短视频。从Plan Mode、Whisper转写、claude.md规则、Hook质检到Subagent审核和Plugin分发,完整实战流程与实测数据。
WorkBuddy保姆级教程:AI Agent如何帮你自动转文件
WorkBuddy保姆级教程实战:从豆包只能给方案到AI Agent直接动手,三分钟批量转换PDF并归档。含安装、积分机制、与Codex对比及上手建议。
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。