RAG框架如何破解隐性厌女检测难题?
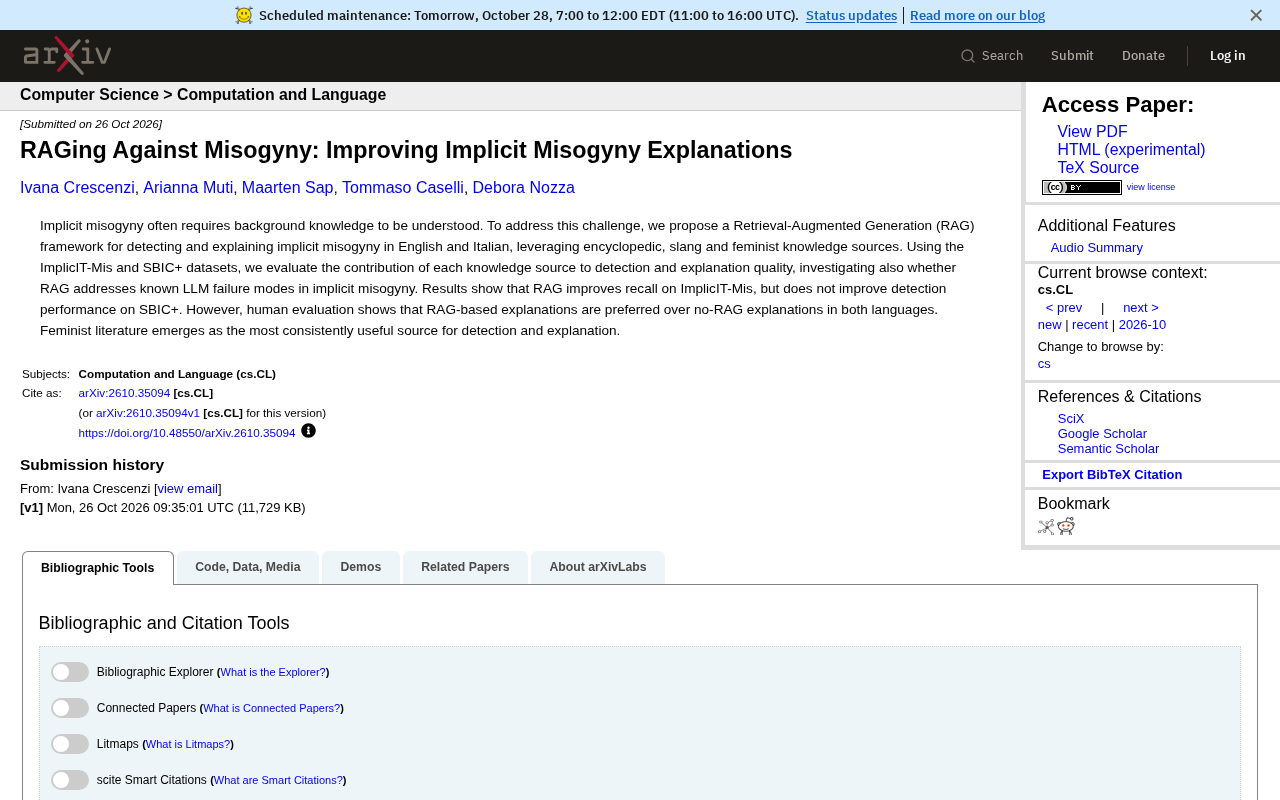
研究用RAG检测隐性厌女,发现检测增益因数据集而异,但解释质量稳定提升。
一项研究构建了整合百科、俚语和女性主义知识的RAG框架,用于检测和解释英语与意大利语中的隐性厌女。在ImplicIT-Mis数据集上,RAG提升了召回率,能捕捉更多隐蔽案例;但在SBIC+数据集上检测性能未改善,说明RAG效果高度依赖数据集特性。人工评估则显示,两种语言中基于RAG的解释均比无RAG更受青睐,可解释性收益明确。研究最稳健的发现是女性主义文献在检测和解释两个环节均最稳定有效,因其提供批判性框架而非仅事实或语言解码。研究提示RAG并非万能,知识源的选择本身包含价值判断,批判性视角对隐性偏见检测尤为关键。
隐性厌女(implicit misogyny)往往需要背景知识才能被识别——一句看似无害的调侃、一个网络流行梗,背后可能隐藏着对女性的贬损。传统大语言模型在处理这类内容时,常因缺乏语境而漏判或解释不当。一篇最新研究提出用检索增强生成(RAG)框架来检测并解释英语和意大利语中的隐性厌女,引发了对RAG实际效能的重新审视。
研究设计:三种知识源与两个数据集
该研究构建的RAG框架整合了三类知识源:百科知识、俚语知识以及女性主义知识。团队使用ImplicIT-Mis和SBIC+两个数据集,分别评估每种知识源对检测和解释质量的贡献,并探究RAG是否解决了LLM在隐性厌女任务上的已知失败模式。
这一设计的关键在于,它没有把RAG当作万能药,而是拆解了不同知识源的实际作用。对于隐性厌女这种高度依赖文化语境的任务,单一知识库往往力有不逮——百科能提供事实背景,俚语库能解读网络用语,女性主义文献则提供批判性视角。三者叠加,才能覆盖从字面到深层含义的完整光谱。
检索增强生成(RAG) 是一种将外部知识检索与语言模型生成相结合的技术架构。其核心流程是:给定输入查询(如待检测的文本),系统先从外部知识库中检索出相关文档片段,再将这些片段作为上下文与原始输入一同送入大语言模型,让模型基于检索到的依据进行判断或生成解释。RAG 的价值在于弥补模型参数化知识的局限——模型无需在训练时记住所有背景知识,而是可以在推理时动态获取。这使得 RAG 特别适合需要时效性、领域专精或文化语境的任务。不过,RAG 的效果高度依赖检索质量与知识库覆盖度,若检索到的内容不相关或知识源本身存在偏差,反而可能引入噪声。
隐性厌女(implicit misogyny) 指不包含直接侮辱词汇、但通过暗示、预设、刻板印象或权力关系贬低女性的表达。它与显性厌女(如直接辱骂)的区别在于:其识别高度依赖共享的文化背景、网络亚文化知识和批判性视角。例如,某些网络梗表面中立,实则承载对女性外貌、能力或角色的贬损预设。这类内容对传统模型构成挑战,因为模型需要判断的不仅是字面语义,还包括言外之意和意图。
检测效果:有提升,但并非全线告捷
实验结果呈现出分化的图景。在ImplicIT-Mis数据集上,RAG提升了召回率(recall),意味着模型能捕捉到更多此前遗漏的隐性厌女案例。但在SBIC+数据集上,RAG并未改善检测性能。
这种不一致说明,RAG的效果高度依赖数据集特性与任务设定。SBIC+的样本可能本身语境线索更充分,或者其标注标准与RAG检索到的知识之间存在错位。研究没有回避这一负面结果,反而将其作为核心发现呈现——RAG不是银弹,它在检测环节的增益是有条件的。
有意思的是,召回率的提升在隐性厌女场景中具有特殊意义。漏判(false negative)意味着有害内容被放行,其社会成本远高于误判。RAG在ImplicIT-Mis上改善召回,至少指向了一个有价值的方向:通过外部知识补全语境,让模型更少地“视而不见”。
召回率(recall) 是分类任务中的核心评估指标,定义为在所有真实正例中被模型正确识别出的比例。在隐性厌女检测中,召回率高意味着模型漏掉的厌女内容少。与之相对的是精确率(precision),即模型判定为厌女的内容中真正属于厌女的比例。两者常存在权衡:提高召回率可能以降低精确率为代价。在内容审核场景中,漏判(假阴性)让有害内容流入社区,其社会危害通常被认为大于误判(假阳性)导致的正常内容被误删,因此召回率往往是更受关注的指标。RAG 在 ImplicIT-Mis 上提升召回率,说明检索到的外部知识帮助模型补全了语境,使更多隐蔽案例被识别出来。
解释质量:人类评估给出明确偏好
尽管检测性能表现分化,解释质量的结果却相当一致。人工评估显示,在英语和意大利语两种语言中,基于RAG的解释均比无RAG的解释更受青睐。
这一发现的意义在于,隐性厌女的危害不仅在于内容本身,还在于其隐蔽性——如果模型只能给出“这是厌女”的结论而无法说明理由,用户难以信服,也无法据此进行内容治理。RAG提供的解释之所以更受偏好,很可能是因为它能够引用具体的知识依据,把“为什么这句话有问题”讲清楚。对于平台审核、教育场景而言,可解释性有时比单纯的检测准确率更具实用价值。
女性主义文献:最稳定的知识源
研究中最稳健的发现是:女性主义文献在检测和解释两个环节中都是最 consistently useful 的知识源。
这个结果耐人寻味。百科知识提供的是中性事实,俚语知识解决的是语言解码,而女性主义文献直接提供了批判性框架——它不只告诉模型“这个词是什么意思”,还告诉模型“这种表述为何构成贬损”。对于隐性厌女这种需要判断意图和权力关系的内容,批判性视角的缺失恰恰是传统模型失败的关键。
这也提示了一个更广泛的启示:在涉及社会偏见检测的任务中,知识源的选择本身就是一种价值判断。把女性主义文献纳入检索库,不是中立的工程决策,而是对“什么算作有效知识”的重新定义。
对RAG应用的启示
这项研究对当前热衷RAG落地的开发者有几层提醒。其一,RAG的收益因任务和数据集而异,不能假设“加检索就一定更好”,需要在目标场景上做实证验证。其二,知识源的质量和视角比数量更重要——三类知识源中,只有女性主义文献表现出了跨任务的稳定性。其三,解释质量与检测性能可以脱钩,当检测指标停滞时,RAG仍可能在可解释性维度创造价值。
隐性厌女的检测本质上是一个语境补全问题,而RAG恰好提供了补全语境的机制。但补什么、从哪补,决定了补全的效果。这项研究给出的答案并不完美,却足够诚实:RAG有用,但用对知识源才有用。
ImplicIT-Mis 与 SBIC+ 是本研究使用的两个数据集,它们的设计目标与数据特性不同。ImplicIT-Mis 是专门针对隐性厌女构建的数据集,覆盖英语和意大利语,样本往往缺乏显性线索,需要背景知识才能判断,因此对 RAG 的语境补全能力更为敏感。SBIC+(Social Bias Inference Corpus 的扩展版本)则是一个更广泛的社会偏见数据集,涵盖多种偏见类型,其样本可能包含更丰富的上下文或更明确的标注线索。两个数据集在任务设定、标注标准和语境充分度上的差异,解释了 RAG 效果分化的原因:当数据集本身语境线索充足时,外部检索的边际收益降低;当标注标准与检索知识错位时,RAG 甚至可能无增益。这提示研究者在评估 RAG 时必须明确数据集特性,不能将单一数据集上的结论泛化。
相关推荐

Asana AI产品负责人分享AI Agent最佳实践
Asana AI产品负责人分享AI Agent最佳实践,涵盖职责边界设定、人在回路设计、数据模型锚定以及评估迭代方法,为产品团队落地Agent提供可参考的原则。

日本互联网巨头GMO遭黑客泄密:云服务漏洞致客户数据外泄
日本GMO Internet证实云服务遭黑客攻击,客户数据疑被公开。公司正核实泄露数据真实性,事件凸显云服务安全风险与供应链攻击威胁。

苹果为Pages、Keynote、Numbers加入AI助手
苹果为Keynote、Pages、Numbers引入AI助手,基于苹果与OpenAI模型,可理解文档上下文,在Keynote中设计动画幻灯片、在Pages中起草和重构文档,生产力套件AI竞争升级。