RAG中的Embedding模型详解:从知识库构建到相似度检索全流程

本文梳理RAG工作原理,揭示Embedding模型在检索链路中的核心地位及垂直领域微调的价值。
RAG(检索增强生成)通过在大模型回答前先检索外部向量知识库,将"闭卷考试"变为"开卷考试",有效解决模型知识过时和领域细节缺失的问题。整条链路分为两个阶段:离线阶段将原始文档分块后经Embedding模型转为向量存入数据库;在线阶段将用户query同样转为向量,与库中向量计算相似度,取top-k相关文档拼接成提示词交给大模型生成回答。Embedding模型在这两个阶段均发挥关键作用,其向量表示的质量直接决定检索相关性,进而决定最终回答质量。文章指出,针对垂直领域语料微调Embedding模型,使领域相关文本在向量空间中更聚拢、无关文本更疏远,是提升RAG整体表现的高性价比优化手段,也是后续实战的核心主题。
检索增强生成(RAG)正在成为大模型落地企业场景的主流方案。它让大语言模型在回答问题时不再仅凭训练时的记忆,而是能够参考外部知识库中的资料,把一场“闭卷考试”变成“开卷考试”。而在整条链路里,Embedding 模型往往是决定检索质量、也最容易被忽视的关键环节。本文基于B站一场RAG实战讲解内容,梳理Embedding模型在RAG中的工作机制与优化思路。
RAG 到底解决了什么问题
大语言模型的核心能力是接收用户问题(user query)并给出答案。但纯粹依赖模型内部参数,容易出现知识过时、缺乏领域细节甚至“一本正经胡说八道”的问题。
RAG 的思路很直接:在模型回答之前,先从一个基于知识的向量数据库(knowledge base as a vector database)中,检索出与用户问题相关的资料,作为上下文(context)一并交给模型。这样模型不仅拿到了问题本身,还拿到了相关的参考资料,回答自然更准确。
讲解中打了一个很形象的比方:这相当于把闭卷考试变成开卷考试,模型甚至可以直接从上下文提供的资料里找到准确答案再作答。这也解释了为什么 RAG 在企业知识问答、文档助手等场景中被广泛采用。
知识库是怎么构建出来的
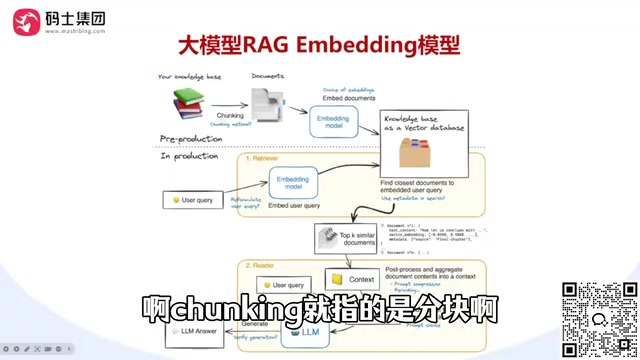
要让模型“开卷”,前提是先准备好那本“书”,也就是向量知识库。这个过程分几步走:
首先需要原始数据(raw text),通常是大量文本文档、书籍等非结构化内容。这些内容不能整块直接使用,需要经过 chunking(分块/切片) 处理,切成一段段较小的文本片段,讲解中称之为 documents。
分块之后,每一段文本被送入 Embedding 模型。Embedding 模型做的事情非常单一而关键——把纯文本的一段段内容,转换成向量(vector)。转换完成后,这些向量就被存入向量数据库中。
值得说明的是,向量数据库本身有很多种选择,但 Embedding 模型只负责“文本转向量”这一步,至于存到哪个数据库,是相对独立的工程选择。这一整套流程属于前期准备工作,只有把知识库建好,后续的检索才有基础。
分块策略本身对检索质量有显著影响,值得稍加说明。常见的分块方式包括:按固定字符数切割、按句子或段落边界切割、以及带有重叠窗口(overlap)的滑动切割。重叠切割的意义在于,一段完整的语义往往跨越两个相邻块的边界,若切割太硬,检索时可能两块都匹配不上。通常实践中会保留相邻块之间 10%–20% 的重叠内容,以减少信息碎片化。块的大小(chunk size)也是一个需要权衡的超参数:块太小则单段语义不完整,块太大则噪声多且占用的上下文窗口更长,增加推理成本。
检索与拼接:Embedding 的第二次登场
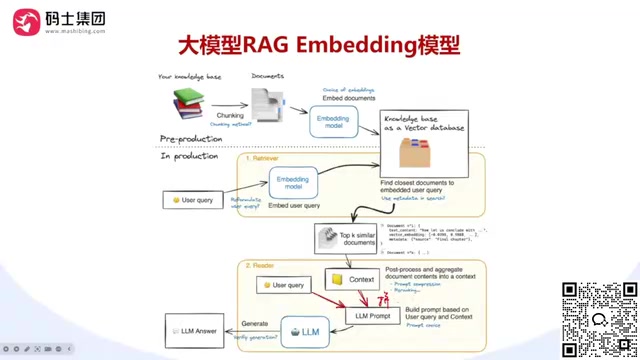
真正使用时,流程与构建阶段呈镜像关系。用户提出问题后,系统并不会立即把问题丢给大模型,而是先做一次检索。
用户的 query 本质上也是一段文本,同样会先经过 Embedding 模型,被转换成一个向量(讲解中记作 factor A)。接着,这个向量会与数据库中已经存好的所有向量(factor 1 到 factor N)逐一计算相关性,也就是求相似度。
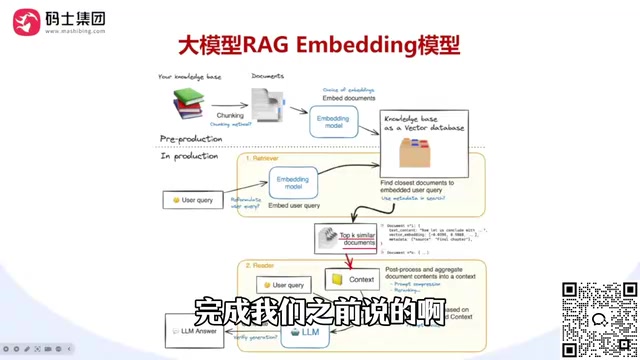
计算完成后,系统取出相似度最高的前 K 个文档,即 top-k similar documents。这些最相关的文档就作为 context,与用户的 query 拼接在一起,构成大语言模型的输入——用一个更漂亮的词说,就是 prompt(提示词)。
最后,大模型拿到这段拼接好的提示词,既包含用户问题,也包含检索出的参考资料,从而给出更丰富、更准确的回答。可以看到,Embedding 模型在整个 RAG 流程中出现了两次:一次在离线构建知识库时,一次在在线检索时,两次的目标一致——把文本映射到同一个向量空间。
相关性是 RAG 效果的生命线
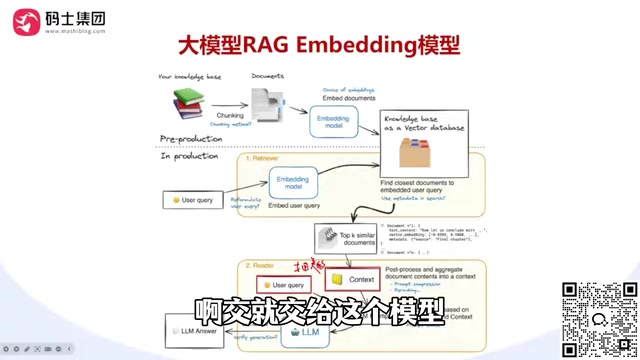
讲解中反复强调了一点:检索出来的 context 一定要和用户的 query 尽可能相关。
如果检索到大量“八竿子打不着”的无关资料,这些内容对模型来说不是帮助,而是噪声。噪声越多,模型越容易被干扰,回答质量反而下降。因此,找到相关的文档,是决定 RAG 效果的关键。
而“相关性”的判断,最终落到了向量之间的相似度计算上。两个向量(比如 factor A 和 factor E)之间是否相关,取决于它们在向量空间中的距离或夹角关系。这也自然引出了一个更深入的问题:向量究竟以什么形式存在?文本转成向量之后到底变成了什么样子?
这正是理解 Embedding 微调的起点——只有搞清楚向量的本质与相似度的计算方式,才能明白为什么在特定领域数据上微调 Embedding 模型,能够显著提升检索命中率。
向量相似度最常用的计算方式有两种:余弦相似度(Cosine Similarity) 和 点积(Dot Product)。余弦相似度衡量两个向量夹角的余弦值,范围在 -1 到 1 之间,结果与向量的模长无关,只看方向是否一致,因此对文本长短不敏感,是文本检索中最主流的选择。点积则同时受方向和模长影响,若向量已经过 L2 归一化(模长统一为 1),点积与余弦相似度等价。此外,也有基于欧氏距离(L2 距离)的检索方案,距离越小代表越相似。不同向量数据库和 Embedding 模型对这几种方式的支持程度不同,选型时需要确认模型训练时使用的相似度目标函数与检索时使用的度量方式保持一致,否则会出现系统性偏差。
为什么 Embedding 值得单独优化
在很多 RAG 实践中,工程师往往把大量精力放在提示词工程和大模型选型上,却直接套用通用的 Embedding 模型。但从上面的流程可以看出,如果 Embedding 模型对领域文本的向量表示不够准确,检索这一步就会“选错资料”,无论后续大模型多强,都难以补救。
针对垂直领域(如医疗、法律、金融)的语料对 Embedding 模型做微调,让相关文本在向量空间中更靠近、无关文本更疏远,正是提升 RAG 整体表现的高性价比手段。这也是该讲解将 Embedding 微调作为实战主题的原因所在。
本文梳理的是 RAG 与 Embedding 的基础机制部分,向量的具体形式、相似度算法以及微调的实操细节,是进一步深入的方向。理解了这套“文本→向量→相似度→检索→拼接→生成”的完整链路,再去做微调优化,才能有的放矢。
Embedding 模型的微调通常采用对比学习(Contrastive Learning) 框架,核心思想是构造"正样本对"(语义相关的句子对)和"负样本对"(语义无关的句子对),通过训练让模型在向量空间中拉近正样本、推开负样本。常用的损失函数包括 InfoNCE Loss 和 Multiple Negatives Ranking Loss。在垂直领域场景下,正样本对往往来自领域文档中的问答对、同一段落的不同改写,或人工标注的相关文档对。负样本的构造质量对微调效果影响极大——随机采样的"简单负样本"容易导致模型收敛过快但泛化不足,引入"难负样本"(hard negatives,即语义相近但实际无关的文本)才能真正提升模型在领域检索中的区分能力。
相关推荐
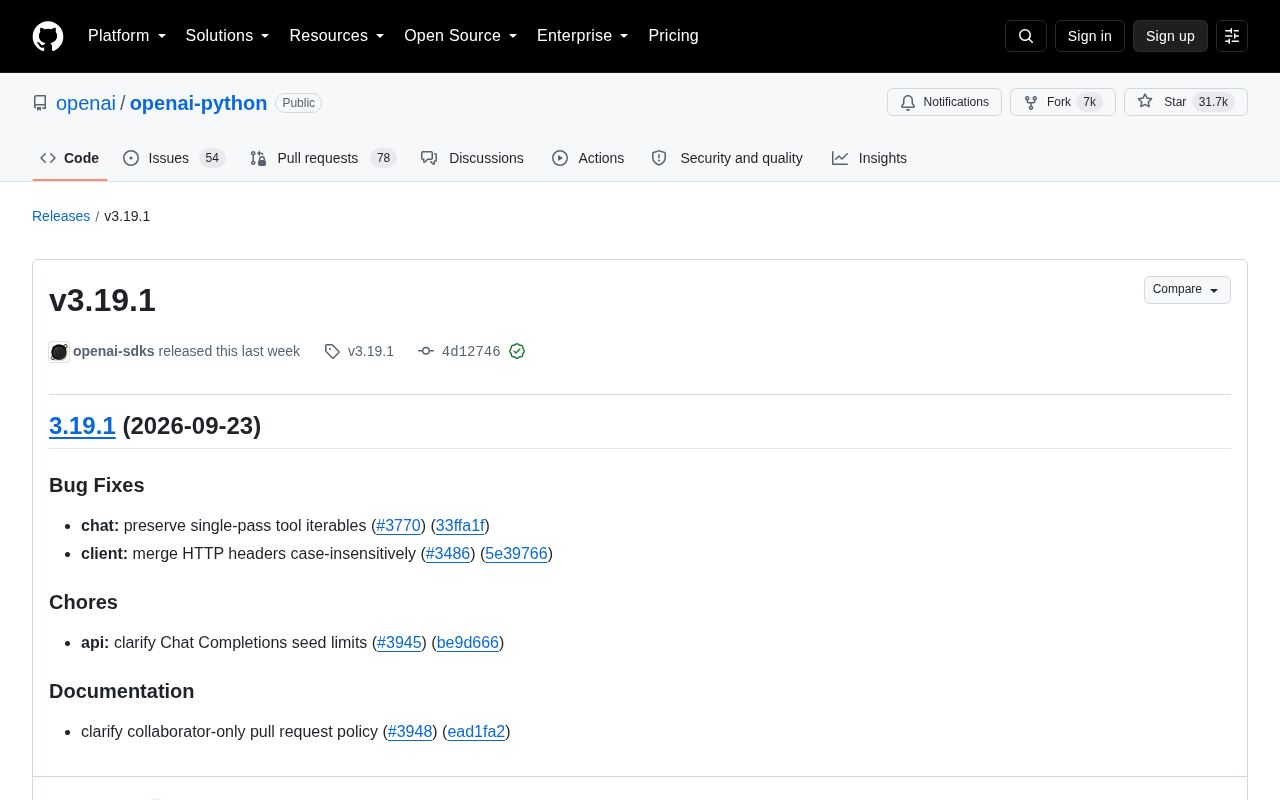
OpenAI Python SDK v3.19.1 发布:修复工具迭代与请求头问题
OpenAI Python SDK v3.19.1 发布,修复了单次调用工具迭代对象丢失、HTTP 请求头大小写合并等问题,并澄清了 Chat Completions 的 seed 参数限制。面向开发者的低风险维护性升级指南。
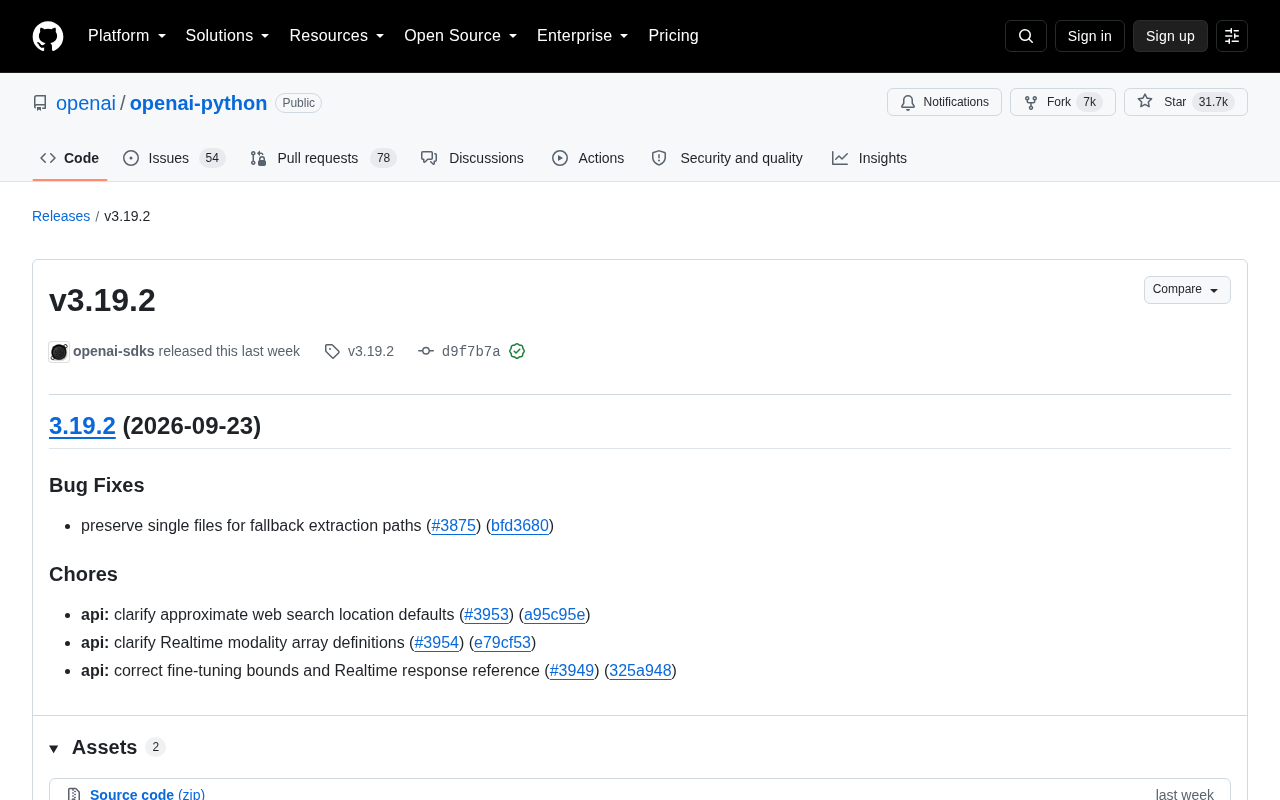
OpenAI Python SDK v3.19.2 发布:修复文件回退与API文档澄清
OpenAI 官方 Python SDK 发布 v3.19.2 版本,修复文件回退提取路径问题,并澄清 web search 位置默认值、Realtime 模态定义及 Fine-tuning 边界等多项 API 文档。本文解析更新要点与升级建议。
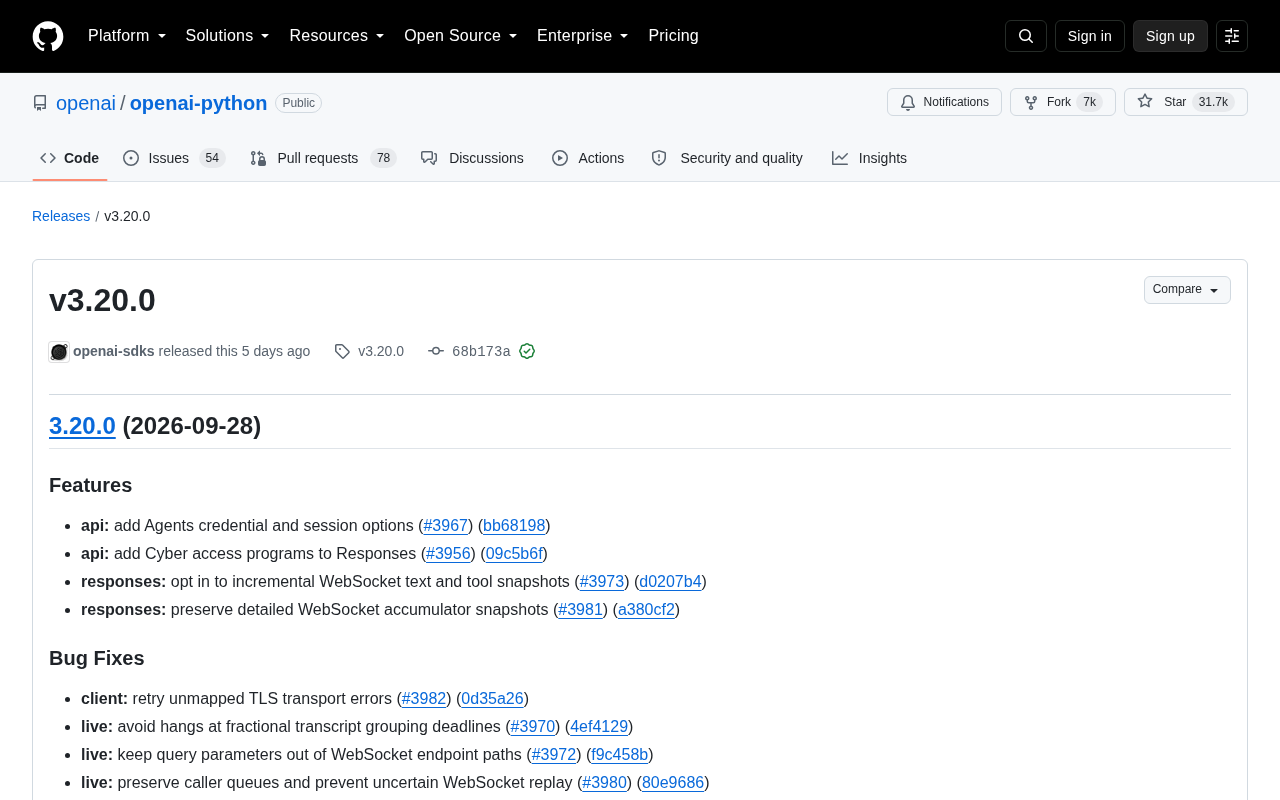
OpenAI Python SDK v3.20.0发布:Agents凭证与WebSocket增强
OpenAI 官方 Python SDK v3.20.0 正式发布,新增 Agents 凭证与会话选项、Responses WebSocket 增量快照,并集中修复实时连接稳定性问题,同时完善 API 错误响应文档。