RAG准确率上不去?先做元数据预过滤而非调参
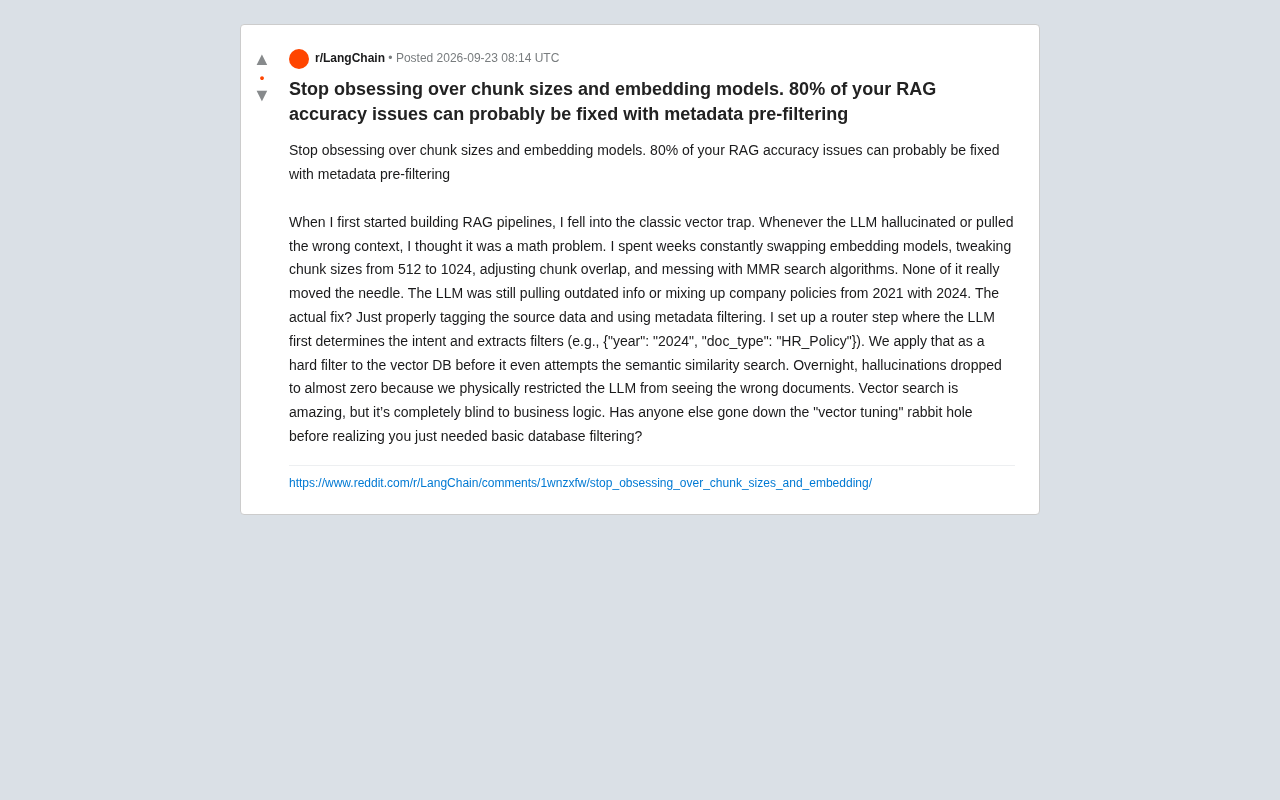
RAG幻觉多源于数据过滤缺失,而非向量检索精度不足,元数据预过滤才是核心解法。
本文通过一位开发者的真实踩坑经历,揭示了RAG系统中一个常见的认知误区:将检索准确率问题归因于Embedding模型或chunk size,并反复在向量层调参,却收效甚微。真正的根源在于向量搜索对业务逻辑(如年份、文档类型)天然「失明」——语义相似的旧文档照样会被召回,导致模型混淆不同版本的内容。该开发者最终通过引入元数据预过滤机制——在语义检索前,先由LLM抽取结构化过滤条件(如年份、文档类型)并作为硬过滤应用于向量数据库——使幻觉几乎降为零。文章由此提炼出RAG工程的核心优先级:优先做好数据结构化标注和意图路由,而非急于更换模型,因为向量搜索与元数据过滤是互补关系,各自解决不同类型的问题。
别再盯着 Chunk Size 和 Embedding 模型死磕
很多人构建 RAG(检索增强生成)系统时,都会掉进同一个陷阱:一旦大模型出现幻觉或者检索到错误上下文,第一反应就是「这是个数学问题」,于是开始不停折腾向量层。
一位 Reddit 开发者分享了自己踩坑的完整经历。他花了整整几周时间反复更换 Embedding 模型、把 chunk size 从 512 调到 1024、调整 chunk overlap、还尝试了 MMR(最大边际相关性)搜索算法。结果呢?「None of it really moved the needle」——这些操作几乎没有带来任何实质改善。模型依然在拉取过时信息,甚至把 2021 年的公司政策和 2024 年的混为一谈。
这个故事戳中了大量 RAG 实践者的痛点:我们习惯把检索质量问题归因于向量相似度不够精准,却忽略了一个更基础的层面——数据本身的组织与过滤。
真正的解法:元数据预过滤
这位开发者最终找到的答案朴素得令人意外——给源数据打好标签,并在检索前做元数据过滤(metadata pre-filtering)。
他的具体做法是引入一个「路由(router)」步骤:
- 先让 LLM 判断用户意图,并从查询中抽取出结构化过滤条件,例如
{"year": "2024", "doc_type": "HR_Policy"} - 在执行语义相似度搜索之前,把这些条件作为硬过滤(hard filter)应用到向量数据库上
- 只有通过过滤的文档,才会进入后续的向量检索环节
结果是「Overnight, hallucinations dropped to almost zero」——幻觉几乎在一夜之间消失。原因很直接:系统从物理层面就阻止了大模型看到错误的文档。
这里的关键转变在于处理顺序。传统做法是「先做语义检索,再考虑相关性」,而预过滤是「先用业务逻辑收窄候选集,再让向量搜索在正确的范围内发挥作用」。
元数据预过滤在主流向量数据库中均有原生支持。以 Pinecone、Weaviate、Qdrant 为例,它们允许在查询时附加结构化过滤条件(filter),数据库会先用倒排索引或位图索引筛选出符合条件的文档子集,再在这个子集内执行向量相似度计算。这种「先过滤、再搜索」的执行顺序(pre-filtering)与「先搜索、再过滤」(post-filtering)在结果质量上差异显著——后者可能因为大量候选被事后剔除而导致召回不足,前者则从根本上保证检索范围的业务正确性。值得注意的是,元数据字段需要在数据入库时就显式声明为可索引字段,否则过滤操作会退化为全量扫描,影响性能。因此,在设计 ingestion pipeline 时就规划好元数据 schema,是这一方案能否落地的关键前提。
为什么向量搜索会「看不见」业务逻辑
原帖里有一句话点破了本质:「Vector search is amazing, but it's completely blind to business logic.」
向量搜索的核心是语义相似度。当你问「2024年的休假政策是什么」,2021 年的休假政策文档在语义上和你的问题高度相似——它们谈的都是休假、都是政策、用词结构几乎一致。向量模型没有任何机制去区分「哪一年」这种业务维度上的硬性差异,因为年份的差别在语义向量空间里可能微乎其微。
换句话说,你不断优化 Embedding 模型和 chunk 策略,是在提升「找到语义最像的内容」的能力。但当问题的本质是「时间维度错配」「文档类型混淆」时,再精准的语义匹配也无济于事——它压根不是一个相似度问题。
这解释了为什么调参「怎么都不见效」。方向从一开始就错了。
这一局限源于向量嵌入(embedding)的本质:它将文本的语义内容压缩进高维空间中的一个点,相似语义的文本在该空间中距离相近。然而「语义相近」与「业务上相关」是两个不同维度的概念。「2021年休假政策」和「2024年休假政策」在语义向量空间中的距离,可能远比「2024年休假政策」与「2024年差旅报销规定」之间的距离更近——因为前两者的词汇和句式结构几乎相同,而年份在连续的语义流中权重极低。MMR(Maximal Marginal Relevance,最大边际相关性)算法试图在结果相关性与多样性之间取得平衡,减少冗余结果,但它同样工作在语义相似度层面,并不能识别「这份文档在时间维度上不符合查询意图」这类业务约束。这也解释了文中开发者尝试 MMR 后依然无效的原因。
对 RAG 工程实践的启示
这个案例给正在搭建 RAG 系统的团队几点值得落地的思路:
优先投资数据的结构化标注。 在做入库(ingestion)时,就应该为每个文档块附上尽可能丰富的元数据:年份、文档类型、部门、版本、来源等。这些标签的价值往往远超过再调一轮 chunk size。
把「意图路由」纳入检索链路。 让 LLM 在检索前先做一轮轻量级的意图理解和过滤条件抽取,是低成本高回报的架构改进。它相当于在向量检索前架设了一道业务逻辑的闸门。
区分问题类型再选工具。 语义模糊、需要理解含义的问题,交给向量搜索;带有明确约束条件(时间、类别、权限)的问题,先用过滤解决。二者是互补而非替代关系。
需要说明的是,「80% 的准确率问题都能靠元数据过滤解决」是原作者基于个人经验的估计,并非严格统计结论。不同业务场景下,chunk 策略和 Embedding 质量依然重要——尤其是当文档结构本身缺乏可标注的元数据维度时。这个观点更应被理解为一种优先级提醒:在埋头调参之前,先检查数据组织和过滤逻辑是否到位。
结语
这条 Reddit 帖子之所以引发共鸣,是因为它揭示了一个常见的认知偏差:工程师容易把系统问题归结为算法和模型问题,因为那是我们更熟悉、更「技术」的领域。但很多时候,最有效的杠杆恰恰在那些看起来「不够高级」的基础工程上——比如给数据打标签、加过滤条件。
下次你的 RAG 系统又开始胡说八道时,或许不必急着换模型。先问一句:它是不是根本就不该看到那份文档?
相关推荐
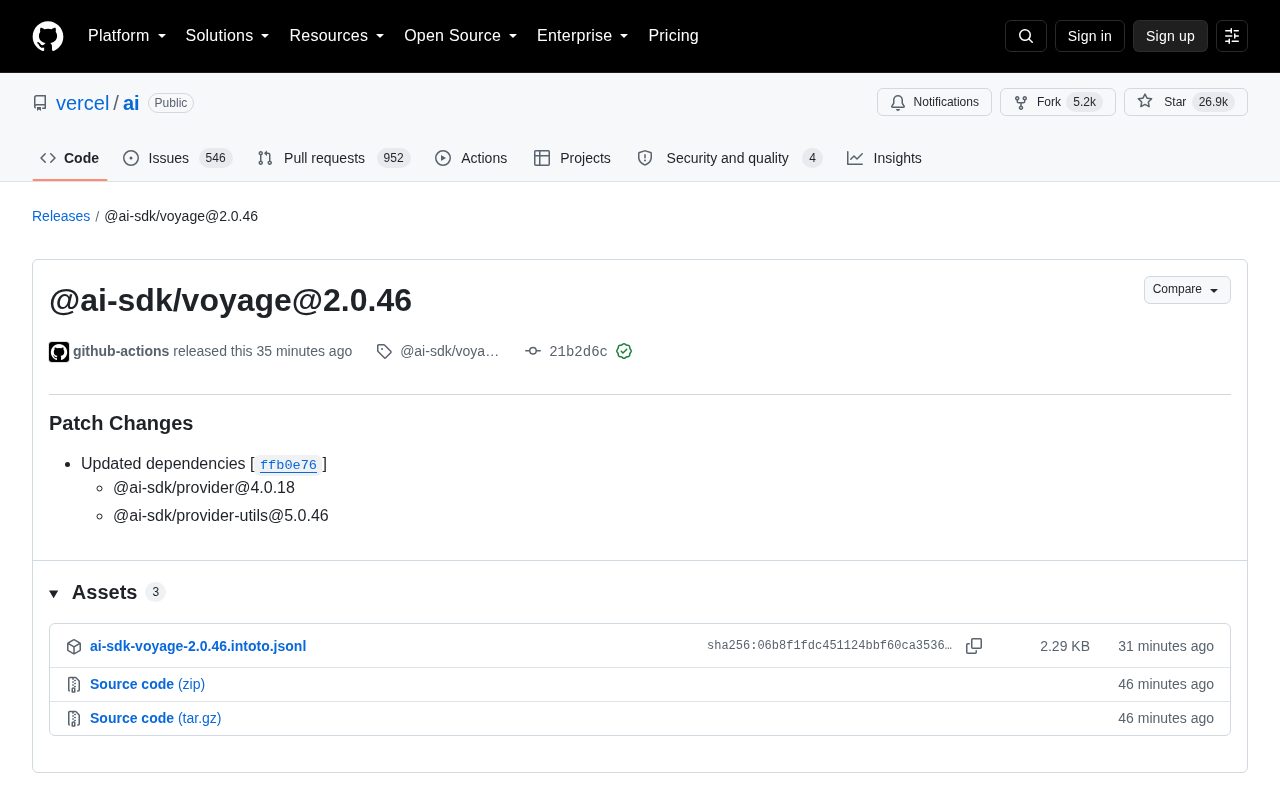
@ai-sdk/voyage 2.0.46 发布:依赖更新的补丁版本
Vercel AI SDK 生态发布 @ai-sdk/voyage 2.0.46 补丁版本,主要更新 @ai-sdk/provider 与 provider-utils 依赖。本文解读该版本改动、Voyage 嵌入模型定位及对开发者的实际影响。
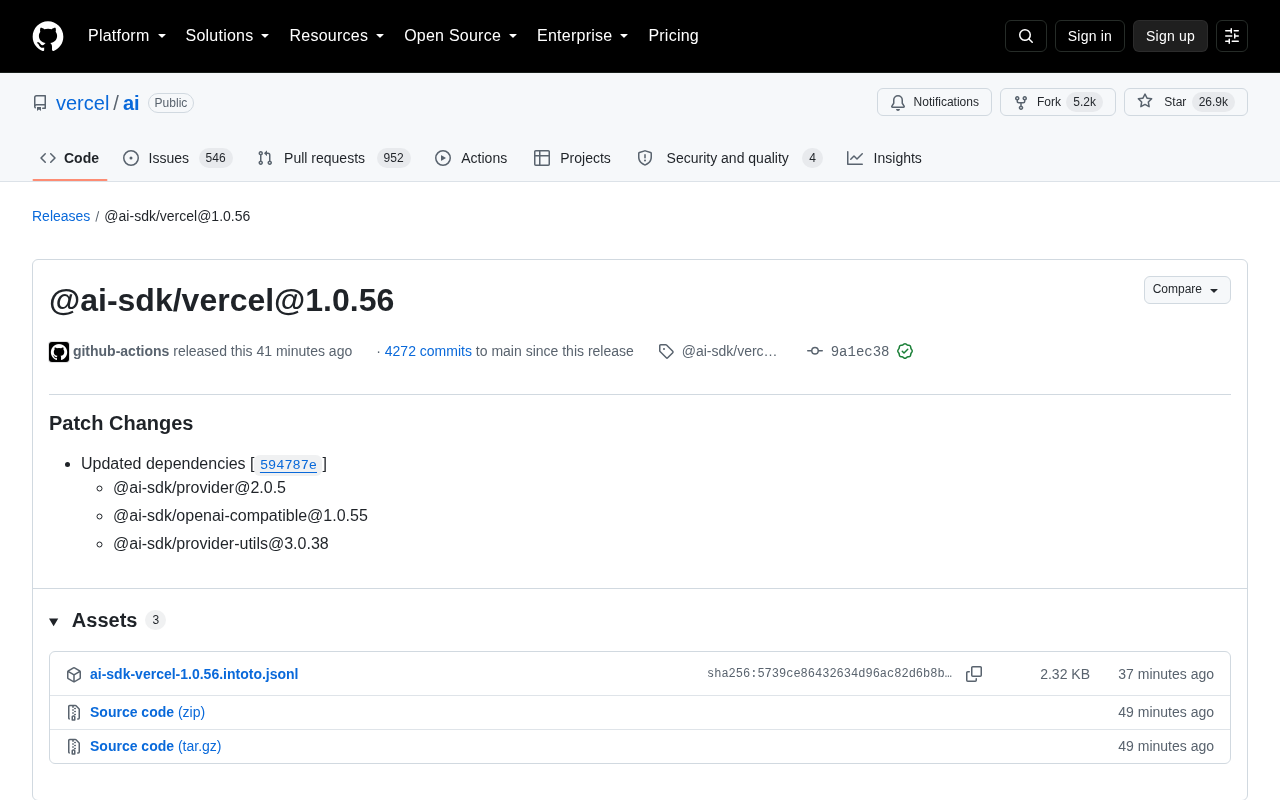
@ai-sdk/vercel 1.0.56 补丁更新解读
Vercel AI SDK 发布 @ai-sdk/vercel 1.0.56 补丁版本,同步更新 provider、provider-utils 与 openai-compatible 等依赖包。本文解读本次更新内容、升级建议及其对开发者的影响。
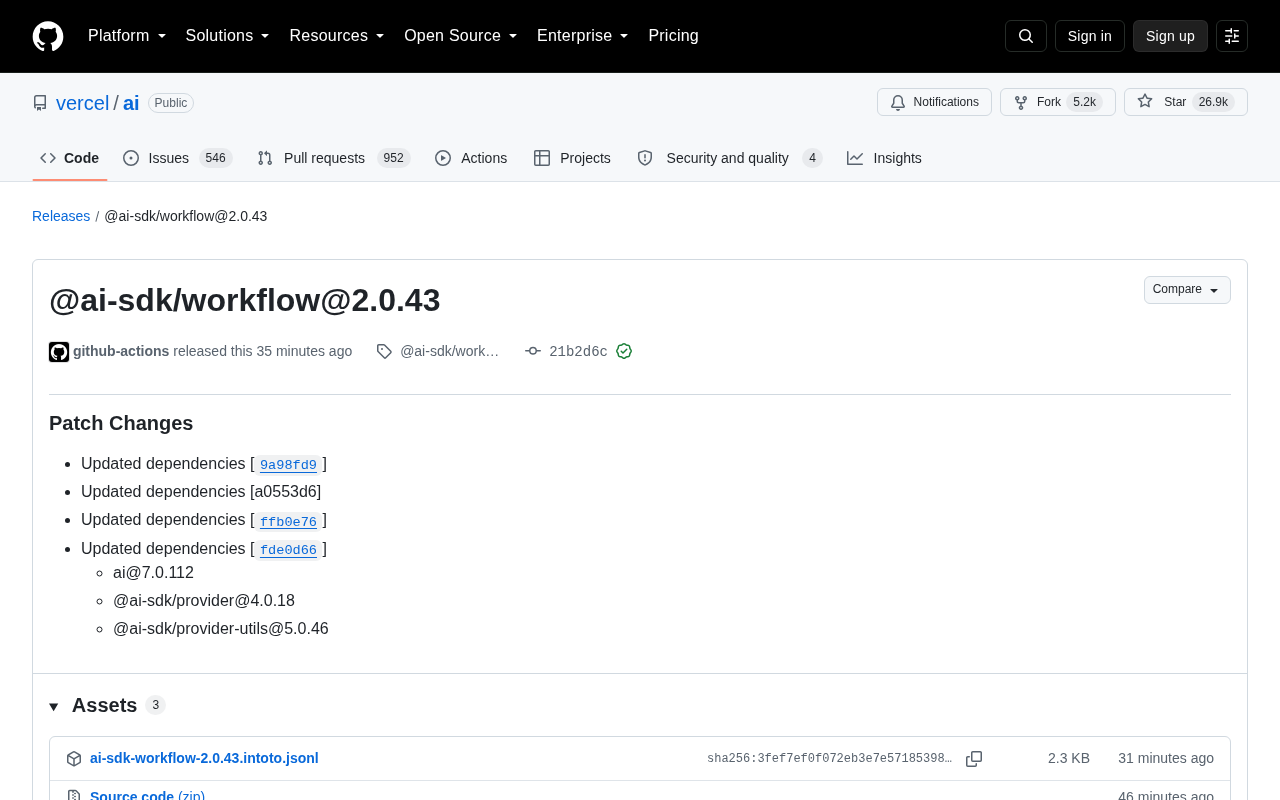
Vercel AI SDK 发布 @ai-sdk/workflow 2.0.43 补丁更新
Vercel AI SDK 发布 @ai-sdk/workflow 2.0.43 补丁更新,同步升级 ai、@ai-sdk/provider 等核心依赖。本文解读本次更新内容、workflow 模块定位及开发者升级建议。