让AI编程助手学会偷懒:代码砍半的七级台阶

开源项目用七级台阶教AI先判断要不要写代码,少写53%却测试更密。
一个开源项目给AI编程助手立下七级台阶:从“功能是否需要存在”逐级追问到“能否一行搞定”,只有全部不满足才写最小实现,同时明确校验、错误处理、安全、无障碍四项永不简化。官方基准显示同一agent跑39人五轮,代码量少53%、时间快41%、成本降26%,带逻辑代码的测试兜底比例从68%升至98%,注入bug被自身测试抓住的比例从46%升至66%。项目只是一个prompt,支持20个agent,但成本条仅限Claude Code特定版本与终端/桌面端。当天榜单主线是给AI立规矩:一个管少写,一个管多查,最终判断仍需人来把关。
AI编程助手正在被教一件事:少写代码。开源热榜上冒出一个新项目,不教AI更强的生成能力,反而给它立下七级台阶,能不做就不做,能一行搞定就绝不写十行。听起来像偷懒,但官方基准显示代码量少了53%、时间快41%、成本降26%,而校验、错误处理、安全和无障碍四项永不简化。
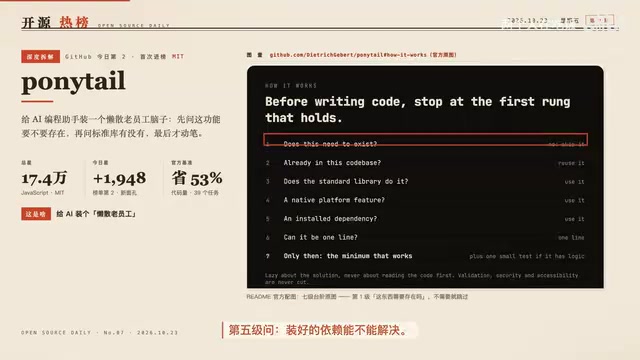
七级台阶:写代码之前先问要不要写
这个项目的核心是一个人设:屋里最懒的那位资深开发。它的信条是“最好的代码是你从来没写过的代码”,并把决策拆成七级台阶,从低到高逐级追问。
第一级问这个功能真的需要存在吗,不需要就直接跳过;第二级问仓库里是不是已经有了;第三级问标准库能不能做;第四级问平台本身是不是自带;第五级问装好的依赖能不能解决;第六级问能不能一行搞定;只有都不行,第七级才动手写最小的那份。这套顺序不是单纯追求省事,而是把“避免重复造轮子”变成可执行的检查清单。据B站UP主在视频中的解读,它实际上是把资深开发者的隐性判断显性化了。
更关键的是原文把界限写死了:校验、错误处理、安全、无障碍这四项永不简化。少写的是没人要的那部分,不是把该做的保障砍掉。这个设计让“偷懒”不至于滑向“偷工减料”。
“标准库”指编程语言自带的、随语言发行版一并提供的函数和模块集合,例如 Python 的 os、json,JavaScript 的 Math、Array。它们经过长期测试、文档完善、无需额外安装,通常也是性能最优的实现之一。很多开发者习惯性引入第三方库去完成标准库已有的功能,结果增加依赖体积与维护成本。七级台阶把“标准库能不能做”放在第三级,正是要求 AI 在动手前先盘查语言自身能力,而不是默认去 npm 或 PyPI 上找一个包。
“平台本身是不是自带”中的“平台”,指运行代码的操作系统、浏览器或宿主框架。例如浏览器已内置 fetch、IntersectionObserver,操作系统提供文件监听、剪贴板、通知等 API,现代前端框架也自带路由与状态管理。这些能力往往被忽视,开发者转而引入功能重叠的第三方实现。第四级台阶要求 AI 先确认平台原生能力是否覆盖需求,能复用就不新增依赖,这与标准库一级形成互补:一个看语言层,一个看运行环境层。
官方基准:省下的不只是钱
官方基准给出了同一agent同样39个人跑五轮的数据:代码少53%,时间快41%,成本便宜26%。但比省钱更有意思的是两个更硬的质量数字。
带逻辑的代码有测试兜底的比例从68%升到98%,故意注入的bug被它自己的测试抓住的比例从46%升到66%。这说明少写代码的同时,测试覆盖反而更密了。原因不难理解:写得更少,每一行就更值得被测试保护,AI也更容易把注意力放在关键逻辑上。视频作者在解读时特别点出,这组数字比省多少钱更有价值。
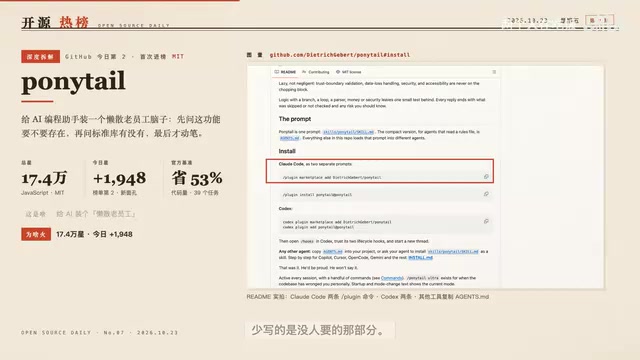
安装极轻,但有两个现实限制
整个项目就是一个prompt,安装负担几乎为零。支持20个agent,Claude Code两条命令装完,Codex也是两条命令,别的工具复制一份说明文件进去就行。适合天天开着Claude Code、Codex、Cursor跑任务的人,尤其是月底看账单肉疼的那批;只偶尔用补全、不跑长任务的用户收益有限。
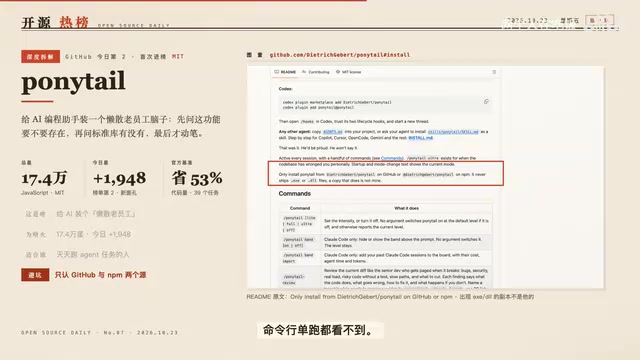
来源作者在README里明确提醒:他从不发布EXE和DLL,出现这类文件的副本不是他的,只从GitHub仓库或npm安装,别从搜索引擎找镜像。另有一个限制是成本条只支持Claude Code 21.290以上版本,而且只有终端和桌面板能看,VSCode聊天面板、云端绘画、命令行单跑都看不到。
文中反复出现的“agent”,指能自主执行多步任务的 AI 编程代理,而非只做单行补全的编辑器插件。典型代表包括 Claude Code、Codex、Cursor 的 Agent 模式:它们可以读写仓库文件、运行命令、根据报错自我修正,完成一个完整任务往往消耗大量 token。正因如此,这类工具的成本对“写多少代码”极其敏感——少写一行就少一轮生成与校验,这也是七级台阶能同时压低成本与时间的底层原因。只使用补全的用户不跑长任务,自然感受不到这种收益。
从省token插件到给AI立规矩
这个项目今天涨了1948星,冲到总榜第二,是近10天榜单里第一次见到它。但需要提醒:它上一次发版是10月16号,今天没有新版本,所以别理解成刚发布,而是发版之后一直在发酵、被榜单算法推上来的。
我的判断是,它不是又一个省token插件,而是在给AI编程立规矩:先别写。写代码之前先问要不要写,这个习惯比省下的那点钱值钱。视频作者对此同意一半:规矩是好规矩,但它治不了需求本身就想错了的情况。如果方向错了,少写只是让错误更便宜,而不是更正确。
对照榜一:一个管少写,一个管多查
同一天榜单第一是Cloudflare的官方项目,四万星,方向相反:它不管AI少写代码,而是让AI去找自己代码里的漏洞。设计上让找的人不负责判断,避免AI自己给自己背书,这个思路有参考价值。
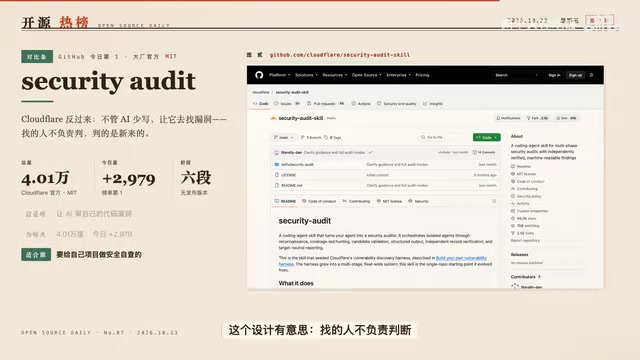
但它的门槛很高,官方要求操作系统级沙箱、境外网络和资源,没有这套控制只能挂着等验证,而且官方说单跑一次大约只找到一半,需要多跑几轮。它也没有新版本。所以今天它火不代表今天就能用上,更像给安全团队看的流程样板。
两个项目合起来是当天的主线:一个管AI少写,一个管AI多查。趋势可以概括为,给AI加能力的阶段过去了,开始给他立规矩。方向相反,目标一样:让AI少犯错。但规矩是死的,少写不等于写对,多查也不等于查全,最后那道闸还得人来关。
“沙箱”是一种隔离执行环境,让不受信任的代码在受限空间内运行,无法随意访问宿主机文件、网络或系统资源。安全审计类 AI 需要运行目标代码、发起扫描,风险较高,因此官方要求操作系统级沙箱作为前提。这与普通代码生成工具不同:后者只输出文本,前者要实际执行。没有沙箱,项目只能停留在验证阶段,无法放心跑完整流程。这也解释了为何榜一项目门槛高、单次运行只覆盖约一半问题,需要多轮迭代。
相关推荐

大厂AI工程化面试:前端监控到Agent全链路可观测性
从PerformanceObserver采集性能指标、onerror与unhandledrejection捕获异常,到RAG链路重排优化、上下文压缩控制token成本,再到对标LangSmith与Sentry的全站AI全链路可观测性体系设计,拆解大厂AI工程化面试的三层递进考点。

WorkBuddy保姆级教程:手把手搭建专属AI Agent工作助理
WorkBuddy保姆级教程:从豆包等聊天模型的局限讲起,手把手教你搭建专属AI Agent工作助理,实现本地文件批量处理与自动化操作,非程序员也能轻松上手。

Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库
本文整理B站教程,详解Windows下用LangChain-Chatchat与DeepSeek搭建本地知识库的全流程,包括Anaconda环境配置、Ollama模型管理、镜像源加速及常见报错解决,助你快速实现RAG问答。