让LLM主动发现用户矛盾:UC-Bench与SynUC合成方法解析
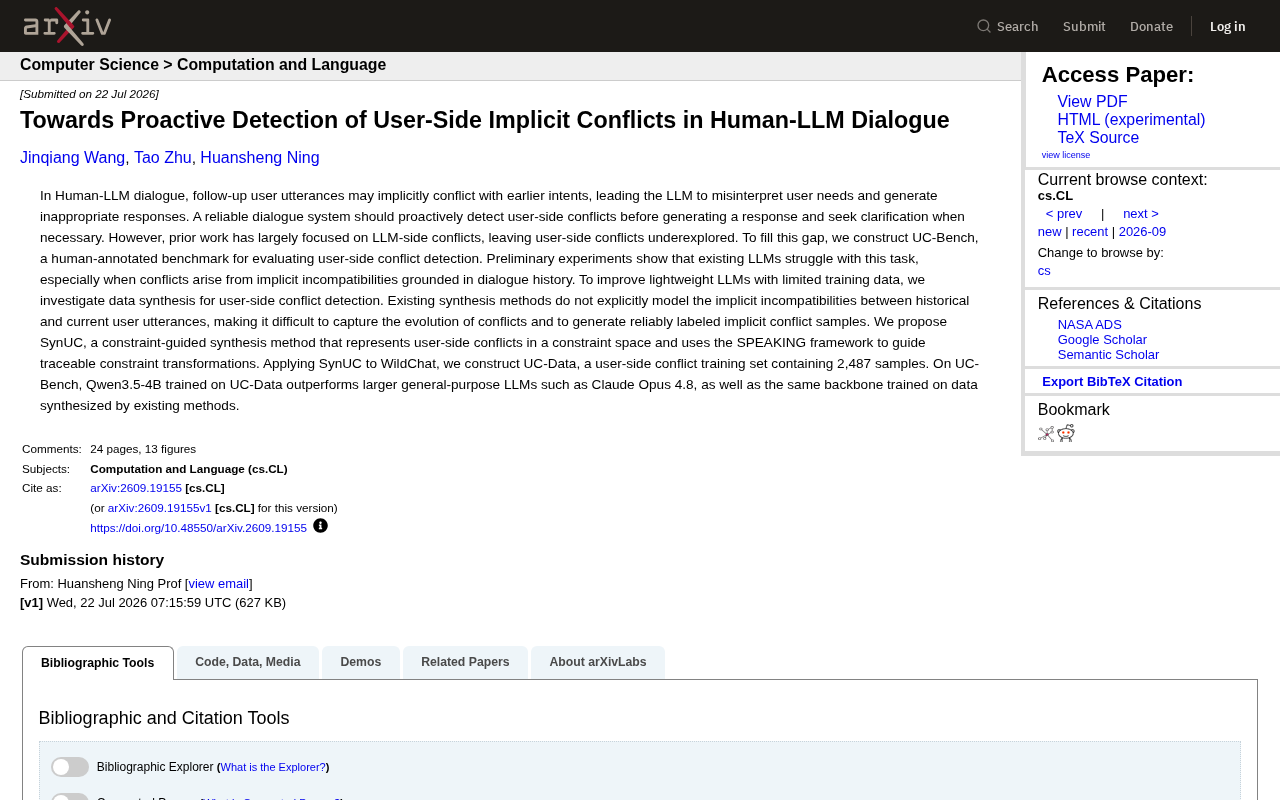
研究提出SynUC方法与UC-Bench基准,让4B小模型在检测用户对话隐性冲突上超越Claude等大模型。
这篇arXiv论文聚焦于人机多轮对话中长期被忽视的"用户侧隐性冲突"问题——即用户当前表述与历史意图之间的不兼容。研究构建了人工标注基准UC-Bench,发现现有主流LLM在检测此类冲突时普遍表现不佳。为解决训练数据匮乏的瓶颈,研究提出SynUC方法,将用户需求抽象为约束空间,借助SPEAKING框架进行可追溯的约束变换以生成高质量标注样本。基于WildChat构建的2,487样本训练集UC-Data,让仅4B参数的Qwen3.5模型在UC-Bench上超越了Claude Opus 4.8等更大规模的通用模型,验证了"高质量专用合成数据+小模型"路线在特定任务上的竞争力。
在人与大语言模型(LLM)的多轮对话中,一个常被忽视的问题正在浮现:用户后续的表述,可能与之前表达的意图产生隐性冲突。当LLM未能察觉这种矛盾时,往往会误解真实需求,进而生成不合适的回应。这篇发表于arXiv的研究(arXiv:2609.19155v1)正是聚焦于此,提出了一套完整的检测基准与数据合成方法。
被忽视的"用户侧冲突"
以往关于对话冲突的研究,大多集中在LLM侧冲突——即模型自身回答前后不一致或与事实矛盾。相比之下,用户侧冲突(user-side conflicts)却长期缺乏深入探讨。
所谓用户侧冲突,指的是用户在对话过程中,当前的表述与更早的意图之间存在不兼容。举个例子:用户前面说"我想找一家安静适合工作的咖啡馆",随后却要求"最好有现场乐队表演"——这两个需求本质上相互矛盾。一个可靠的对话系统,理应在生成回应之前主动检测出这种冲突,并在必要时向用户寻求澄清,而不是硬着头皮给出一个自相矛盾的答案。
研究指出,这类冲突尤其难以处理的原因在于其"隐性":矛盾往往植根于对话历史,需要模型追溯上下文才能识别,而非显式地摆在当前这句话中。
UC-Bench:一个人工标注的评测基准
为了填补这一研究空白,作者构建了UC-Bench——一个由人工标注、专门用于评估用户侧冲突检测能力的基准。
初步实验的结论并不乐观:现有的LLM在这项任务上普遍表现挣扎,尤其当冲突源自对话历史中的隐性不兼容时,模型的检测能力明显下降。这说明当前主流大模型虽然在生成能力上表现强劲,但在"主动察觉用户逻辑矛盾"这一细粒度理解任务上仍有明显短板。
这一发现具有现实意义:在实际的客服、助理、咨询类应用中,用户表达往往是碎片化、渐进式的,前后需求发生冲突十分常见。若模型缺乏主动检测能力,用户体验和任务完成度都会受损。
SynUC:用约束空间建模隐性冲突
检测能力上不去,很大程度上受限于训练数据的稀缺。研究团队因此转向数据合成,试图为轻量级LLM提供高质量的训练样本。
然而现有合成方法存在一个核心缺陷:它们没有显式建模历史表述与当前表述之间的隐性不兼容,导致难以刻画冲突的演化过程,也就无法可靠地生成带有正确标注的隐性冲突样本。
针对这一痛点,作者提出了SynUC——一种约束引导的合成方法。其核心思路有两点:
- 约束空间表示:将用户侧冲突表示在一个"约束空间"中,把用户的每一次需求抽象为一组约束条件,冲突即约束之间的不兼容。
- SPEAKING框架引导:借助SPEAKING框架来引导可追溯的约束变换(constraint transformations),使得冲突的产生过程有迹可循,从而生成标注可靠的样本。
这种做法的优势在于"可追溯性"——不是随机制造矛盾,而是让每一次约束的转化都能被解释,保证了合成数据的质量与标签准确性。
SPEAKING框架源自社会语言学家Dell Hymes提出的会话情境分析模型,原本用于描述语言交际的八个构成要素:Setting(场景)、Participants(参与者)、Ends(目的)、Act sequence(话语序列)、Key(基调)、Instrumentalities(媒介)、Norms(规范)和Genre(体裁)。在本研究中,研究者将其借鉴为一种结构化的语境标注框架,用于刻画对话中每一轮用户表述所涉及的情境维度。通过将用户需求映射到这些维度上,SynUC可以系统性地识别哪些维度的约束条件在不同轮次之间发生了转变或冲突,从而让约束变换的过程有据可查、可追溯,而非依赖随机扰动或启发式规则来制造矛盾。这种跨学科的方法迁移,是SynUC区别于先前合成方法的关键设计选择之一。
UC-Data与实验结果
将SynUC应用于真实对话数据集WildChat后,团队构建了训练集UC-Data,共包含2,487个样本。
最亮眼的结果出现在实验对比中:在UC-Bench上,基于UC-Data训练的Qwen3.5-4B,其表现超过了参数量更大的通用大模型(如Claude Opus 4.8),同时也优于用现有合成方法训练的同一骨干模型。
这一结果传递出两层信号:
其一,任务专用的高质量合成数据,能让小模型在特定任务上击败大模型。4B规模的模型胜过更大的通用模型,说明在用户侧冲突检测这类专门任务上,数据质量比模型规模更关键。
其二,SynUC的约束建模思路确实有效。同一个Qwen3.5-4B骨干,用SynUC合成数据训练的效果优于用传统方法合成数据训练的效果,验证了显式建模隐性不兼容的价值。
WildChat是一个大规模真实人机对话数据集,收录了来自真实用户与ChatGPT等大模型之间的数百万条多轮对话记录,涵盖多种语言和话题,因其自然性和多样性而被广泛用于对话系统研究。以WildChat作为原始语料的优势在于:合成数据的对话结构、语言风格与真实用户行为高度吻合,避免了完全人工构造数据时常见的"分布偏移"问题。在此基础上经SynUC加工得到的UC-Data,既保留了真实对话的自然度,又通过约束空间建模为每个样本注入了可靠的冲突标注,兼顾了数据的真实性与标注质量。Qwen3.5-4B则是阿里巴巴通义千问系列中参数量约40亿的轻量级模型,属于可在消费级硬件上部署的开源小模型,其在本任务上超越大模型的表现尤其凸显了专用训练数据的杠杆效应。
研究意义与展望
这项工作把对话系统的可靠性研究,从"模型自身一致性"推进到了"主动理解用户矛盾"这一更贴近实际应用的维度。对于构建更稳健的对话助手,主动检测并澄清用户冲突,是提升信任度和任务成功率的重要一环。
从方法论角度看,将冲突抽象为约束空间、并通过可追溯的约束变换生成数据,为其他"难以标注、依赖上下文推理"的对话任务提供了可借鉴的合成范式。对于资源受限、无法承担大模型推理成本的团队而言,"小模型+专用合成数据"的路线也颇具吸引力。
相关推荐
FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
一位开发者分享FAISS向量搜索的实战入门心得,讲解从Embedding到RAG的完整数据流,并深入探讨人名、日期、过滤条件和对话历史等真实场景下的检索难点与应对方案。
H3 Camera Control v3来袭:视频镜头控制与快速渲染上线
H3 Camera Control v3更新预告发布,将带来视频镜头控制与快速渲染两项核心升级,提升AI视频创作的可控性与效率。本文解读新功能方向与行业意义。
AI大模型测试三阶段:从原理到API调用实战指南
面向测试从业者的AI大模型学习路径:从文本输入原理、提示词工程,到基于OpenAI库的API与SDK调用实战,理清Token与API Key区别、流式输出机制,并延伸到RAG与Agent智能体的落地方向。