让每个LLM Token等宽显示:一个新颖的字体生成思路

一个用自定义字体让每个LLM token视觉等宽的创意项目,把抽象的分词过程变成肉眼可感知的排版现象。
这篇文章介绍了一个出现在Hacker News上的实验性项目:将传统等宽字体的概念从「每字符等宽」延伸为「每token等宽」,让LLM分词器的切分结果直接映射到视觉宽度上。文章解释了tokenization的基本原理——模型将文本拆成可变长度的token单元,而这一过程对普通用户完全不可见,却直接影响API成本与上下文窗口占用。实现这一字体需要克服token可变长度、分词器绑定及渲染管线复杂度等挑战,可能需借助OpenType高级特性或外部预处理。其受众包括提示词工程师、开发者与研究者。文章最终将该项目定性为一次用古老排版技术可视化前沿AI概念的跨界实验,核心价值在于帮助人们建立对模型「视角」的直觉认知。
从等宽字体到「等Token宽」字体
在编程和文本处理领域,等宽字体(monospace)是老生常谈——每个字符占据相同的水平宽度,让代码对齐、表格排版变得整洁。但一个出现在 Hacker News 上的项目提出了一个更大胆的想法:不是让每个字符等宽,而是让每个 LLM token 等宽。
这个看似小众的创意,实际上触及了大语言模型工作方式与人类视觉直觉之间的一道鸿沟。项目在 Hacker News 获得了 19 个 points 和 5 条评论的讨论,虽然热度不算爆炸,但话题本身颇具启发性。
为什么要让 Token 等宽?
要理解这个项目的价值,先得明白 LLM 眼中的文本和人类看到的文本是不一样的。
人类读文本以字符、单词为单位;而大语言模型处理文本时,会先通过分词器(tokenizer)把文本切成一个个 token。一个 token 可能是一个完整单词、一个词的片段、几个字符,甚至是一个标点或空格组合。例如「tokenization」这个词,可能被拆成「token」「ization」两个 token,而「the」通常是一个独立 token。
这种切分对普通用户是完全不可见的。当你盯着屏幕上的一段文字时,无法直观感受到模型究竟把它切成了多少个 token、边界在哪里。而 token 数量直接关系到 API 调用成本、上下文窗口占用以及模型的处理逻辑。
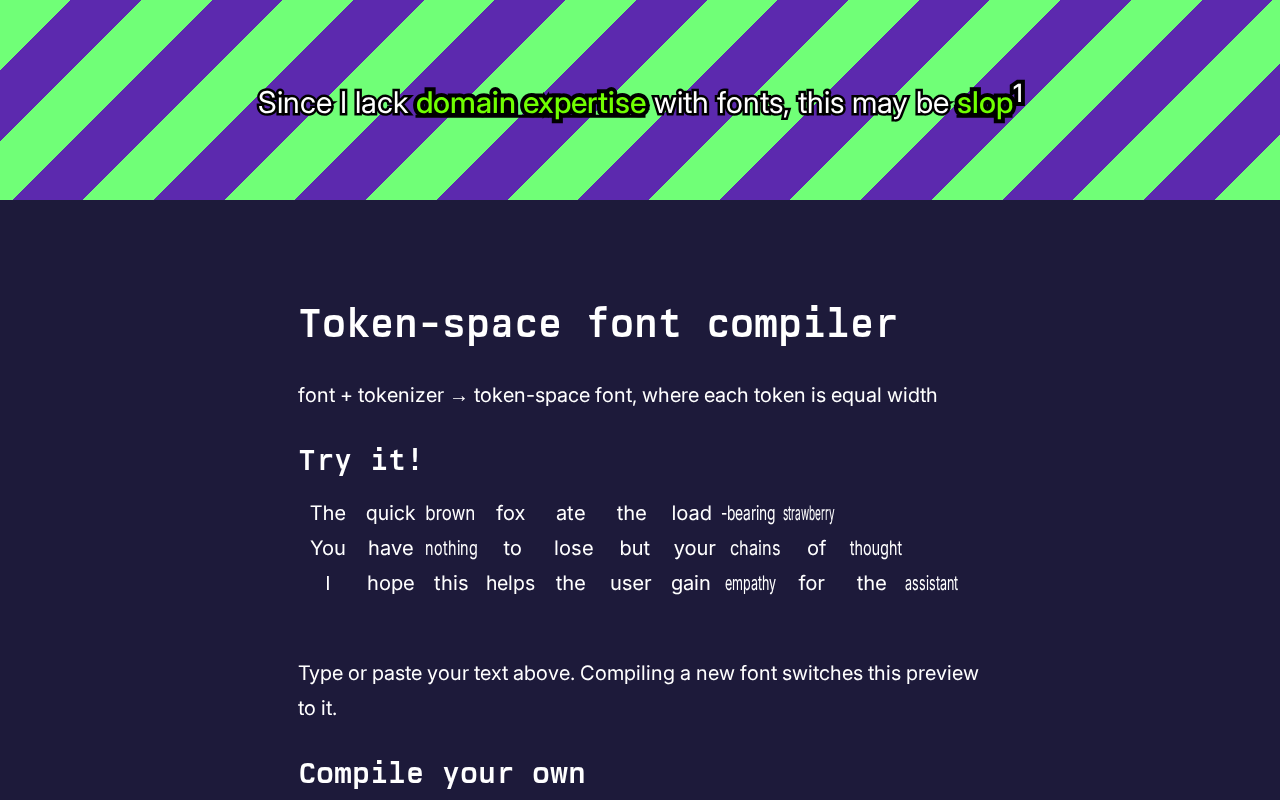
这个字体项目的核心思路,是通过定制字体让每个 token 渲染出来时占据相同的水平宽度。这样一来,视觉上的「宽度」就直接映射到了「token 数量」——你一眼就能看出一段文本消耗了多少 token,token 的边界也变得可感知。
分词器(tokenizer)背后的核心算法多为字节对编码(BPE,Byte Pair Encoding)。BPE 的原理是从单字符词表出发,反复将训练语料中最高频的相邻字符对合并为新单元,直到词表达到预设大小。这一过程会让常见词成为单个 token(如「the」「ing」),而罕见词或多语言文字则被拆成多个子词碎片。中文、日文等字符集由于在英文语料为主的训练集中出现频率相对较低,往往每个字就需要消耗 1–2 个 token,而等量语义的英文可能只需更少 token,这也是中文调用成本有时高于英文的根本原因。理解 BPE 的机制,有助于解释为什么「等 token 宽」字体在不同语言下会呈现出截然不同的视觉效果。
技术实现的巧思与难点
将这一想法落地并不简单,它把「分词」和「字体渲染」两个原本毫不相干的领域绑在了一起。
常规等宽字体只需为每个字形(glyph)设定固定的 advance width(前进宽度)即可。但 token 是可变长度的字符序列,一个 token 可能包含 1 个字符也可能包含 10 个字符。要让它们等宽,意味着字体需要根据 token 内部的字符数动态压缩或拉伸每个字符的宽度,使整个 token 的总宽度恒定。
这就带来几个现实挑战:
分词器的绑定问题
不同模型使用不同的分词器(如 GPT 系列的 BPE、其他模型的 SentencePiece 等),同一段文本在不同 tokenizer 下的切分结果完全不同。这意味着这样的字体本质上是与特定分词器绑定的——为 GPT 生成的等宽字体,套用到别的模型上就失去了意义。
渲染层面的复杂度
字体本身只描述字形轮廓,并不知道 token 的边界在哪里。要实现真正的等 token 宽显示,很可能需要配合 OpenType 的连字(ligature)、上下文替换等高级特性,或者干脆在渲染管线中预先做分词再动态调整字距。这远比生成一个普通字体复杂。
OpenType **连字(Ligature)与上下文替换(Contextual Substitution)**是现代字体处理多字符组合的标准机制。连字允许字体将特定字符序列(如「fi」「ffl」)替换为单个合体字形;上下文替换则可根据相邻字符动态切换字形变体。理论上,可以利用这套机制将已知的 token 序列预先编码为一组特殊字形——每个 token 对应一个固定宽度的连字。然而 OpenType 的连字规则基于字符序列模式匹配,并非图灵完备的分词算法,面对 BPE 词表动辄数万条规则的规模,单靠字体内部规则实现完整分词几乎不可行。更现实的路径是在渲染前由外部程序完成分词,再通过调整字距(kerning)或插入零宽字符等方式通知字体渲染引擎如何压缩每个 token 内部的字符间距。
谁会用到它?
这类工具的受众相对垂直,但痛点真实存在。
对于提示词工程师(prompt engineer),直观感知 token 消耗有助于优化提示,在有限的上下文窗口里塞进更多有效信息。对于开发者,在调试 LLM 应用时能一眼看出哪些内容「吃 token」,便于成本控制。对于研究者和教育者,这是一个绝佳的可视化教具——它把抽象的 tokenization 过程变成了肉眼可见的现象,帮助人们建立对 LLM 输入表示的直觉。
一个提醒我们「模型不是这样读字的」的实验
抛开实用性,这个项目最大的价值或许在于它的启发意义。
我们太习惯于以人类的方式理解文本,以至于常常忘记模型「看到」的是完全不同的东西。同样一段中文,可能比等长的英文消耗更多 token;一个罕见的专业术语可能被切成好几个碎片;空格和换行也各自占用 token。这些差异在日常使用中被字体和排版彻底抹平了。
让 token 等宽的字体,实际上是把模型的「视角」硬生生投射回人类的视觉系统里。它是一次有趣的跨界尝试——用最古老的排版技术(字体)去可视化最前沿的 AI 概念(tokenization)。
提一嘴,由于原始素材信息有限,项目的具体实现细节、支持的分词器范围、实际渲染效果等尚待进一步了解。但作为一个概念,它已经足够引人思考:当我们和 LLM 打交道时,理解它眼中的世界,可能和优化提示词一样重要。
相关推荐

征服阿兹特克的真相:科尔特斯军队九成并非西班牙人
历史学家 Si Sheppard 揭示,征服阿兹特克帝国的军队中西班牙征服者仅占极小比例,九成以上是渴望复仇的中美洲原住民。本文剖析特拉斯卡拉人的结盟、帝国内部裂痕与被误读的征服神话。

别再为AI智能超额付费:OpenAI DevDay成本优化全攻略
OpenAI DevDay成本优化实战解读:从每任务成本思维、帕累托曲线选模型,到提示缓存、程序化工具调用、推理强度与批处理四大杠杆,附Perplexity、Notion、Clio、Blitzy真实客户案例,教你不再为AI智能超额付费。

Databricks IP 函数正式 GA:用原生 SQL 搞定 IP 与 CIDR 分析
Databricks IP 函数正式 GA,支持用原生 SQL 解析、校验和关联 IPv4/IPv6 地址及 CIDR 网段,在 Photon 引擎优化下 CIDR join 最高提速 3.1 倍、成本降低 6.4 倍,助力 Security Lakehouse 安全分析。