Reddit热议:又一个Agent又一个RAG,AI圈陷入重复创新困境?
Reddit一句吐槽揭示AI应用Agent+RAG模板化背后的创新惰性与路径依赖。
文章以Reddit用户一句"又一个Agent又一个RAG"的吐槽为切入点,剖析AI应用层日益严重的同质化现象。作者指出,Agent与RAG因易落地、商业叙事清晰而成为默认技术配方,但由此形成技术路径依赖、评价体系单一化和用户感知钝化三重困境。社区讨论显示,这并非对两项技术本身的否定,而是对"工具定义问题"这一思考惰性的警觉。文章最后提醒开发者回归问题本质,在搭建下一个Agent前先审视场景是否真正需要这些组件,让具体问题选择工具而非相反。
Reddit上一条简短却火药味十足的帖子引发了广泛共鸣:"Everytime the same shit... Another Agent another RAG."(每次都是同样的套路……又一个Agent,又一个RAG)。没有长篇大论,没有技术细节,就这一句话,却精准戳中了当下AI开发者社区的某种集体疲惫感。
当"Agent+RAG"成为默认配方
过去一段时间,AI应用的技术栈几乎形成了一套固定模板:搭一个Agent框架,挂一个向量数据库,接上RAG做检索增强,然后对外宣称是"智能助手"。Reddit这位用户的抱怨之所以能引发讨论,正是因为它说出了很多从业者心照不宣的感受——创新正在变成流水线作业。
这种同质化的背后有现实原因。Agent和RAG确实是当前最容易落地、最容易讲清楚商业故事的技术组合。RAG解决大模型知识时效性和幻觉问题,Agent解决任务编排和工具调用问题,两者结合几乎能覆盖大部分企业级AI场景的需求。于是,无论是创业公司还是大厂团队,都倾向于直接套用这套范式,而不是从头思考问题本身是否需要这样解。
RAG(Retrieval-Augmented Generation,检索增强生成)的核心机制是:在模型生成回答前,先从外部知识库中检索相关文档片段,将其拼接到提示词中,再让模型基于这些上下文作答。它最早由Meta(当时为Facebook AI)在2020年的论文中提出,初衷是解决大模型参数化知识无法及时更新、且容易产生幻觉的问题。工程实现上通常涉及文档切分、向量化嵌入、近似最近邻检索与重排等步骤,向量数据库(如Pinecone、Milvus、Weaviate)因此成为标配组件。RAG的优势在于无需重新训练模型即可注入私有或时效性知识,成本可控、迭代快,这也是它迅速成为企业AI落地首选方案的根本原因。
重复创新背后的三重困境
技术路径的路径依赖
一旦某个技术组合被验证有效,资本、人才和注意力就会迅速向它集中。Agent框架层出不穷,RAG的变体从朴素检索一路演进到多跳推理、图检索、混合检索,但底层逻辑始终没有跳出"检索-拼接-生成"的框架。这种路径依赖让开发者很难有动力去探索完全不同的架构。
AI Agent指能够自主感知环境、规划步骤、调用外部工具并迭代执行以完成目标的系统,通常以大语言模型作为推理中枢,配合函数调用、记忆模块和任务分解机制。与传统的单轮问答不同,Agent强调多步决策与工具编排,典型框架包括LangChain、AutoGPT、ReAct范式等。其工程难点在于长程任务的可靠性:每一步的工具调用和中间结果都可能引入误差,错误会沿链条累积。这也是为什么许多号称"智能体"的产品实际只实现了有限状态的流程编排。理解这一点,有助于看清Agent与RAG组合为何容易沦为模板——两者都是通用能力组件,组合门槛低,但要真正解决具体场景的可靠性问题,仍需大量针对性设计。
评价体系的单一化
当行业用同一套基准测试、同一批演示场景来衡量AI应用时,产品自然会趋同。大家都在优化相似的指标,做相似的demo,最终产出的东西也就长得越来越像。Reddit原帖的讽刺语气,某种程度上是对这种"指标驱动创新"的反抗。
AI应用评价体系的趋同,与行业通用的基准测试生态密切相关。RAG方向常用检索命中率、召回率及基于LLM的忠实度评分(如RAGAS框架);Agent方向则多用任务完成率、工具调用准确率等指标。这些基准便于横向比较,却也塑造了"什么容易量化就优化什么"的倾向。更深层的问题在于,基准测试往往脱离真实业务场景的复杂约束,导致团队在排行榜上刷分,却难以转化为用户可感知的差异。当评价维度被少数公共基准垄断时,产品的多样性自然被压缩,这也是社区呼吁建立场景化、任务级评估的原因之一。
用户感知的钝化
对终端用户来说,第N个"智能助手"和第N+1个之间往往没有本质区别。当每个产品都号称自己能理解上下文、能调用工具、能检索知识库时,差异化就消失了。开发者的疲惫感和用户的审美疲劳其实是同一枚硬币的两面。
社区情绪:吐槽之外还有反思
这条帖子虽然只有一句话,但它代表的情绪在开发者社区中并不孤立。类似的讨论在Hacker News、Twitter以及各个技术 Slack 群里反复出现:AI应用层是否正在经历一场"低水平重复"?
一部分观点认为,这是技术成熟过程中的正常阶段——基础设施标准化之后,真正的创新才会在应用层涌现。另一部分声音则更尖锐:当所有人都忙着搭Agent、接RAG时,真正困难的问题——比如模型的推理可靠性、长期记忆、多模态理解——反而被搁置了。
值得区分的是,吐槽"又一个Agent又一个RAG"并不等于否定这两项技术本身的价值。RAG和Agent都是实打实有用的工程手段,问题在于它们被当成了万能答案,而不是针对具体问题的具体解法。
对开发者的启示
如果你也在做AI应用,这条帖子值得当作一面镜子。在动手搭下一个Agent之前,不妨先问几个问题:这个问题真的需要Agent来编排吗?RAG检索到的内容真的比模型自身知识更可靠吗?如果去掉这两个组件,产品还剩下什么核心价值?
技术的同质化不可怕,可怕的是思考的同质化。Reddit上那句粗粝的抱怨,本质上是在提醒整个行业:别让工具定义问题,要让问题选择工具。
结语
"又一个Agent又一个RAG"——这句话的传播力恰恰在于它的粗糙和真实。它不代表对技术的否定,而是对创新惰性的警觉。当技术栈趋于标准化,真正的竞争力会回到对场景的理解和对问题的定义能力上。这或许是这条Reddit短帖留给AI从业者最有价值的提醒。
相关推荐
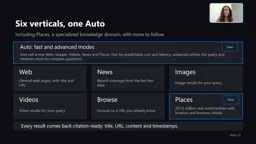
微软WebIQ:为AI Agent提供可验证的实时网页接地
微软WebIQ为AI Agent提供实时、可引用的网页接地能力,覆盖网页、新闻、图片、视频、Places等来源,P95延迟164毫秒,同等质量下token用量减少50%,支持Scopes来源控制与MCP接入。
可增强高斯泼溅:打造机器人训练的照片级仿真环境
团队用高斯泼溅与网格混合构建照片级真实感机器人仿真环境,结合 MuJoCo Warp 物理引擎与 Franka Panda 机器人,实现可增强、可重打光的真实场地仿真,缩小仿真到现实的视觉差距。

Gemini 4 Carbon发布:一年内从Gemini 3到Gemini 4的飞跃
Google发布最新前沿模型Gemini 4 Carbon,距离Gemini 3不到一年。官方演示中Carbon一次性完成Theme Park二进制逆向工程、添加DeepMind主题新设施并移植到Web,展示了模型在长链路工程任务上的能力进展。