Roxie:基于JAX的强化学习新框架,专攻MuJoCo连续控制
Roxie 是基于 JAX 的 MuJoCo 强化学习框架,内置七种算法并通过全 XLA 编译实现跨硬件高效训练。
开发者 Vittorio 开源了名为 Roxie 的强化学习框架,专为 MuJoCo 连续控制任务设计,完全基于 JAX 构建。框架通过单一统一接口屏蔽 GPU 与 CPU 的硬件差异,内置 DDPG、TD3、D4PG、TD4、SAC、MPO、PPO 七种主流算法,且全部共享同一 agent 基类,便于公平的横向对比实验。性能层面,Roxie 将采样与学习两个阶段均编译为单一 XLA 程序,消除了传统 Python 主循环频繁与加速器通信的瓶颈,保持硬件持续满载。作者以 5 亿步训练预算在 dm_control 的三个 humanoid 任务上完成了 GPU/CPU 双路径基准测试,并将预训练权重上传至 Hugging Face,供研究者直接复用。
开发者 Vittorio 近日在 Reddit 上发布了一个名为 Roxie 的新强化学习(RL)框架。它完全基于 JAX 编写,专门针对 MuJoCo 环境下的连续控制任务而设计。对于长期在强化学习与物理仿真领域摸爬滚打的研究者来说,Roxie 试图解决一个由来已久的痛点:如何在不同硬件上高效扩展 MuJoCo 仿真。
Roxie 想解决什么问题
在强化学习的实际工程中,MuJoCo 作为主流的物理仿真引擎,其跨硬件扩展往往是一件令人头疼的事。GPU 与 CPU 之间的数据搬运、环境并行度的调度、训练循环的编译优化,任何一个环节处理不当都会拖慢整体吞吐。
据作者介绍,Roxie 的核心思路是通过单一统一接口来驱动 MuJoCo 的不同硬件路径。换句话说,无论底层跑在 GPU 还是纯 CPU 环境上,开发者面对的都是同一套 API,框架内部负责把仿真映射到合适的硬件通路上。这种设计对于需要在不同算力条件下做实验的团队尤其友好,避免了为不同硬件重复编写适配代码。
七个内置智能体,共享统一基类
Roxie 最直接的卖点之一是开箱即用的算法实现。框架内置了七种连续控制领域的主流算法:
- DDPG(Deep Deterministic Policy Gradient)
- TD3(Twin Delayed DDPG)
- D4PG(Distributed Distributional DDPG)
- TD4
- SAC(Soft Actor-Critic)
- MPO(Maximum a Posteriori Policy Optimization)
- PPO(Proximal Policy Optimization)
这些算法覆盖了从确定性策略梯度到最大熵方法、再到分布式价值估计的多个技术流派。值得关注的工程细节是,所有这些智能体都共享同一个 agent 基类。这意味着算法之间的差异被收敛到最小的可插拔模块中,既降低了维护成本,也让不同算法之间的对比实验更加公平——因为它们运行在完全相同的基础设施之上。
这七种算法代表了当前离散/连续控制 RL 研究的主要分支。DDPG 是最早将深度网络引入确定性策略梯度的算法;TD3 在其基础上通过双 Q 网络和延迟策略更新缓解了过估计问题;D4PG 则引入分布式价值函数,将 Q 值建模为一个分布而非标量,提升了样本效率。SAC 属于最大熵强化学习流派,通过在奖励中加入策略熵项来鼓励探索,在连续控制基准上长期表现领先。MPO 来自 DeepMind,基于 EM 框架以 KL 散度约束策略更新步长,对超参数相对鲁棒。PPO 则是策略梯度方法中工程稳定性最强的代表,通过截断重要性采样比率防止策略更新过大。七种算法共享同一基类意味着数据管道、环境交互、日志记录等基础设施完全一致,算法差异仅体现在损失函数和网络结构的最小差异上,大幅降低了「算法差异」与「工程差异」混淆带来的实验误差。
全编译循环:让硬件持续满载
Roxie 在性能上的关键设计,是把**采样(acting)和学习(learning)**两个阶段都编译成单个 XLA 程序。
这一点在 JAX 生态中是发挥框架优势的典型做法。通过将整个执行链条编译进 XLA,Roxie 确保运行期间没有任何操作需要回到主机(host)端处理。传统 RL 实现中,Python 主循环频繁介入、CPU 与加速器之间反复通信,往往成为吞吐瓶颈。而全编译循环让成千上万个并行环境能够被持续「喂料」,加速器不会因为等待数据而空转。
对于追求大规模并行仿真的研究场景,这种设计能显著提升样本吞吐效率,也是 JAX 相较于传统命令式框架的核心竞争力所在。
XLA(Accelerated Linear Algebra)是 Google 开发的领域专用编译器,最初为 TensorFlow 设计,现已成为 JAX 的核心执行后端。XLA 的工作方式是将计算图「提前编译」(AOT)成针对特定硬件优化的机器码,而非像传统 Python/NumPy 那样逐操作解释执行。JAX 通过 jit(即时编译)装饰器将 Python 函数交给 XLA 处理,编译后的函数在 GPU/TPU 上运行时几乎没有 Python 解释器开销。
在强化学习场景中,XLA 编译的另一大优势是「算子融合」:编译器会自动将矩阵乘法、激活函数、归一化等多个小操作合并为一次 GPU kernel 调用,大幅减少显存读写次数。Roxie 将采样与学习均编译进同一 XLA 程序,正是利用了这一点——整个 RL 内循环成为一个不可分割的编译单元,彻底消除了 Python 主循环在 GPU 和 CPU 之间反复握手的延迟。
5 亿步基准测试与预训练权重
为了证明框架的可用性,Roxie 附带了一套相当扎实的基准测试。作者用 5 亿步(500M-step) 的训练预算,在 dm_control 的 3 个 humanoid 任务上测试了全部 7 个智能体,并且同时覆盖了 GPU 和 无 GPU(纯 CPU) 两种运行单元。
这样的基准设计有两层意义:一方面 5 亿步的规模足以体现算法在长训练周期下的稳定性与最终性能;另一方面,同时在 GPU 和 CPU 上跑通,也直接验证了框架「统一接口驱动多硬件路径」的核心主张。
对于不想从头训练的用户,作者已将预训练检查点上传至 Hugging Face(vittorione/roxie-release-v1),可以直接下载运行。框架代码则托管在 GitHub(github.com/vittorione94/roxie)上,作者也公开邀请社区试用并反馈。
谁适合关注 Roxie
Roxie 的定位相当清晰——它不是一个大而全的通用 RL 库,而是聚焦在 MuJoCo 连续控制这一垂直方向。对于从事机器人控制、运动学习、物理仿真强化学习的研究者和工程师,Roxie 提供的多算法统一实现、全编译训练循环和跨硬件支持,都是能直接落地的实用价值。
作为一个刚发布的开源项目,Roxie 的长期生态、文档完善度和社区活跃度还有待观察。但从其工程设计思路来看,它抓住了 JAX + MuJoCo 组合的性能红利,对相关领域的从业者值得一试。
相关推荐
n8n零代码搭建AI员工:一人公司全自动朋友圈内容工作流
B站UP主原子分享用n8n零代码搭建AI员工"文书",串联大模型、飞书多维表格与微信接口,实现朋友圈文案的灵感采集、一鱼多吃与全自动分发,一人公司10分钟搞定一周内容分发。
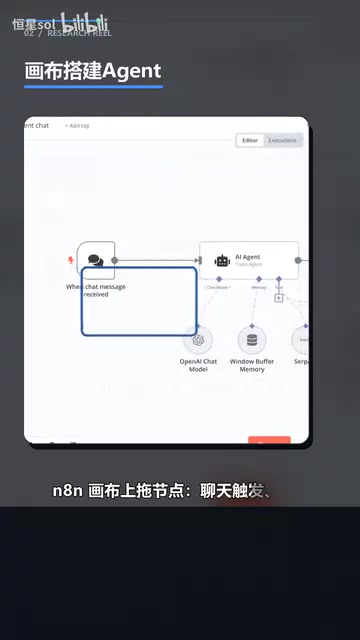
n8n:可自托管的AI工作流自动化平台深度解析
n8n是一款可自托管的AI工作流自动化平台,支持可视化节点搭建、JS/Python自定义代码、1500多个集成和9000多个模板。本文解析其低代码理念、开源生态与自托管优势,帮助团队摆脱单一AI厂商绑定。
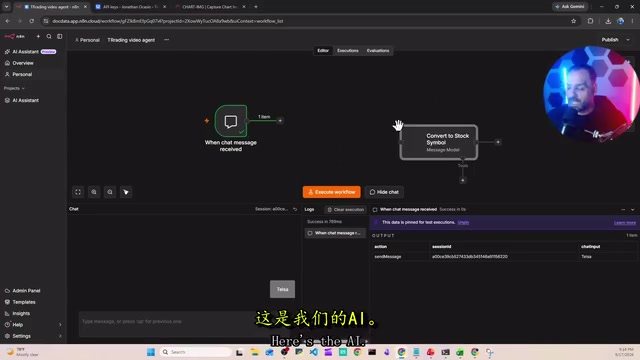
手把手教你用n8n搭建AI股票研究Agent
海外博主用n8n工作流搭建AI股票研究Agent,输入股票代码即可自动拉取行情、分析新闻情绪并输出买卖建议与信心评分。本文详解其完整架构与节点设计,包含Twelve Data免费API接入与成本优化技巧。