RTX 3090实测Qwen3 27B:峰值60 Token/s能跑动吗

RTX 3090单卡实测Qwen3 27B:Q4量化可用,MTP加速6成,接入Agent本地跑赢云端。
本文记录了一张24GB显存RTX 3090(Q4量化)运行Qwen3 27B稠密模型的全流程实测。普通推理模式约30 token/s,开启MTP2加速后可达48 token/s,速度提升约六成,但首字延迟和显存占用随之上升,适合长文本生成场景。长上下文方面,尽管官方标称26万token,实际在该显存规格下建议控制在6.4万token以内。四路并发总吞吐最高可达125.5 token/s,但单路体验提升有限。最具参考价值的是Agent实战部分:接入框架后需关闭思考模式以避免输出额度被推理过程耗尽,最终本地Qwen3以4分17秒完成坦克小游戏任务,比云端DeepSeek快约一分半钟,证明该配置具备实用的本地工具链价值。
一张二手价位的RTX 3090,到底能不能把一个270亿参数的大模型跑出实用价值?B站UP主用一张24GB显存的RTX 3090火神,对Qwen3 27B稠密模型做了一轮完整实测——从短文本、长上下文到多人并发,最后还把它接进Agent框架真做出了一个坦克小游戏。结论比预想的更乐观。
硬件与模型配置:24GB显存怎么选量化版本
测试平台是RTX 3090火神,24GB显存,GA102核心。被测模型Qwen3 27B是一个270亿参数的稠密模型,原生支持26万token上下文,同时具备图文输入和MTP(Multi-Token Prediction)能力。
量化版本的选择直接决定了能否跑得动。对于24GB显存,UP主选择了Q4量化;如果只有16GB显存,可以尝试Q3或Q2,但必须给上下文缓存预留空间,而且模型质量会随量化等级降低而进一步下滑。这是本地部署绕不开的权衡——显存、速度和输出质量三者之间很难兼得。
量化(Quantization)是将模型权重从高精度浮点数(如FP16/BF16,每个参数占2字节)压缩为低位整数的技术。Q4量化意味着每个参数只用4个比特存储,270亿参数的Qwen3 27B模型理论权重体积从约54GB(FP16)压缩到约14-17GB,才得以装入24GB显存并留余量给KV Cache(用于存储上下文的键值缓存)。Q3/Q2则进一步压缩,但精度损失会导致模型输出更容易出现逻辑错误、幻觉增加。目前主流本地推理框架(如llama.cpp、Ollama)均支持GGUF格式的分级量化,用户可根据显存大小在Hugging Face或ModelScope上直接下载对应量化版本,无需自行转换。
速度实测:MTP加速能快6成
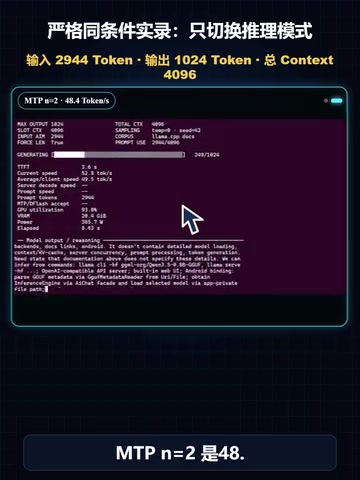
在相同输入(2944 token)和输出(1024 token)条件下,普通模式达到每秒29.9 token;开启MTP2后提升到48.4 token/s,总生成时间从37.1秒降到24.7秒。
MTP可以简单理解为一种推理加速算法,本次实测持续生成速度快了约6成。但它并非免费午餐——首字响应会稍慢,显存占用也更高。这意味着回答越长,MTP越划算;对于短平快的问答,优势反而不明显。
MTP(Multi-Token Prediction,多Token预测)是一种推理加速机制,其核心思路是在标准自回归生成的同时,用额外的预测头并行猜测后续若干个Token,若猜中则一次性确认多个输出,从而减少串行推理的轮次。这与Speculative Decoding(投机解码)思路相近,但MTP将辅助预测头直接集成在模型结构中,无需外部草稿模型。MTP2表示预测步长为2,即每次尝试一次性输出2个Token。由于推测步数越多、首次验证开销越大,短文本中收益不明显;而长文本生成时,猜中率的积累效应使加速比显著提升,这也解释了本次实测中"输出越长越划算"的现象。
长上下文的真实天花板
官方标称26万token,但实际能跑多少是另一回事。随着上下文拉长,两种模式的显存都在上升、速度都在下降。普通模式最终完成到11.4万token,MTP2完成到8.1万token,到9.8万token时未能完成。
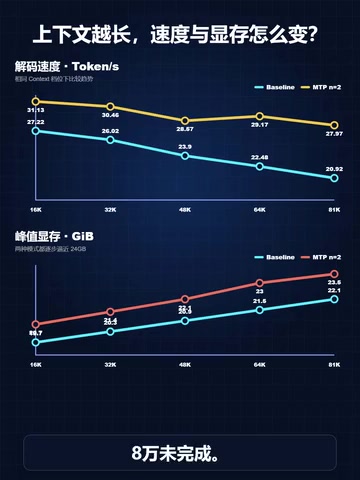
UP主给出的经验值很实在:日常使用最好控制在6.4万token左右。官方支持26万,不代表一张24GB显卡就能舒服跑满。这个提醒对打算本地部署的用户尤其重要——纸面规格和可用规格之间往往隔着一大段显存。
多路并发:吞吐量翻倍但单路受限
开启四路并发后,普通模式总吞吐达到每秒50.3 token,MTP2则冲到每秒125.5 token。不过要注意,MTP2的125.5是四路合计,单路约36 token/s,并不是每一路都能跑到125。
对于需要同时服务多个请求的场景,并发能明显提升整体吞吐效率;但对单个用户的体感速度而言,提升有限。
接入Agent实战:本地模型做出了游戏
真正有意思的部分,是把本地模型接入DeepSeek广告 Harness这个Agent框架。该框架负责调用文件、终端和浏览器,把模型输出转化为实际操作。接入后,思考模式下约每秒30 token,关闭思考模式后单任务峰值接近40 token/s。
这里UP主踩了一个值得记录的坑:Agent做长任务时最好先关掉思考模式。第一次没关,模型持续分析导致输出额度先被耗尽,任务反而没做完。关掉思考模式后,相同的坦克小游戏任务顺利完成。
结果颇为意外——同一个任务,本地Qwen3用了4分17秒,云端DeepSeek VS Pro用了5分54秒,本地反而快了一分多钟。
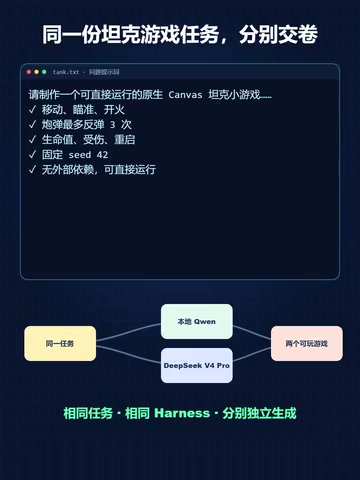
UP主也强调不要急着下排行榜结论:这只是一道小游戏任务,更应该关注做出来的东西到底能不能玩,而非单纯比拼速度。
Agent框架(代理框架)的核心作用是在大语言模型与外部工具之间搭建桥梁:模型负责"思考和规划",框架负责将模型输出的指令翻译成对文件系统、终端命令、浏览器或API的实际调用,并将执行结果反馈回模型,形成"感知—决策—行动"的闭环。思考模式(Thinking Mode)是Qwen3等新一代模型的特性,启用后模型会先输出大量内部推理过程(以<think>标签包裹),再给出最终答案,这在复杂推理任务上通常更准确,但会大幅消耗输出Token配额。在Agent长任务场景下,思考过程本身可能占满单次最大输出限制,导致实际行动指令还未生成任务就被截断,这正是UP主踩坑的根本原因。
使用建议:这套配置适合谁
综合来看,一张24GB的RTX 3090已经能把27B模型跑得相当实用。UP主给出的实操建议值得收藏:
- 常规回复可以开启MTP加速;
- 接入Agent时先关闭思考模式,避免额度浪费;
- 多任务场景可以尝试四路并发;
- 长文档处理尽量控制在6.4万token以内。
这套配置不一定适合所有人,但如果你在意数据隐私、倾向本地工具链、并希望控制成本,一张RTX 3090确实能干不少活。对于预算有限又想体验大模型本地部署的开发者和爱好者来说,这是一个性价比值得认真考虑的方案。
相关推荐

OpenAI牵手IndyCar豪门:AI如何重塑赛车调校策略
OpenAI与IndyCar豪门车队Chip Ganassi合作,用AI从海量赛车数据中筛选关键信号,辅助弹簧、减震器等调校决策与赛车策略。本文解析AI如何在高压竞技场景中放大专家判断力。

DeepSeek Harness 2.0实测:原生图像、提示缓存与可控子代理
DeepSeek Harness框架随V4.1 Flash升级,新增原生图像输入、提示缓存复用、文件预览与可控子代理。本文基于B站UP主实测演示,解析0.1.5候选版的核心变化与真实体验。

Cursor低价账号避坑指南:共享号与破解工具的真实风险
深度拆解Cursor低价账号、共享号与破解工具的三种套路及真实风险,分析API中转降质、封号锁设备等问题,帮你理性判断是否选择第三方代充服务。