如何驾驭前沿大模型:一场关键演讲引发的思考

解析「驾驭前沿模型」的行业内涵:提示工程、评估体系、成本优化与安全护栏四大支柱
一条关于某公司AI副总裁在行业大会演讲「如何驾驭前沿模型」的推文,折射出当前AI工程化落地的核心命题。文章围绕「前沿模型」这一概念展开,指出它们是由头部实验室训练的大规模基础模型,能力强大但伴随高成本与不可预测性。「驾驭」的实质是在模型强大能力与落地约束之间寻找平衡,具体实践涵盖提示工程与上下文设计、可量化的评估体系建设、通过模型路由和缓存等手段控制推理成本,以及输入输出层的安全护栏设计。文章最终指出,行业竞争格局正从「拥有模型」转向「驾驭模型的工程能力」,系统化运用前沿模型的能力已成为真正的核心竞争力。
一条推文背后的信号
近日,某公司在社交平台发布消息,称其AI副总裁在某AI大会上发表了关于「如何驾驭前沿模型(frontier models)」的主题演讲,并附上了演讲视频链接。这条看似简短的推文,实际上折射出当下整个行业的核心议题——当大模型能力不断突破边界时,企业与开发者究竟该如何有效地「驾驭」它们。
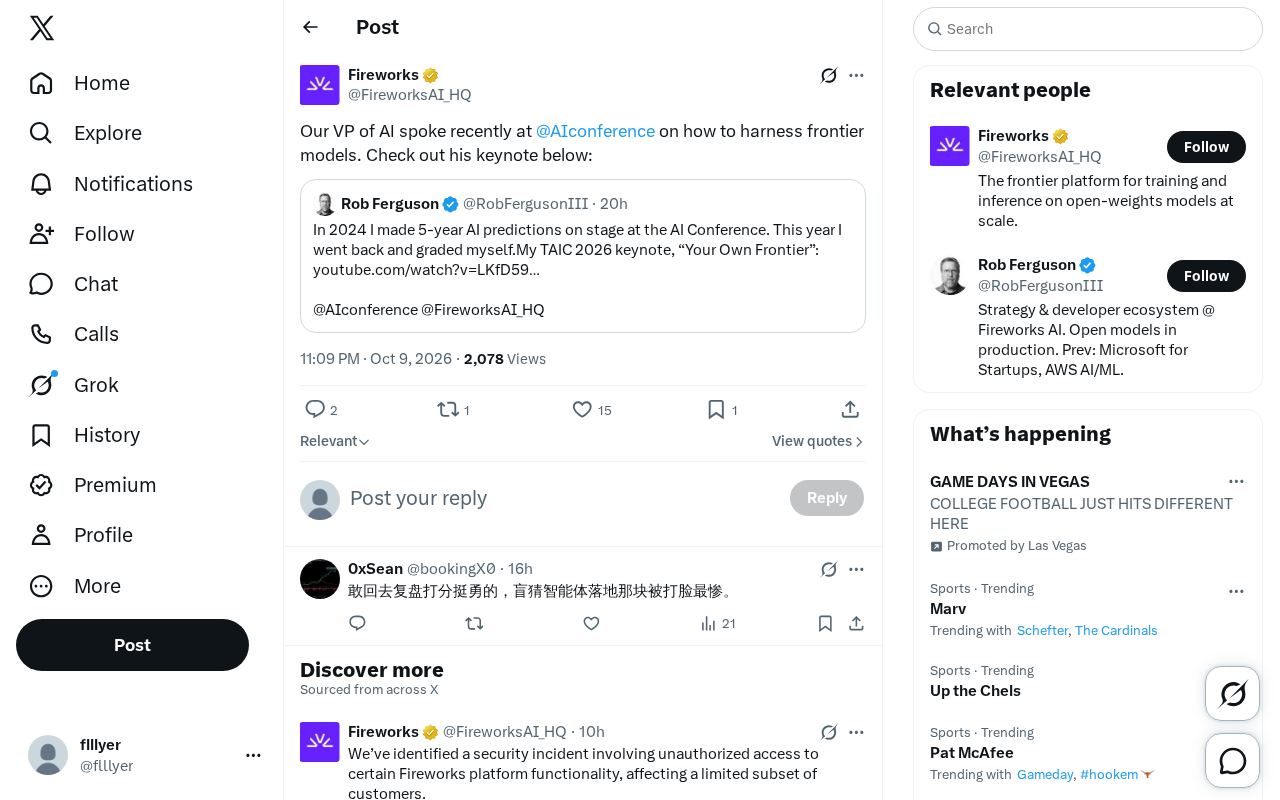
受限于原始素材仅提供了一句话的转发文案,具体演讲内容尚无法完整还原。但「harness frontier models」(驾驭前沿模型)这一表述本身,已经是近两年AI工程化讨论中的高频关键词,值得围绕它展开延伸分析。
什么是「前沿模型」
「前沿模型」通常指处于能力最前列的大规模基础模型,例如参数规模庞大、具备多模态理解、复杂推理与长上下文能力的通用模型。这类模型往往由少数头部实验室训练,能力强但也伴随着高成本、高不确定性和潜在的安全风险。
对企业而言,前沿模型既是机遇也是挑战:它们能够解锁过去难以实现的产品形态,但同时也带来了幻觉控制、成本管理、合规性以及可预测性等一系列工程难题。所谓「驾驭」,本质上就是在模型强大能力与实际落地约束之间找到平衡点。
从学术与政策层面看,「前沿模型」(Frontier Model)这一概念近年来已超出技术圈,进入监管讨论的核心。美国、欧盟等主要经济体在制定AI法规时,均将「前沿模型」或「通用人工智能系统」(GPAI)单独列出,要求开发者履行更严格的透明度与安全评估义务。目前公认属于前沿模型阵营的包括 OpenAI 的 GPT-4o 系列、Anthropic 的 Claude 3 系列、Google 的 Gemini Ultra 以及 Meta 的 Llama 3 大参数版本等。衡量是否属于「前沿」通常参考训练算力阈值(如欧盟 AI 法案以 $10^{25}$ FLOP 为基准线)、跨领域基准测试表现,以及是否具备涌现能力(emergent capabilities)——即在训练目标之外自发展现出的推理、代码生成或工具使用能力。正是这种涌现性既赋予前沿模型突破性价值,也使其行为难以完全预测,从而催生出「驾驭」的需求。
「驾驭前沿模型」通常包含哪些实践
从公开行业经验来看,一场关于驾驭前沿模型的演讲,大概率会覆盖以下几个方向:
1. 提示工程与上下文设计
如何通过结构化的提示、系统指令和上下文注入,让通用模型稳定地完成特定任务,是最基础也最关键的一环。良好的上下文设计往往比盲目追求更大模型更具性价比。
2. 评估与可靠性
前沿模型的输出具有随机性,企业需要建立一套可量化的评估体系(evaluation),对准确率、幻觉率、鲁棒性进行持续监控,而非仅凭直觉判断模型「好不好用」。
LLM 评估(LLM Evaluation)已发展为一个独立的工程子领域。常见评估框架包括:基于参考答案的自动化指标(如 BLEU、ROUGE,主要用于翻译或摘要任务)、基于大模型打分的 LLM-as-a-Judge 方法(用另一个强模型对输出进行多维评分),以及面向特定业务的人工标注流水线。幻觉(Hallucination)检测尤为复杂,业界常见策略包括一致性检验(对同一问题多次采样后比对答案分歧)、基于检索的事实核查(RAG + 验证层)以及专门的幻觉检测模型。此外,A/B 测试框架和影子流量(shadow traffic)机制也被广泛用于在真实生产环境中对比不同模型版本的表现,确保评估结论与线上实际体验一致,而非仅停留在离线基准上。
3. 成本与延迟权衡
调用前沿模型的推理成本不容忽视。实践中常见的策略包括模型路由(简单任务用小模型、复杂任务才调用前沿模型)、缓存、批处理等,以在体验与成本之间取得平衡。
模型路由(Model Routing)是当前降低前沿模型调用成本的主流架构模式之一。其核心思路是训练一个轻量级分类器或利用规则引擎,预判每条请求的复杂度,将简单查询分发给小型低成本模型(如 GPT-4o mini、Claude Haiku),仅将真正需要深度推理的任务送往旗舰模型。代表性开源工具包括 RouteLLM、LiteLLM 等。在延迟优化方面,投机解码(Speculative Decoding)技术允许用小模型并行草稿、大模型验证,可在不损失输出质量的前提下显著降低首 token 延迟(TTFT)。提示缓存(Prompt Caching)则由 Anthropic、OpenAI 等主流 API 提供商原生支持,对于系统提示固定的场景可减少 60-80% 的重复计算费用。这些技术的组合运用,正是「驾驭前沿模型」在成本层面的核心工程能力。
4. 安全与护栏
随着模型自主性增强,输入输出的审查、权限控制与行为约束变得愈发重要。「驾驭」一词也隐含着对风险可控性的强调。
为什么这类演讲值得关注
当一家公司专门设立「VP of AI」这样的高级岗位,并派其在行业大会上分享驾驭前沿模型的方法论,说明AI能力的应用已从早期的尝鲜阶段,进入到系统化、工程化的深水区。企业关注的不再是「能不能用大模型」,而是「如何用好、用稳、用得起」。
这也呼应了行业趋势:真正的竞争力正在从「拥有模型」转向「驾驭模型的工程能力」。谁能更高效地把前沿模型的能力转化为可靠的产品体验,谁就能在落地竞赛中占据优势。
结语
受原始素材信息量限制,本文无法呈现该演讲的具体观点与数据,建议读者关注原始视频以获取第一手内容。但「如何驾驭前沿模型」这一命题,确实是每一个希望将大模型投入生产的团队都绕不开的核心课题——它关乎提示设计、评估体系、成本控制与安全护栏的综合能力建设。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。