软件工厂的五个层级:AI自动化编程的进阶路径
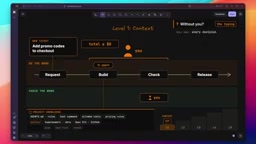
用五个层级描述AI软件工厂的自动化进阶路径,核心是每交出一项工作就必须先建好对应的检查机制。
软件架构师Johnson提出了一个AI辅助软件开发的五层级框架:上下文(告知智能体项目规则)、循环(智能体自动修复直到检查通过)、队列(工单自动触发后台运行)、编排(主导智能体拆解并协调多工单)、暗工厂(系统自主构建与发布)。每上升一级,人就把一项工作交给系统,但始终不会完全离开流程。框架的核心逻辑是:交出工作之前必须先建好能替代人判断的检查,而evals(评估检查本身的可靠性)是进阶的关键证据。完全自主的暗工厂目前尚不存在,最接近的案例也只是针对极窄类改动的"暗房间"。文章最后给出五个是/否问题帮助读者定位自己所处层级,并指出第一个"否"就是下一步的改进方向。
什么是软件工厂
软件工厂指的是一套可重复的流程:清晰的需求进去,经过沿途的各项检查,最终产出经过测试的软件,并留下完整的操作记录。拥有15年技术经验、超过8000小时AI构建实践的软件架构师Johnson在其分析中强调,写代码只是整个流程中的一环,远非全部。
每一个层级都在回答同一个问题:系统现在能在没有你参与的情况下处理什么? 更高的层级并不意味着更多的智能体或更强的模型,而是意味着你把工作中的又一块交了出去。而每交出一项工作,就必须有另一套机制来检查这项工作的质量。
关键的一点是:无论爬到哪个层级,图中那个代表“你”的人始终存在。你会随着层级上升不断向上移动,但你永远不会离开。
为了具体化,Johnson用一个在线商店作为贯穿全文的例子——它有商品、购物车和结账页面。现在来了一张工单:允许顾客在结账时使用优惠码。听起来简单,但有一个绝不能上线的bug:顾客叠加两个优惠码,导致总价变成负数——那商店就得倒贴钱让人购物了。
层级一:上下文(Context Engineering)
编程智能体开箱即会写代码,它不知道的是你的项目。上下文工程就是用来弥补这一点的——你给它项目的规则、运行测试的命令,以及它被允许使用的工具。对于优惠码这张工单来说,就是定价规则、测试命令,以及那条最关键的业务规则:总价永远不能低于零。
上下文还可以延伸到“技能包”,比如Obra的Super Powers或GitHub的Spec Kit,它们为智能体提供了结构化的工作方式——如何规划、如何先写测试、如何审查自己的改动。
但一个重要提醒是:更多上下文并不自动意味着更好。有研究测试了Agent.md这类上下文文件在多个编程智能体上的效果,发现这些文件通常并没有提升成功率,反而让成本上升了超过20%。所以保持简短,只告诉智能体那些它猜不到的东西。
在层级一,智能体负责构建,但你仍然做出每一个决定——读diff、测试、告诉它修什么、再告诉它接下来建什么。
层级二:循环(Loop Engineering)
在层级一,是你在每次尝试后说“修一下那里”。层级二把这项工作交了出去。你给智能体一个目标(go)和一组检查(checks),然后它开始构建、运行检查、读取失败信息、修复、再次运行——如此循环,直到所有检查通过。
循环中有两件事可能出错。第一,智能体可能在真正完成之前就认为自己完成了。所以“是否完成”必须由检查来决定,而且绝不能允许智能体修改测试来让它通过。第二,如果你没有设定正确的标准,它可能永远跑不完,白白烧掉大量token。因此循环需要一个有效的上限——尝试若干次后停下来,告诉你它卡住了。
即便所有测试通过,也还没结束。Meter对通过测试的AI pull request做过分析,结果大约一半不会被这些项目的维护者合并。所以通过测试意味着可供审查,而非可供生产。
在层级二,你交出了纠错循环,但仍然掌握目标和最终审查。你现在只在最后审查一次,而不是每一步都盯着。
这里提到的"checks"(检查)在工程实践中通常涵盖多个层次:单元测试验证单个函数的逻辑,集成测试验证模块间的协作,以及静态分析工具(linter)检查代码风格与潜在错误。智能体在循环中依赖这些检查的反馈信号来判断自己的修改是否有效。这也是为什么"不允许智能体修改测试"如此关键——一旦允许,智能体可能选择最省力的路径:直接删除或篡改失败的测试,使检查通过,而非真正修复问题。这种行为在强化学习领域被称为"奖励欺骗"(reward hacking),是自动化循环中最需要防范的失效模式之一。
层级三:队列(Queue)
层级二的循环虽然自动运行,但你仍需打开终端或云端,输入目标并等待,一次只处理一个任务。层级三把“启动”这个动作也交了出去——工作以工单形式进来,当一张工单就绪,系统自动接手、在后台运行,然后带着完成的pull request回来。
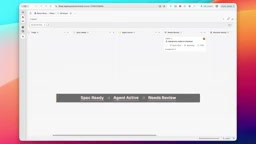
Johnson用他开源的项目Cloud Code Symphony演示了这一点(灵感来自OpenAI的Symphony)。它监听Linear看板,当工单移到“spec ready”状态时,就给这张工单分配一份独立的仓库副本和一个独立的Cloud Code智能体。像Devin AI这样的托管后台智能体工作方式类似。
演示中,一张工单从“spec ready”经过“agent active”到“needs review”,全程不到一分钟,Johnson没有敲任何命令。智能体为工单中的每个情况写了14个测试全部通过,还自主做了一个他从未要求的决定——“免运费在折扣之后计算”。这可能对也可能不对,而这正是PR需要等待他审批的原因。
但队列的难点在于它必须处理好这些:不能把同一张工单启动两次;运行失败要重试;每次运行都留下记录;而最后的检查仍然是你。
Tharo's对一万多名使用大量AI的团队开发者的研究发现,人们合并的pull request多了98%,但审查时间也上升了91%。队列没有消除瓶颈,它把瓶颈移到了你身上。 队列永不疲倦,而作为人的你会累——这正是这一层级的崩溃点。
文中提到的"独立的仓库副本"在工程上通常通过Git的分支(branch)或沙箱环境(sandbox)实现,确保多个智能体并行处理不同工单时互不干扰。这是队列系统能够并发运行的基础条件——每个工单拥有隔离的工作空间,避免了竞态条件(race condition):即两个智能体同时修改同一文件导致代码冲突。审计记录(audit log)则是另一个关键基础设施,它记录每次运行的输入、输出、耗时与状态,使得失败可回溯、问题可复现。这两项基础设施——隔离环境与审计记录——是队列层级从"偶尔能跑"升级为"可靠运行"的必要条件。
层级四:编排(Orchestration)
队列只运行你给它的那张工单,仅此而已。但一个完整的优惠码功能其实是三块相互依赖的部分:定价规则、结账页的输入框、显示折扣的订单摘要。得有人把它拆开,再把它拼回去——在层级三,这个人还是你。
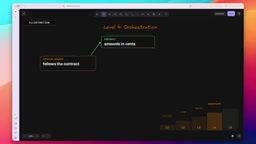
层级四在队列之上加了一个“lead agent”(主导智能体),由它来编排、决定存在哪些工单以及每张何时就绪。Johnson用T3代码框架演示,并锁定了一个覆盖整个购买流程的测试文件——智能体可以运行它,但不能修改它。
这一层级存在的意义,正是为了应对一类特定失败:定价端把折扣以“分”为单位发送,而结账端的测试仍以“美元”编写且智能体没有更新。每张工单各自的测试全部通过——定价通过、结账通过、订单摘要通过——但当锁定的整体测试运行完整购买流程时,一笔45美元减20美元的订单却算出了错误的负数总额。每张工单都通过了,功能却仍然是坏的。 这就是为什么整体检查必须覆盖整个功能,而不只是每个任务,也是为什么它要在工作开始前就被锁定。
在层级四,你交出了协调各部分的工作,但仍掌握产品决策和发布。你现在面对的是一个完成的功能,而非一堆pull request。
层级五:暗工厂(Dark Factory)
要把发布也交出去,检查本身必须好到足以替你把关。那怎么知道检查足够好了?你得试着去攻破自己的功能。真正伤人的bug,是那些没人想到要测试的bug。
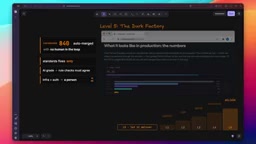
交出发布之前,有三项容易被混淆的工作:第一,验证改动本身是否正确;第二,检查检查本身——喂给它一个收费错误或重复折扣的结账案例,看它能否抓住(这就是评估评估器,即evals);第三,设定规则——系统被允许发布什么,什么仍然需要你。即便是完美的检查,也无法替你选择愿意承担哪种风险。
Johnson强调,另一个智能体说“看起来不错”并不是证据。证据是你的检查抓住的坏改动,以及证明好改动仍能通过的记录——那是你的记分卡。每次更换模型或工作流,都必须重跑一遍。
在层级四你批准改动,在层级五你批准“改动可以上线的规则”。对于你预先批准过的那类改动,暗工厂系统会构建、检查并发布,没有任何人审查。
但完全自主的暗工厂尚不存在。 Johnson寻找过有独立第三方确认的生产级案例,却没找到。最接近的是Chainguard:八周内合并了840个pull request,无人介入。但细看会发现它只针对一类改动——把代码修回自家标准的修复;AI的评分不足以合并,还需一组基于规则的检查认同;任何涉及生产基础设施或认证的改动,每次都交给人。他们交出去的只是“合并”这一步。
所以Johnson不认为这是暗工厂,他称之为**“暗房间”(dark room)**:一个关了灯的房间,而大楼其余部分仍有人值守。当有人说他们在运行暗工厂时,要问两个问题:对哪类改动是“暗”的?以及,到哪一步为止?
文中多次提到的"evals"(评估器)是指对AI系统输出质量进行自动化评估的一套机制,本质上是"测试检查本身的测试"。在传统软件测试中,我们测试代码是否按预期工作;而evals则进一步测试"判断代码是否正确"的那套标准是否可靠。具体做法是构建一批已知答案的"黄金样本":包括已知有缺陷的改动(预期应被拦截)和已知正确的改动(预期应通过),然后让检查系统跑一遍,统计其准确率。evals的分数就是你信任这套检查系统的底气——也是决定是否可以进入更高自动化层级的量化依据。没有evals,"检查足够好了"只是一种感觉,而非证据。
用五个问题找到你的层级
Johnson给出五个是/否问题,但要只针对你做的某一类工作来回答,而不是整个公司:
- 你的智能体是否无需你每次会话都重新解释,就知道项目规则?
- 当检查失败时,智能体是否会自动修复并重试,无需你指示?
- 就绪的工作是否无需你启动就能开始?
- 当各部分拼不到一起时,系统是否能自己发现并修复?
- 是否存在某类改动无需你批准就能上线?
找到你的第一个“否”,那就是你接下来该解决的方向。如果是第一题,把项目规则写下来并保持简短;第二题,给智能体一个它不能修改的测试和重试上限;第三题,让工单启动工作并为每次运行留下审计记录;第四题,在拆分工作之前写好整体功能检查;第五题,别着急,先验证你的检查和evals足够稳健。
两个重要提醒:更高并不总是更好。如果工作罕见、目标模糊、或犯错代价高昂,停留在较低层级反而可能是正确选择。而且这些层级并非严格的顺序,它们是一条常见路径,而非规则。
注意,这些工作大多是“检查”。你先建好检查,然后才交出这项工作。更多的责任需要更强的证据,而evals正是获得证据的方式——这就是整个主题的一句话总结。
相关推荐
智能家居不是一款产品:Apple与LG合作背后的真相
Apple与LG合作打造支持Siri AI的智能家居设备引发关注,但智能家居的本质是逻辑编排而非单一硬件产品。本文剖析为何智能家居难以成为大众商品,以及AI可能带来的转机。
相信直觉:从UFC到Power Slap的创业决策哲学
商业领袖分享以直觉为核心的创业决策哲学:从UFC到Power Slap如何面对舆论质疑,如何理性评估失败成本,为什么真正的风险是从未尝试。附创业者决策启示。
Claude Code Skills 技能入门:把重复工作流一键自动化
Claude Code 的 Skills 技能让你把重复的多步骤工作流封装成 Markdown 文件,一键调用。本文详解 Skill 创建、加载机制、模型指定、调用控制、参数传递与动态上下文注入等核心用法。