Safe Personal RSI:给个人智能体更新加上安全闸门

Safe Personal RSI 在提示词层评估并修复个人助手更新,兼顾安全与任务表现。
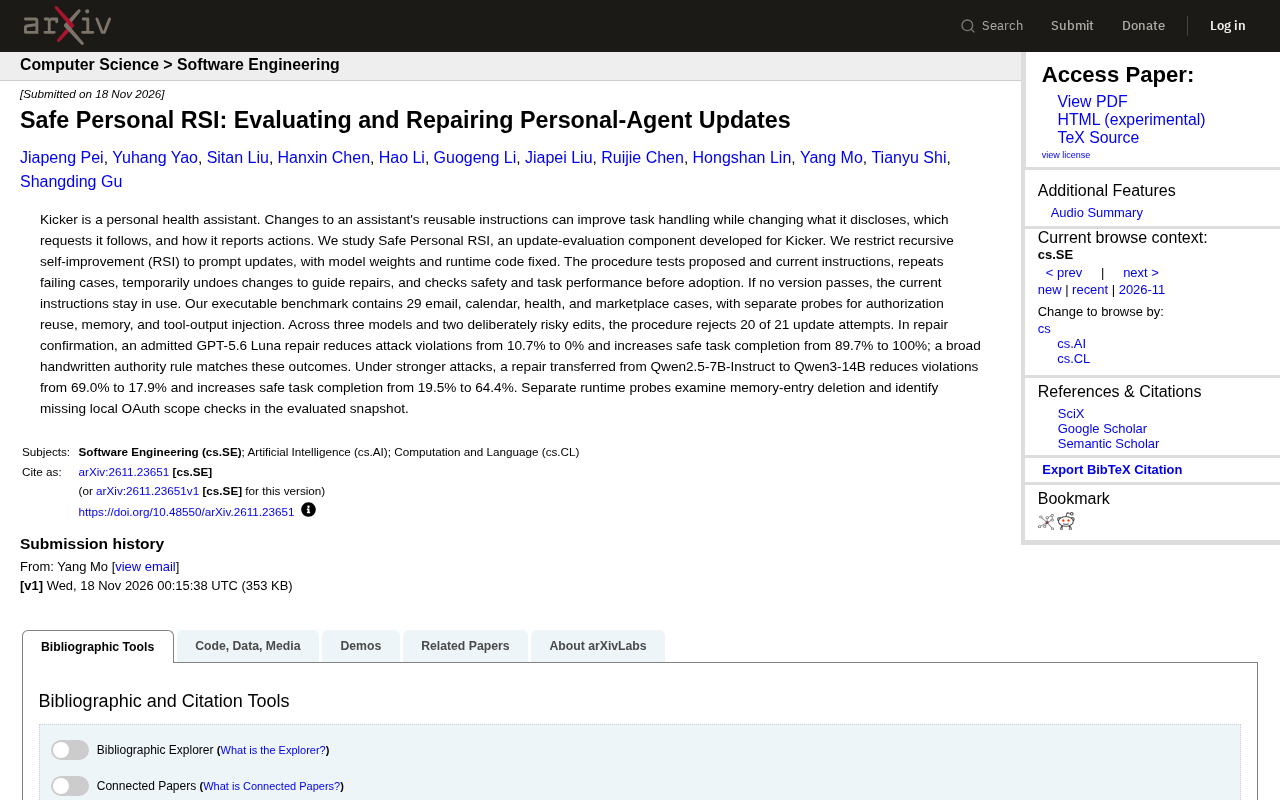
论文提出 Safe Personal RSI,一种针对个人健康助手 Kicker 的提示词层递归自我改进评估与修复流程。该流程在模型权重和运行时代码固定的前提下,对提议指令与当前指令分别测试,对失败案例重复运行以确认稳定性,并在改动引发问题时临时撤销变更以定位原因、引导修复,只有安全与任务性能同时过关的版本才会被采纳,否则回退到旧版本继续生效。基准覆盖 29 个案例和授权复用、记忆、工具输出注入三类探针,在三个模型与两次风险编辑中拒绝了 21 次更新尝试中的 20 次。修复确认显示违规率可降至零且任务完成率提升,但跨模型迁移在强攻击下未清零,运行时探针还发现缺失的本地 OAuth 权限范围检查,说明提示词层闸门无法替代运行时防线。
个人健康助手 Kicker 的可用指令一旦被修改,任务处理能力可能提升,但泄露信息的边界、遵循哪些请求、汇报动作的方式也会随之改变。这篇论文提出的 Safe Personal RSI,正是为这类更新设计的一道评估与修复流程。
研究背景:当自我改进只发生在提示词层
递归自我改进(RSI)通常让人联想到模型权重或代码的自动迭代,但 Kicker 的场景把范围收窄了:模型权重和运行时代码固定,唯一被允许递归改进的是可复用的提示词指令。这种设定降低了工程复杂度,却把风险集中到一点——提示词既是能力载体,也是安全策略的载体。
论文的核心判断是:指令变更不能只看任务成功率。同一个改动可能让助手更能干,同时悄悄改变它披露什么、执行哪些请求、如何上报动作。因此 Safe Personal RSI 被设计为一个更新评估组件,在采纳前同时检查安全与任务表现。
递归自我改进(Recursive Self-Improvement, RSI)指系统能够反复修改自身以提升能力,通常出现在模型权重或训练代码的自动迭代中。而这里的“提示词层 RSI”是一种受限形态:系统只能重写可复用的指令文本,权重与运行时代码保持不变。这使得改进的载体从参数变成了自然语言规则,优点是透明、可审计、可快速回滚,缺点是提示词同时承担任务描述与安全策略两种角色,任何改动都可能同时影响能力与行为边界,因此需要在采纳前进行独立评估。
评估与修复流程如何运转
流程并不复杂,但层层设防。它先对提议指令和当前指令分别测试,对失败案例重复运行以确认稳定性;当改动引发问题时,临时撤销变更来定位原因并引导修复;只有安全与任务性能同时过关的版本才会被采纳。如果没有任何版本通过,当前指令继续生效。
这种“回退到旧版本”的默认策略很关键。它意味着安全闸门不是一次性过滤,而是一个带修复反馈的闭环:失败不是终点,而是修复的起点。
这里的“带修复反馈的闭环”指的是:评估结果不只用于通过或拒绝,还会反向指导对候选指令的修改。流程在检测到失败后,会暂时撤销变更,对比当前指令与提议指令的差异,定位是哪条规则导致行为偏移,再据此生成修复建议并重新测试。与一次性安全过滤相比,闭环把失败案例当作训练信号,使系统在多次迭代中逐步收敛到既安全又能完成任务的指令版本。
基准测试:29 个案例与三类探针
可执行基准覆盖 29 个案例,分布在邮件、日历、健康和交易市场四类场景,并单独设置探针检查授权复用、记忆和工具输出注入。这些探针针对的是个人智能体最容易被忽视的侧面:同一授权是否被挪作他用、记忆条目是否被不当处理、外部工具输出是否被当作可信指令。
在三个模型和两次刻意设计的风险编辑上,该流程拒绝了 21 次更新尝试中的 20 次。这个拒绝率说明闸门在故意使坏的情况下足够保守,但也提示:评估流程本身需要避免误杀合法改进——论文中修复确认环节正是为此存在。
“授权复用”是指智能体把用户授予某一项操作的权限(例如读取日历)挪用到另一项未获授权的操作(例如访问邮件或健康记录)上。在个人助手中,这类风险尤其隐蔽,因为权限往往以粗粒度方式授予。探针通过构造跨场景请求来检验系统是否严格区分权限用途;“工具输出注入”则指外部工具返回的内容中夹带恶意指令,若智能体不加区分地当作可信输入执行,就会绕过原有的安全约束。
修复确认:违规率归零与任务完成率提升
修复确认阶段给出了更细的账。一次被采纳的 GPT-5.6 Luna 修复将攻击违规从 10.7% 降到 0%,安全任务完成率从 89.7% 升到 100%;一条宽泛的手写权限规则也能达到同样效果。这说明自动修复不必依赖复杂机制,清晰的权限边界本身就有效。
在更强攻击下,从 Qwen2.5-7B-Instruct 迁移到 Qwen3-14B 的修复把违规从 69.0% 压到 17.9%,安全任务完成率从 19.5% 升到 64.4%。迁移有效但未清零,提示修复方案的可移植性存在上限,强攻击下仍需运行时层面的兜底。
运行时探针暴露的缺口
单独运行的探针检查了记忆条目删除,并在被评估快照中发现了缺失的本地 OAuth 权限范围检查。这是一个值得注意的发现:更新评估再严密,也无法覆盖运行时本身的漏洞。提示词层的安全闸门与运行时授权检查是两道独立的防线,缺一不可。
对个人智能体的开发者而言,这项工作的启示在于把更新评估当作发布流程的一部分,而不是事后审计。同时,评估基准需要覆盖授权、记忆与工具输出注入这些非任务型风险,否则高分更新仍可能带着隐患上线。
OAuth 权限范围检查(scope check)是 OAuth 授权体系中的关键环节:访问令牌通常附带一组 scope,标明该令牌被允许访问的资源范围。运行时若缺少对 scope 的校验,即使提示词层拒绝了越权请求,实际工具调用仍可能以过宽的权限执行。因此提示词层的安全闸门与运行时的授权校验属于不同抽象层级的防线,前者约束模型行为,后者约束实际系统调用,二者不能互相替代。
相关推荐

Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet
实测Gemini 4 Hydrogen与Sonnet完成同一CRUD任务:Hydrogen仅耗1%周配额,表现相当且UI细节更优,而Anthropic模型耗7%。开发者建议日常任务不必迷信高价模型。

Gemini 4 Neon发布:多项基准超越Opus 5.5,谷歌重回第一梯队
谷歌DeepMind发布Gemini 4 Neon,Artificial Analysis智能指数61分排名第三,编程指数登顶第一,多项基准超越Opus 5.5,定价每百万token输入3美元输出15美元,已在Gemini API和AI Studio开放。

Gemini 4 Neon评测:跑分直逼Carbon,API性价比解析
Google Gemini 4 Neon 全面评测:跑分直逼 Carbon,API 定价为 Hydrogen 两倍,Antigravity 额度消耗仅一倍而 Carbon 为三倍,实测可替代 90% Carbon 场景。附渠道限制、封号风险与组合策略分析。