SageMaker AI 笔记本上手:Strands Agents 构建智能体教程
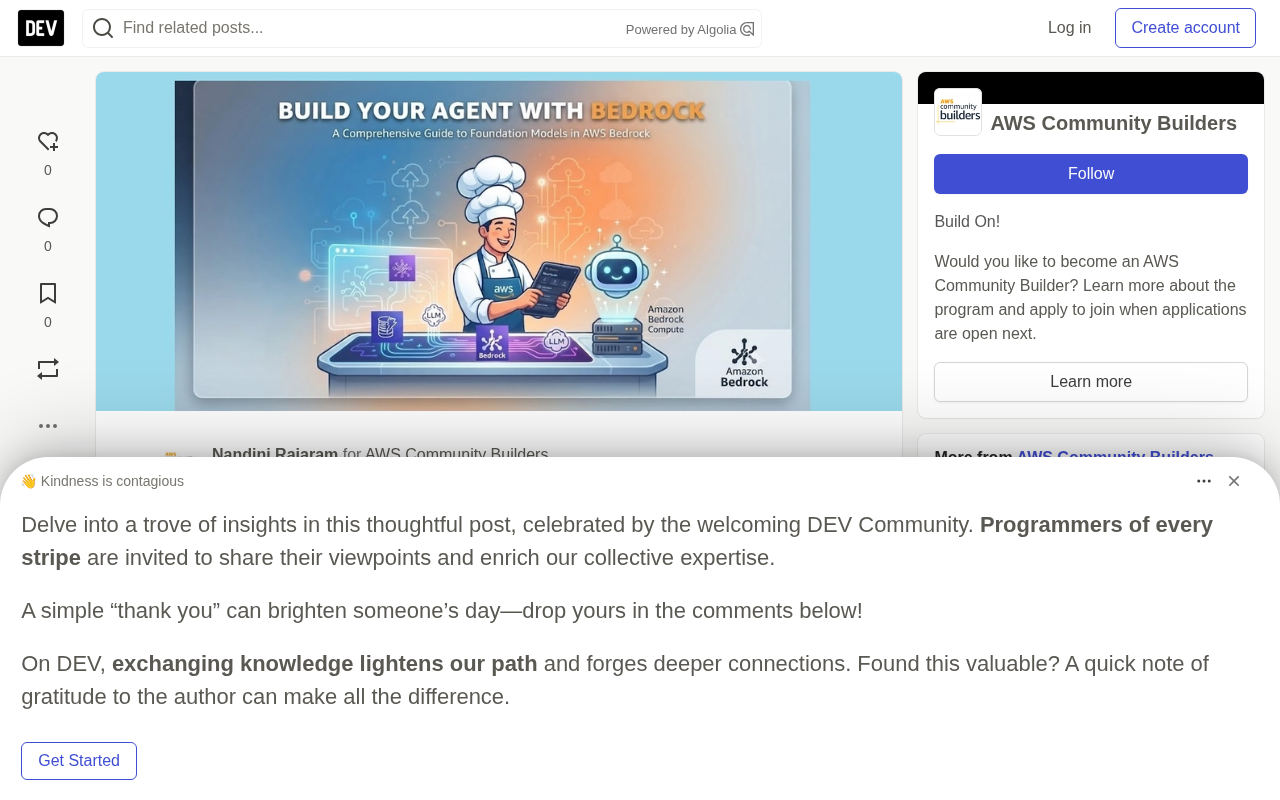
用 SageMaker 笔记本加 Strands Agents SDK 快速搭建可调用工具的 AI Agent。
本文梳理了在 AWS 上用 SageMaker AI 笔记本和开源 Strands Agents SDK 构建 AI Agent 的完整流程。Strands Agents 通过 @tool 装饰器把 Python 函数暴露给模型,由模型自主判断调用哪个工具,再结合 Amazon Bedrock 的 nova-lite 模型完成推理。文章按环境准备、依赖安装、Bedrock 连接、计算器与天气工具定义、Agent 组装、递进测试的步骤展开,并以组合问题验证多工具协作能力。同时重点提示了成本控制(按运行时长与存储计费、Bedrock 单独计费)和权限配置(bedrock:InvokeModel、模型区域启用、凭证链规范)两类常见陷阱,为工程师提供了一条成本可控的入门路径。
在 AWS 上构建 AI Agent 并不需要复杂的部署流程。借助 SageMaker AI 笔记本实例和开源的 Strands Agents SDK,开发者可以在熟悉的 JupyterLab 环境中快速搭建一个能调用工具、执行任务的智能助手。本文基于一篇 Dev.to 社区的实操教程,完整梳理从环境准备到 Agent 运行的全过程,并补充社区中值得关注的成本与权限注意事项。
为什么要用 SageMaker + Strands Agents 组合
Strands Agents 是一个开源的 Python SDK,核心理念是把 AI 模型与外部工具连接起来。它不是让模型单纯回答问题,而是让它能够「做事」——理解用户请求、决定调用哪个工具、拿回结果再组织成自然语言回复。
可以把它想象成一个个人助理:你问「班加罗尔天气怎么样」,AI 判断需要查天气,于是调用真实的天气 API,最后把当前气温、湿度、风速告诉你。整个过程模型自主决策,无需硬编码判断逻辑。
选择 SageMaker AI 笔记本作为开发环境有几个现实优势:无需本地配置 AWS 凭证链、执行角色天然集成 IAM 权限管理、JupyterLab 交互式调试工具调用过程直观。配套的 Amazon Bedrock 则提供了模型托管能力,本例使用 amazon.nova-lite-v1:0 作为基础模型。
Strands Agents SDK 的技术定位
Strands Agents 是 AWS 于 2025 年开源的轻量级 Agent 框架,采用「模型驱动」而非「流程编排」的设计哲学。传统工作流式框架需要开发者预先定义状态机或 DAG 来决定工具调用顺序,而 Strands 把决策权交给模型本身:通过 system prompt 描述可用工具,模型在推理时输出结构化的工具调用意图,SDK 负责执行并将结果回灌给模型,形成多轮循环直至任务完成。其核心抽象只有三个——Agent(编排容器)、@tool(函数即工具)、Model Provider(模型后端,本例为 BedrockModel)。这种极简设计降低了入门门槛,但也意味着 Agent 的行为高度依赖模型本身的指令遵循与工具选择能力,换用较弱模型时可能频繁出现误调用或漏调用。
Amazon Bedrock 的角色
Bedrock 是 AWS 的模型托管服务,通过统一 API 提供 Anthropic Claude、Amazon Nova、Meta Llama、Mistral 等多家厂商的基础模型,无需自行部署推理端点。它按 token 用量计费,与 SageMaker 笔记本的计算费用完全独立。调用 Bedrock 需要 IAM 权限 bedrock:InvokeModel,且每个模型必须在目标区域显式申请开通——这是新手最常见的踩坑点,因为控制台可以看到模型列表,但未开通时调用会直接返回 AccessDeniedException。
环境准备:创建笔记本实例
进入 AWS 控制台后,从左侧面板找到 Notebooks 入口,点击创建笔记本实例。命名后其余配置保持默认即可。实例状态会经历从 Pending 到 InService 的转变,通常需要几分钟等待。
实例就绪后点击「Open JupyterLab」进入 IDE,在 Notebooks 区域选择 conda_python3 内核新建 ipynb 文件,右键重命名为 SimpleAgent.ipynb 即可开始编写代码。
成本控制不可忽视
教程作者专门用一节强调费用问题,这一点在实际操作中很容易被忽略:
- 计费方式:按笔记本运行时长、存储用量及其他 AWS 服务综合计费
- 免费额度:符合条件的用户前两个月每月可获 250 小时
ml.t3.medium使用时长 - 实例选型:开发阶段建议先用小规格实例
- 及时停止:用完立即 Stop,但要注意存储费用在停止后仍可能产生
- Bedrock 单独计费:调用模型会产生额外费用,与笔记本费用分开计算
- 预算告警:建议设置 AWS Budget 监控花费
构建 Agent 的完整步骤
第一步:安装依赖
在第一个单元格中安装 Strands Agents、boto3 和 requests 库。后两者分别用于 AWS 服务调用和天气 API 请求。
第二步:配置 Bedrock 连接
导入必要的模块后,从环境变量读取 AWS 区域和模型 ID,并提供默认值。代码中通过 STS 的 get_caller_identity() 做早期凭证验证,打印出当前身份 ARN 和配置信息。
教程特别提醒:在 SageMaker 环境中应优先使用笔记本的执行角色,不要硬编码访问密钥。
第三步:创建计算器工具
通过 @tool 装饰器定义一个 calculate 函数。安全设计上,函数只允许数字和基本运算符字符,用 eval 时传入空的 __builtins__ 字典来限制执行范围。
关于 eval 安全的进一步说明
教程中用 eval 执行表达式并清空 __builtins__,这是一种最低限度的沙箱手段。清空 __builtins__ 可以阻断 __import__、open、exec 等内建函数的访问,配合前置的字符白名单校验(仅允许数字和 +-*/.()),能挡住绝大多数注入尝试。但它并非绝对安全:Python 的 eval 仍可能通过对象属性链(如 ().__class__.__bases__)绕过限制,因此这只是演示级防护。生产环境中应改用 ast.literal_eval(仅支持字面量)、专用表达式解析库(如 simpleeval、numexpr),或干脆把计算逻辑放到隔离的容器/沙箱服务中执行。这个例子真正想传达的理念是:工具函数的输入来自模型生成,必须视为不可信输入对待,这与 Web 开发中处理用户提交数据的思路一致。
第四步:创建天气工具
这个工具调用 Open-Meteo 的免费 API,无需申请密钥。流程分两步:先通过地理编码 API 把城市名解析为经纬度,再用预报 API 获取当前天气数据。
返回信息包含温度、体感温度、湿度、风速、降水量和观测时间。代码内置了 WMO 天气代码到可读描述的映射表,覆盖从晴天到雷暴冰雹的 28 种天气状况。异常处理区分了网络请求失败和数据解析异常两种情况,都会返回明确的错误说明而非抛出堆栈。
需要留意的是,笔记本环境必须具备出站互联网访问权限。
第五步:组装 Agent
用 BedrockModel 指定模型和区域,创建 Agent 实例时传入模型、工具列表和系统提示词。系统提示词要求助手:有用时使用工具、简洁清晰地解释答案、天气结果要标明来自 Open-Meteo 并附上观测时间、遇到 API 错误要如实告知而非编造数据。
第六到九步:测试 Agent 能力
教程设计了递进的测试用例:
- 纯计算问题「25 * 8」——验证计算器工具调用
- 纯天气问题「班加罗尔天气」——验证天气工具调用
- 组合问题「班加罗尔温度是多少,换算成华氏度并展示计算过程」——验证多工具协作的 agentic 工作流
- 自定义问题——让读者自行探索
第 3 个用例最能体现 Agent 的价值:模型需要先调用天气工具拿到摄氏温度,再调用计算器工具完成单位换算。
权限配置与故障排查
Strands Agents 与 Bedrock 的集成最常见的失败原因集中在权限和区域配置上:
AccessDeniedException:需要在 Bedrock 控制台启用目标模型,同时确认 SageMaker 角色具备 bedrock:InvokeModel 权限。
ValidationException 或模型不可用:检查模型 ID 与区域是否匹配。某些模型并非在所有区域都可用,可在配置单元格修改或通过环境变量覆盖。
无 AWS 凭证:为 SageMaker 环境附加 IAM 执行角色,或配置标准凭证链。切忌把访问密钥直接写进笔记本文本。
教程提供了一个可附加到 AmazonSageMaker-ExecutionRole 的内联策略示例,授予 bedrock:InvokeModel 和 bedrock:InvokeModelWithResponseStream 两个操作权限,资源限定为对应区域的 nova-lite 模型 ARN。
一个实用经验:笔记本默认使用 us-east-1 区域,如果你的 Bedrock 模型在其他区域启用,需要显式设置 AWS_REGION 或 AWS_DEFAULT_REGION。
Agent 自主选择工具的工作机制
当 Agent 收到「班加罗尔温度是多少,换算成华氏度并展示计算过程」这类请求时,底层发生的是多轮 ReAct 式循环:模型先输出第一轮推理,判定需要天气数据,于是发出 weather_tool(city="Bangalore") 的调用请求;SDK 执行该函数并把返回的 JSON 结果作为新一轮消息追加进上下文;模型读取到摄氏温度后,再发出 calculate(expression="28*9/5+32");拿到数值后最终生成自然语言回复。整个过程没有硬编码的 if-else 分支,工具选择完全由模型依据工具的名称、docstring 描述和参数 schema 决定。因此工具函数的 docstring 写得是否清晰,直接决定模型能否在该用的时候用对——这是很多人调试 Agent 时容易忽略的一环。如果发现模型该调用工具却直接凭记忆作答,通常需要在系统提示词中强化「必须使用工具」的约束,或改进工具描述。
收尾工作与核心收获
完成实验后务必停止并删除笔记本实例,删除前记得备份 ipynb 文件。教程作者提供了完整的 notebook 文件供下载,可通过 JupyterLab 的上传按钮导入。
回顾整个流程,这套方案帮助开发者掌握了几个关键能力:用 Strands Agents 框架和 Bedrock 搭建 Agent、编写 Python 工具函数并集成到 Agent、对接真实 API 获取动态数据、理解 Agent 基于问题类型自主选择工具的工作机制、以及 IAM 权限在访问 Bedrock 服务时的决定性作用。
对于想快速体验 AI Agent 开发流程的工程师来说,这是一个成本可控、步骤清晰的入门路径。
相关推荐
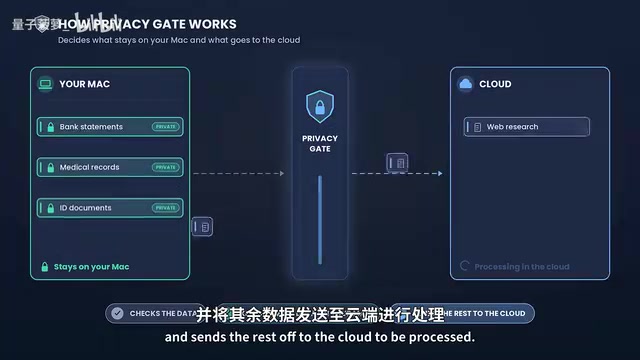
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。