三台Mac组集群硬跑573GB开源大模型MiMo V2.6 Pro实测

博主用三台Mac组集群,实测MIT协议开源大模型MiMo V2.6 Pro的量化敏感性与编码能力。
一位海外博主将M4 Max、M5 Max和Mac Studio三台消费级Mac串成集群,运行需要约573GB内存的开源大模型MiMo V2.6 Pro。该模型采用MIT许可证、商用零障碍,SWE基准达71.9,优于GLM的66.9。实测发现模型对量化极度敏感,3-bit版本在多项编码任务中直接崩溃,仅8-bit量化可用,这是单机跑不动的根本原因。通过三机集群,博主完成了3D太阳系、核爆场景、纯WebGL人脸、GTA5复刻等压测任务,整体效果令人印象深刻,但温度设为0时存在思考循环问题,需手动干预。最终结论是:Pro版在复杂视觉生成上有优势,Flash版在速度与效果间性价比更高。
用消费级Mac集群跑MIT协议大模型
一位海外博主做了件相当硬核的事:把三台Mac串成集群,硬跑参数规模庞大、需要约573GB内存的开源大模型MiMo V2.6 Pro。这款模型采用MIT许可证,对商用极其友好——这是它区别于当前很多开源模型的关键优势。
博主特别点出了许可证问题:目前公认开源权重里表现最好的GLM用的是自定义许可,一旦你的收入达到某个门槛,就得向官方报备使用情况。而MiMo V2.6 Pro的MIT协议几乎没有这种束缚,拿来即用、随便商用。
从跑分看,这款模型在SWE基准上成绩亮眼,达到71.9,高于GLM的66.9。虽然DeepSeek广告 V4.1号称SWE拿到74,但博主翻了细则后发现那是多次测试里挑出来的最好成绩(open code实测65、PI实测66),有明显的cherry-pick嫌疑。当然他也坦言,无法确认MiMo是否也用了同样的取巧手法。
MIT许可证(Massachusetts Institute of Technology License)是软件开源领域最宽松的许可证之一,核心条款只要求保留原版权声明,对使用方式几乎没有任何限制——可以自由使用、复制、修改、合并、发布、分发、再授权,甚至用于商业产品销售,无需向原作者报告或分成。这与GPL(要求衍生品同样开源)、Apache 2.0(有专利授权条款)等许可证相比,商用摩擦极小。在大模型领域,许可证问题尤为敏感:许多标榜"开源"的模型实际使用社区许可(Community License),一旦月活用户或年收入超过某个门槛,就需要向模型提供方申请商业授权。MiMo V2.6 Pro使用MIT协议,意味着无论是个人开发者还是大型企业,都可以直接将其集成进商业产品,无需担心合规风险。
硬件门槛:为什么必须用集群
这款模型出厂就是预量化版本,运行它需要约573GB内存。博主尝试把它量化压缩到能在512GB系统上跑,结果发现MiMo V2.6 Pro对量化相当敏感——压得越狠,编码错误和各种毛病就越多,体验直线下降。
他的忠告很明确:哪怕是Flash版本,也只能用8-bit量化,别碰更低的档位,否则结果惨不忍睹。
为此他动用了M4 Max、M5 Max加上一台Mac Studio组成三机集群。起初只用Mac Studio和M4 Max两台跑,但一旦任务超过十万token,就会因内存不足崩溃。加入第三台机器后才解决了这个问题。连接完成后跑一个简单的"hello"测试,速度约15 tokens/秒。
量化(Quantization)是将模型权重从高精度浮点数(如FP16或BF16,每个参数占16位)压缩为低精度整数(如INT8占8位、INT4占4位)的技术手段,目的是在牺牲一定精度的前提下大幅降低显存/内存占用和推理速度。以8-bit量化为例,相比FP16可将内存需求减少约一半。然而不同模型对量化的容忍度差异显著:部分模型即使压到4-bit甚至3-bit,输出质量下降也较为有限;而MiMo V2.6 Pro这类模型则对精度损失高度敏感,低精度量化会导致推理时逻辑链断裂、代码生成出错率急剧上升,这一特性与模型内部的注意力机制和权重分布有关。SWE(Software Engineering)基准是衡量模型解决真实GitHub代码仓库Issue能力的测试集,被业界视为评估模型实际工程编码能力的重要标准之一,比单纯的代码补全测试更贴近真实开发场景。
实测表现:从太阳系到核爆
博主用一系列编码任务来压测模型能力。基础的3D太阳系在关闭思考模式下用1800 token就生成了,效果中规中矩。而当他拿3-bit量化版做同样任务时,得到的是一片黑屏——这直接印证了前面关于量化敏感的结论。
核爆炸场景是个亮点。满配版本生成的热核爆炸效果不错,而3-bit量化版一运行就直接报runtime error,哪怕开启思考模式依然崩溃。
一个值得注意的现象是:博主把温度设为0,这在某些情况下会让模型陷入"思考循环"卡死。他的变通办法是打开token检查器,手动找到模型本来考虑结束思考的灰色节点,点选end think标签强制结束思考,再让它继续生成代码。
在一个爆破建筑的任务里,模型经过两轮对话(上下文增长到6.5万token),最终做出了用乐高积木式建筑、带真实物理效果的可爆破场景,博主对此评价相当高,速度降到约12 tokens/秒。
大型推理模型(Reasoning Model)在生成最终答案之前,通常会先产生一段内部"思维链"(Chain of Thought),即在 <think> 标签内反复推敲、验证假设。当采样温度设为0时,模型每一步都会选择概率最高的token,理论上输出最确定,但在思维链阶段可能因缺乏随机性而陷入重复循环——模型不断生成相同的推理步骤却无法收敛到结束标志。这种"思考循环"(Thinking Loop)在DeepSeek-R1系列和其他推理模型上也有记录。常见的工程缓解手段包括:设置最大思考token上限、适当提高思考阶段的温度(而保持输出阶段温度低),或像博主所做的那样借助前端工具手动注入结束标记强制截断。
WebGL人脸与GTA复刻
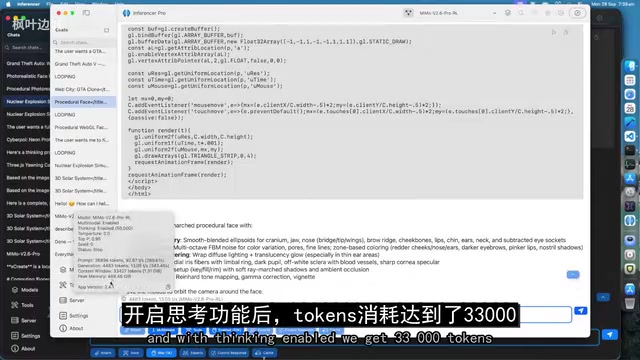
不借助Three.js、纯裸WebGL画人脸是个更难的测试。关闭思考时模型只画出一个带尖峰的蛋形,还长了两个鼻子;开启思考后用3.3万token生成了一张相当漂亮的人脸——虽然顶着一条醒目的"一字眉"。
重头戏是复刻《侠盗猎车手5》。模型毫不避讳地打出"Rockstar North presents Grand Theft Auto 5",没有像某些模型那样回避真实公司名。用十万token生成的版本里,玩家能开车、能捡到五千块钱,虽然光照偏暗、操作有些生硬,但没有runtime错误,整体可玩。
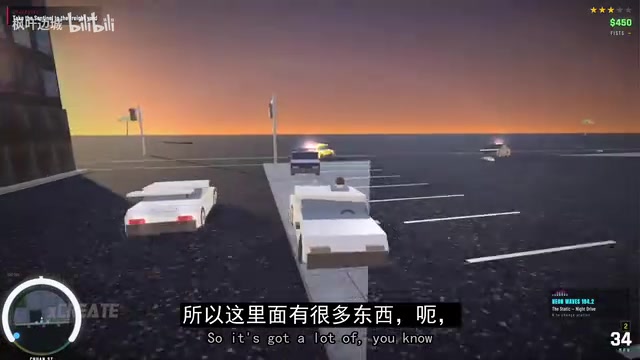
博主还对比了Agent模式与单文件模式。Agent模式把代码拆分成JS、CSS等独立文件,消耗更多token但结构更好。在与Qwen 4 EXP的横向对比中,他认为MiMo 2.6 Flash版的GTA生成角色动画更美、城市更好看,驾驶手感也更佳(只是左右方向反了,但这个毛病连Opus这类顶级模型也会犯)。
多模态与知识问答的短板
集群现在也支持多模态。博主给模型喂《帝国时代2》的截图,它立刻认出了游戏,还自己去Unsplash找了合适的背景图搭建菜单系统,开局无runtime错误。不过游戏只是"有皮没骨"——能挖矿但造不出村民,需要后续追加提示词完善。
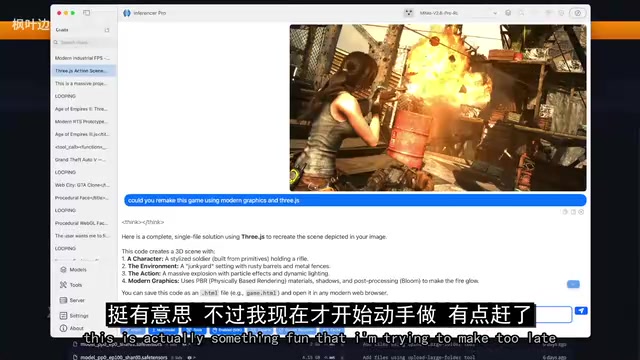
《古墓丽影》的复刻就没那么成功,模型似乎并不认识这个IP,生成的角色陷在地面里走不动,只有枪械反光和射击桶效果还算像样。
知识问答方面出现了个有意思的反转:在一个关于Craig David歌曲的问题上,满血Pro版反而没答全,倒是3-bit量化版给出了更准确的答案。博主由此感慨,MiMo的Flash版本本身已经做得相当出色,Pro版的优势主要体现在核爆、3D人脸这类复杂视觉生成上,代价是必须上集群、运行速度明显更慢。
写在最后
综合来看,这次实测传递的核心信息很清晰:MiMo V2.6 Pro靠MIT协议和领先的基准成绩值得关注,但它对量化极度敏感,普通单机根本带不动,必须靠多台Mac组集群才能发挥实力。对于能凑齐足够内存的开发者来说,把一串消费级电脑拧成一股绳去跑顶级开源模型,本身就是件令人兴奋的事。
相关推荐

离子推进器:赢得太空竞赛的慢速火箭
离子推进器以极低推力、极高效率成为太空深空探测与货运物流的关键技术。本文解析离子引擎的工作原理、氙气推进剂的选择、太阳能与核电推进的权衡,以及它为何可能成为建造星际文明的"慢速火箭"。

人类造过最快的东西:帕克太阳探测器的43万英里时速
人类建造过最快的物体不是旅行者号或火箭,而是NASA帕克太阳探测器,时速约43万英里。本文解析它如何借助金星引力辅助与太阳引力井加速,以及为何以光速衡量人类仍刚刚起步。

美光CEO警告:内存供应将在未来两年持续趋紧
美光CEO表示存储芯片供应将在未来两年比当前更为紧张,AI需求激增与产能扩张滞后是主因。本文分析内存供应趋紧的原因及其对市场和消费者的影响。