SAPD:无需环境交互,从离线轨迹高效训练LLM智能体

SAPD利用离线轨迹与相对步骤优势信号,无需环境交互即可稳定训练LLM智能体。
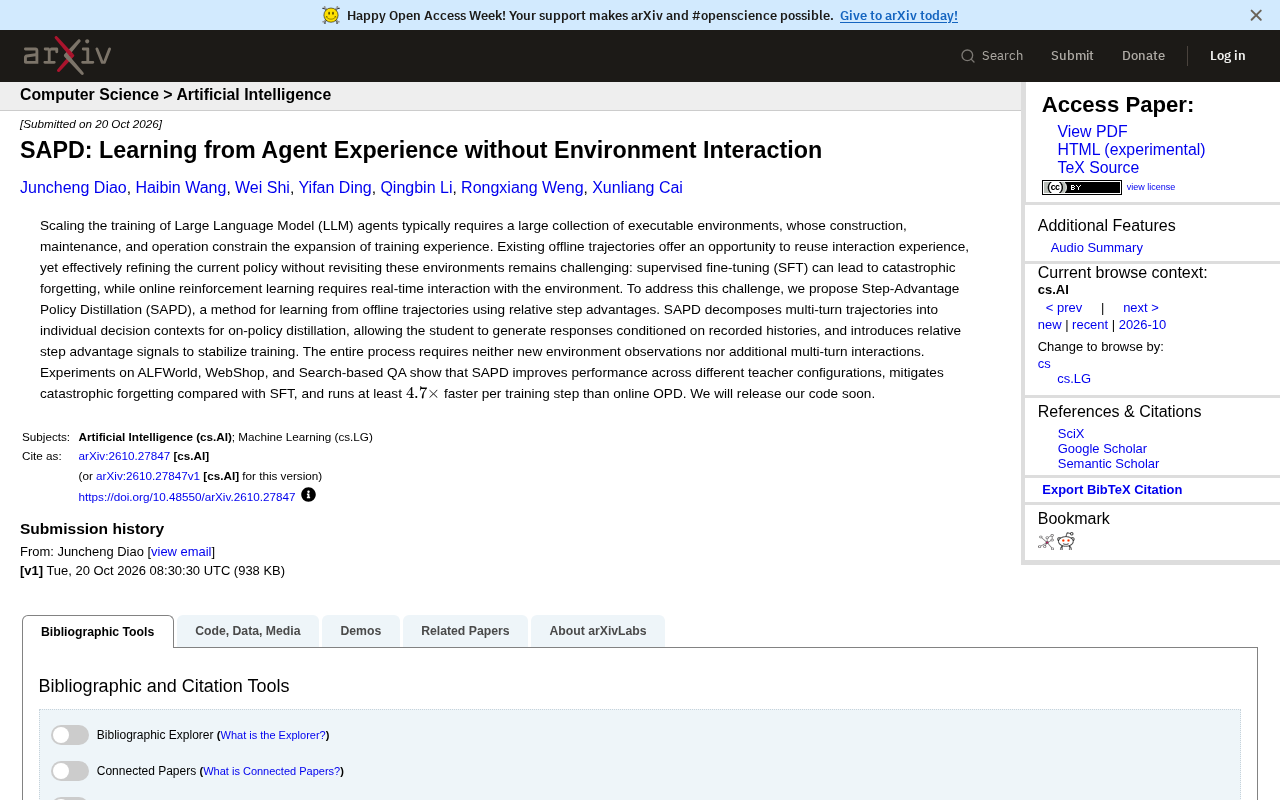
SAPD(Step-Advantage Policy Distillation)针对LLM智能体训练中环境构建成本高、离线经验难以复用的问题,提出将多轮轨迹分解为独立决策上下文,在同策略蒸馏框架下引入相对步骤优势信号,从而在不进行新环境观测或多轮交互的情况下稳定改进策略。实验在ALFWorld、WebShop和搜索问答任务上验证了该方法在不同教师配置下均能提升性能,相比SFT有效缓解灾难性遗忘,且每个训练步骤的运行速度至少比在线同策略蒸馏快4.7倍。该工作为受限于计算资源和环境约束的智能体训练提供了一条可扩展的离线范式。
引言:LLM智能体训练的瓶颈
训练大型语言模型(LLM)智能体通常需要大量可执行环境,这些环境的构建、维护和运行成本高昂,严重制约了训练经验的扩展。现有离线轨迹虽能复用交互经验,但如何在不重新访问环境的情况下有效优化当前策略仍是一大挑战:监督微调(SFT)可能导致灾难性遗忘,而在线强化学习又需要与环境的实时交互。
针对这一问题,研究者提出了一种新方法——Step-Advantage Policy Distillation(SAPD),相关论文标题为《SAPD: Learning from Agent Experience without Environment Interaction》。该方法利用离线轨迹和相对步骤优势信号,在不进行新环境观测或多轮交互的情况下,实现策略的稳定改进。
灾难性遗忘(catastrophic forgetting)指模型在学习新任务或新数据分布时,迅速丢失此前已掌握知识的现象。在LLM智能体训练中,若直接对离线轨迹做监督微调,模型会过度拟合这些轨迹中的动作分布,从而偏离原有的通用能力与策略先验,导致在未见环境或任务上的表现下降。这一问题是离线训练范式的主要风险之一,也是SAPD强调用蒸馏而非纯SFT来稳定优化的直接动因。
在线强化学习(on-policy RL)要求智能体在训练过程中不断与环境交互、采集新轨迹并更新策略。其优势是数据分布与当前策略一致,但代价是环境必须可执行、可扩展,且交互成本随训练规模线性增长。对于需要大量并行环境的LLM智能体训练而言,这一成本往往难以承受,因此研究者转向利用已有离线轨迹来逼近同策略优化的效果。
SAPD核心思想:分解轨迹与优势信号
SAPD的核心创新在于将多轮轨迹分解为独立的决策上下文,用于同策略蒸馏(on-policy distillation)。具体而言,学生模型基于记录的历史生成响应,并引入相对步骤优势信号来稳定训练。整个训练过程无需新的环境观测,也无需额外的多轮交互。
相对步骤优势的作用
相对步骤优势信号是SAPD的关键组件。它通过比较不同步骤的决策质量,为学生模型提供更细粒度的指导,从而避免传统蒸馏中可能出现的偏差累积。这种设计使得SAPD能够从离线数据中高效提取知识,同时保持训练的稳定性。
同策略蒸馏(on-policy distillation)指学生模型在自己生成的分布上采样,再由教师模型对这些样本给出监督信号。与传统的离线蒸馏相比,它缩小了训练与推理之间的分布差距,但前提是学生能够生成合理的决策上下文。SAPD将多轮轨迹拆成独立的单步决策上下文,使学生可以在记录的历史条件下生成响应,从而在完全不接触环境的情况下模拟同策略蒸馏的流程。
步骤级优势信号借鉴了强化学习中优势函数(advantage)的思想:优势衡量某个动作相对于基线策略的优劣,而步骤级优势则把这种比较细化到轨迹中的每一个决策点。相比只用最终回报或整条轨迹的标量奖励,步骤级信号能区分同一轨迹中哪些步骤更关键、哪些步骤贡献有限,从而缓解信用分配难题,减少蒸馏过程中的偏差累积。
实验验证:多环境性能提升
研究者在ALFWorld、WebShop和基于搜索的问答任务上进行了实验。结果表明,SAPD在不同教师配置下均能提升性能,相比SFT有效缓解了灾难性遗忘,并且每个训练步骤的运行速度至少比在线同策略蒸馏(OPD)快4.7倍。
性能与效率的双重优势
SAPD在多个基准测试中展现出稳定的性能提升,同时训练效率显著优于在线方法。这使其成为在有限计算资源和环境约束下训练LLM智能体的有前景的方案。
总结与展望
SAPD提供了一种无需环境交互的离线训练范式,为LLM智能体的大规模训练开辟了新路径。研究者表示将很快发布代码,预计将进一步推动该领域的应用与发展。
对于AI研究者和开发者而言,SAPD的意义在于它降低了智能体训练对环境依赖的门槛,使得利用现有离线数据成为可能。未来,该方法或可扩展到更多复杂任务和更大规模的模型训练中。
相关推荐

大厂AI工程化面试:前端监控到Agent全链路可观测性
从PerformanceObserver采集性能指标、onerror与unhandledrejection捕获异常,到RAG链路重排优化、上下文压缩控制token成本,再到对标LangSmith与Sentry的全站AI全链路可观测性体系设计,拆解大厂AI工程化面试的三层递进考点。

WorkBuddy保姆级教程:手把手搭建专属AI Agent工作助理
WorkBuddy保姆级教程:从豆包等聊天模型的局限讲起,手把手教你搭建专属AI Agent工作助理,实现本地文件批量处理与自动化操作,非程序员也能轻松上手。

Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库
本文整理B站教程,详解Windows下用LangChain-Chatchat与DeepSeek搭建本地知识库的全流程,包括Anaconda环境配置、Ollama模型管理、镜像源加速及常见报错解决,助你快速实现RAG问答。