SciMARS:多智能体递归自改进框架,闭环科研发现新突破

SciMARS 用共享证据图与分离式组件编辑器,让多智能体协作结构可递归自适应。
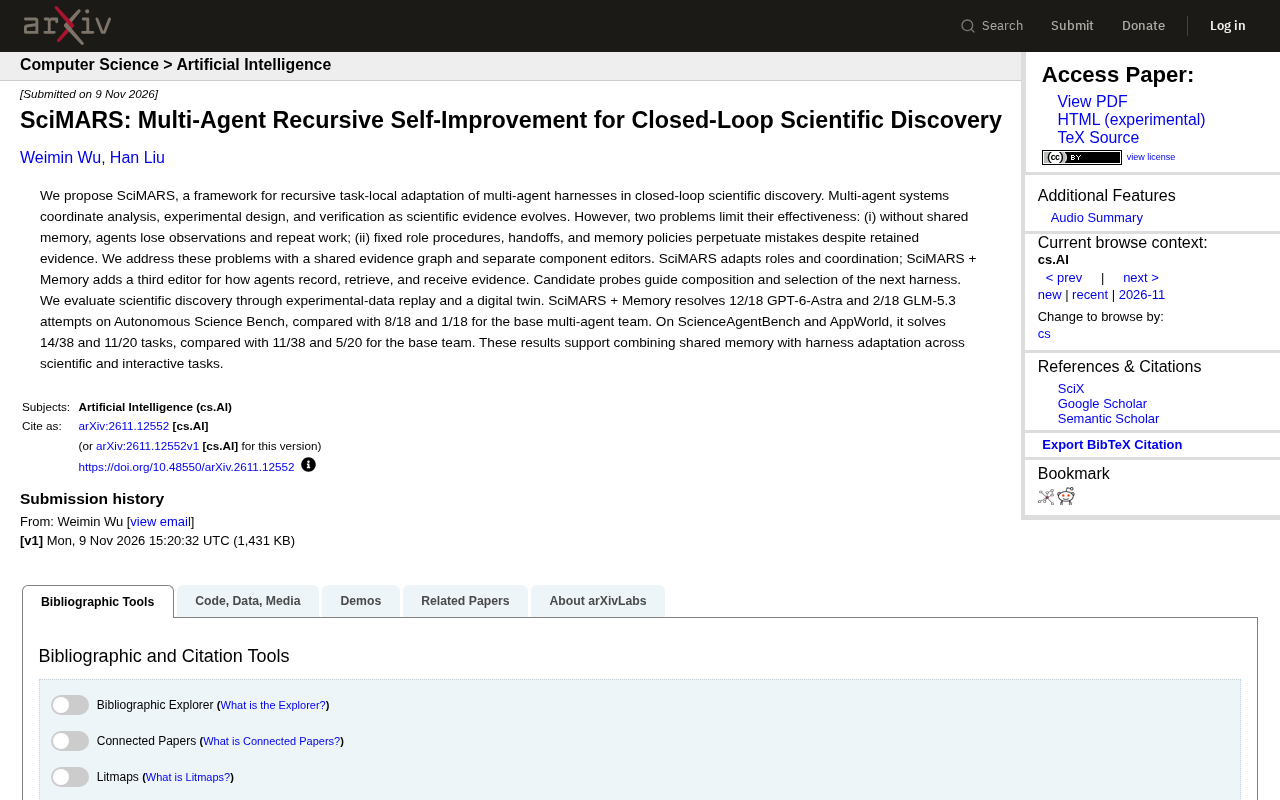
SciMARS 针对多智能体科学发现系统缺乏共享记忆、角色与流程固定导致错误延续的两大瓶颈,提出以共享证据图统一观测记录、以分离式组件编辑器分别调整角色协调与记忆策略的框架,并用候选探针引导 harness 的组成与选择,实现递归式任务局部自适应。实验在 Autonomous Science Bench、ScienceAgentBench 和 AppWorld 上展开,SciMARS + Memory 在多项指标上明显优于基础多智能体团队,例如在 Autonomous Science Bench 上解决 12/18 的 GPT-6-Astra 尝试(基础团队为 8/18)。文章认为,闭环科研需要可进化的协作结构,但当前评估仍局限于特定基准与有限模型。
多智能体系统在科学发现中扮演着越来越重要的角色,它们能协同完成分析、实验设计和验证等任务。然而,现有系统普遍面临两个瓶颈:智能体之间缺乏共享记忆,导致重复劳动;固定的角色分工、交接流程和记忆策略,即便证据已经更新,错误仍会延续。近期提出的 SciMARS 框架,试图用“共享证据图 + 组件编辑器”的组合拳解决这些问题,并实现了递归式的任务局部自适应。
核心设计:共享证据图与分离式组件编辑器
SciMARS 的核心思路是将多智能体协作中的“证据”与“流程”解耦。它引入了一个共享证据图(shared evidence graph),让所有智能体都能访问统一的观测记录,避免信息丢失和重复工作。在此基础上,框架使用分离的组件编辑器来分别调整角色、协调机制和记忆策略。
具体来说,SciMARS 本体负责调整角色和协调方式;而 SciMARS + Memory 版本额外增加第三个编辑器,专门优化智能体如何记录、检索和接收证据。这种分离设计使得系统可以在不破坏已有证据的前提下,针对性地修正协作流程中的错误。
为了引导下一轮 harness 的组成和选择,框架还使用了候选探针(candidate probes)进行引导。这套机制让多智能体团队能够根据任务进展动态调整自身结构,实现递归式的自我改进。
共享证据图(Shared Evidence Graph) 是一种面向多智能体协作的结构化知识库,通常以图(节点表示观测、假设、实验结果等证据实体,边表示支撑、矛盾或时序关系)的形式组织。与各智能体私有的上下文记忆不同,它把所有智能体产生的观测集中存储并统一索引,任何成员都可读写。这样做有两个直接好处:一是避免同一证据被不同智能体重复采集或重复推理,降低算力与时间开销;二是保证推理所依据的事实基础一致,减少因信息不对称导致的冲突结论。在需要长期迭代的科研任务中,证据图还能作为可追溯的“实验台账”,使后续的流程修正有据可依。
Harness(执行框架/装配体) 在此类系统中指由多个智能体、它们各自的角色提示、协调协议与记忆接口共同组成的一个可配置执行单元。可以把它理解为“一次协作实验的完整装配方案”:谁担任什么角色、任务如何在成员间交接、证据以何种方式被检索和传入,都由 harness 的配置决定。SciMARS 的关键创新在于把 harness 当作可被编辑的对象,而非写死的程序,因此每一轮任务结束后,系统能根据表现重构下一轮的 harness 组成。候选探针则是在若干候选配置中用于试探性评估的轻量方案,帮助系统判断哪种 harness 组合更可能成功,从而把有限的尝试预算投向更有希望的配置。
实验验证:多项基准测试表现提升
研究团队通过实验数据回放和数字孪生两种方式评估科学发现能力。在 Autonomous Science Bench 上,SciMARS + Memory 解决了 18 次 GPT-6-Astra 尝试中的 12 次,以及 18 次 GLM-5.3 尝试中的 2 次;而基础多智能体团队仅解决了 8/18 和 1/18。
在 ScienceAgentBench 和 AppWorld 上,SciMARS + Memory 分别解决了 38 个任务中的 14 个和 20 个任务中的 11 个,基础团队的成绩则是 11/38 和 5/20。这些结果覆盖了科学发现和交互式任务两类场景,说明共享记忆与 harness 自适应的组合具有跨领域的泛化能力。
数字孪生(Digital Twin) 在本文的评估语境中,指为真实科学实验或工程系统构建的高保真虚拟副本,智能体在副本上执行实验设计、操作与验证,从而在不消耗真实资源、不承担安全风险的前提下检验科学发现能力。与之并列的数据回放(data replay) 则是把历史实验记录按时间顺序重新输入系统,考察智能体能否在已有观测流中复现或推进结论。两种方式互补:回放侧重对既有证据的利用与推理一致性,数字孪生侧重交互式决策与闭环验证,因此同时采用能更全面地衡量框架在科学发现场景中的表现。
启示:闭环科研需要“可进化的协作结构”
SciMARS 的价值不仅在于具体指标提升,更在于它揭示了一个方向:闭环科学发现中的多智能体系统,不能只依赖固定的角色剧本。随着实验证据不断累积,系统需要能够递归地调整自身的协作结构——包括谁负责什么、信息如何流转、记忆如何被检索。
共享证据图解决了“看到什么”的问题,分离式编辑器解决了“怎么改”的问题,候选探针则提供了“往哪改”的引导。三者结合,让多智能体团队在保持证据一致性的同时,具备了从错误中学习并重构流程的能力。对于需要长期迭代的科研任务,这种可进化的协作结构可能比单纯扩大模型规模更具实际意义。
当然,当前评估仍集中在特定基准和有限模型上,真实科研场景中的噪声、不确定性和跨学科协作复杂度尚未充分检验。但 SciMARS 提供的框架思路,为多智能体系统在科学发现领域的落地提供了一个值得关注的范式。
背景补充
递归式任务局部自适应 是理解 SciMARS 设计哲学的关键。所谓“局部”,指系统并不整体推翻协作结构,而是针对出错的具体环节(某个角色、某条协调规则或某种记忆检索方式)做定点修改;“递归”则指这种修改会在多轮任务中反复发生——每轮结束后依据证据与结果评估,生成新的 harness 配置,再投入下一轮,形成自我改进的循环。与一次性手工设计智能体流程相比,这种方式让系统能随证据累积持续纠错,但也对评估信号的可靠性提出更高要求:若反馈本身有噪声,递归修正可能放大而非消除错误,这也是该框架走向真实科研场景需要面对的挑战。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。