Semantica为什么火:AI结论也要交代依据
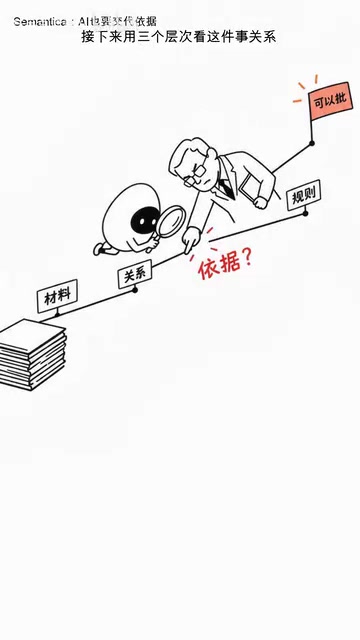
Semantica通过本体、知识图谱与溯源标准,让AI决策结论可追溯、可复盘、可治理。
当AI系统能给出答案却说不清依据时,可解释性成为企业级应用的核心障碍。Semantica试图通过三个层次解决这一问题:关系层用本体和知识图谱把文件与数据库中的实体、关系结构化存储,向量检索负责"从哪找",图谱负责"为什么有关";证据层采用W3C PROV-O溯源标准和时间建模,让每条事实带上来源、时间和处理过程,配合SHA-256指纹防篡改;治理层则以SHACL做约束校验,强调机器起草本体草稿、人做业务含义裁决,实体冲突须人工确认而非静默覆盖。这一路线有明确边界——只有涉及跨系统实体、多条关系链、历史状态与合规责任时,建设本体图谱才有明显回报;简单文档问答场景,向量检索加引用已经够用。
银行内部一次智能体演示上,AI读完200页信贷卷宗,给出结论:这笔贷款可以批。合规总监没有先关心它答得快不快,只问了一句——依据是什么?
这个问题击中了当下大多数AI系统的软肋:能给出答案,却说不清答案用过哪份材料、走过哪条关系、按过哪条规则。Semantica之所以受到关注,正是因为它试图把AI的结论重新接回事实、关系、来源与时间,做成一条可复盘的证据链。本文不把"证据链能力"当作Semantica走红的已证实因果,只拆解它究竟怎样把这件事变成系统能力。
它不是聊天机器人,也不只是RAG
Semantica不是聊天机器人,也不只是把文档切成小块的RAG(检索增强生成)工具。它要做的事更重:把文件、数据库和接口里的句子,整理成机器能查询的事实与关系,再记录这些事实从哪里来、什么时候有效、怎样参与了决策。
以贷款为例,系统不只保存"卷宗里出现了张三和一套公寓",还要知道张三是申请人、公寓是抵押物、某笔负债属于张三的配偶。只有当这些关系被结构化保存下来,智能体回答"能不能批"时,系统才有机会反向查出它到底用了什么。
理解这套机制,可以从三个层次入手:关系、证据、治理。不妨先做个小测试——挑一道必须解释依据的问题,写出它依赖的事实、关系和规则,后面每一层都会回到这个测试。
关系层:本体不能只停在文档里
本体(Ontology)可以理解成业务系统的"语法表":它规定有哪些对象、对象之间允许有什么关系、哪些字段必须满足约束。设计这套对象、关系和约束的人,就是本体工程师。
关键在于,本体不能只是一张交付图。如果它停在文档里,系统只知道"客户"和"合同"两个词,却不一定知道它们在业务上怎样关联。Semantica把本体继续接到数据接入、实体识别、查询、推理和校验上,让它变成智能体每次工作都要经过的业务规则层。
在检索机制上,向量和图谱各做一半工作。向量检索把文字变成数字,先找出可能相关的材料;知识图谱保存节点和连线,再沿着"申请人—负债—支行"这样的路径把多条关系串起来。一句话概括:向量负责"从哪找",图谱负责"为什么有关"。
知识图谱(Knowledge Graph)是实现这一层的核心数据结构,由节点(实体)和有向边(关系)组成,可以高效回答"两个实体之间通过哪条路径相连"这类问题。与关系型数据库的表格结构相比,图谱在处理多跳关联(如"申请人的配偶的负债所在的银行")时无需复杂JOIN操作,只需沿边遍历即可。主流的图谱存储方案包括Neo4j、Amazon Neptune等,查询语言通常为SPARQL(标准语义网查询语言)或Cypher。本体(Ontology)则是图谱的"模式层",用OWL或RDFS等标准语言定义类型、属性和约束,相当于在图谱之上加了一套业务规则的类型系统,使机器能够自动推断未被显式记录的关系。
证据层:让每条事实带上来历和时间
Semantica的溯源模块采用W3C PROV-O标准,用来记录数据来源和处理过程。一条记录可以写下来源文件、处理动作、时间、原文摘录和置信度,还能用SHA-256这样的数字指纹,检查记录后来有没有被篡改。
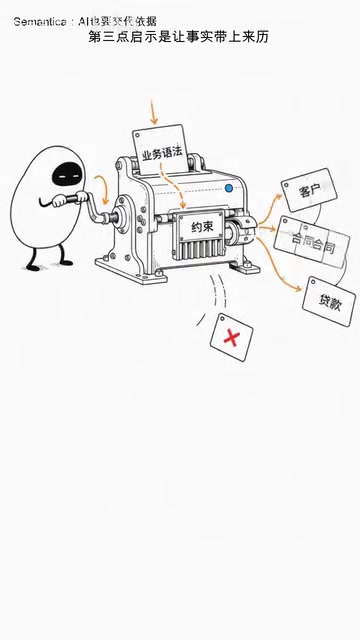
这比"只返回一段检索文本"多走了一步:它要回答一条事实是怎样进入系统、又怎样参与了后面的关系和决策。配套的Decision Recorder(决策记录组件)还能记录决策上下文、采用的策略、因果关系和审批过程。
时间维度同样被显式建模。一家供应商今天合格,不代表去年也合格;审批规则今天更新,也不代表半年前就该按新版执行。系统区分"事实在现实中何时成立"和"系统何时知道并保存它"两个时间,再配合Allen区间代数,可以表达早于、重叠、包含等时间关系。这样在复盘审批时,就不会拿今天的状态去倒推当年的决定。
W3C PROV-O(Provenance Ontology)是万维网联盟发布的数据溯源标准本体,核心概念只有三个:Entity(数据实体)、Activity(对数据的处理活动)和Agent(负责执行活动的人或系统)。通过这三者的关系,可以完整描述"某份PDF文件(Entity)经过OCR解析程序(Activity)提取出一条事实,由数据接入服务(Agent)写入知识库"这一完整过程。Allen区间代数则是由逻辑学家James F. Allen于1983年提出的时态推理框架,定义了13种基本时间关系(如"早于""同时""包含""重叠"),使系统能够精确表达和推断事件的时序,而不仅仅是记录单个时间戳。这两项标准的组合,使得溯源记录既能说明"从哪里来",又能准确表达"在哪段时间成立"。
治理层:机器起草,人做业务裁决
Semantica支持自动生成本体,也支持SHACL——按预设形状检查字段、类型和关系是否符合约束。机器可以先归纳出对象和关系,但它不知道销售系统里的Customer(客户)和财务系统里的Debtor(债务人)为什么用不同口径,也不知道某个特殊业务能不能接受例外。
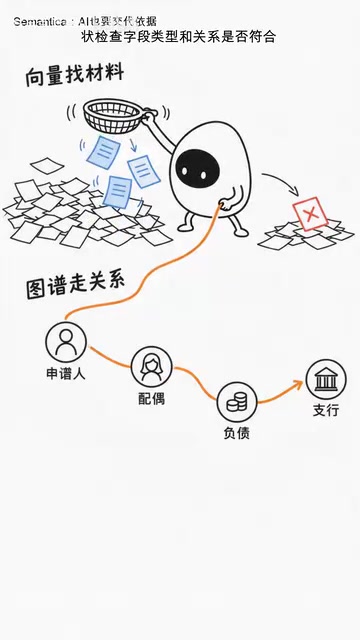
一致性治理不能靠"最后一次覆盖"来解决。同一家客户可能在CRM、财务和合同系统里有三套名称与编码,系统可以用字符串相似度、语义相似度和合并策略发现重复实体;遇到矛盾事实则应检测、标记,必要时交给业务专家确认,并保留原始来源。这也是本体工程师新的工作重心:机器负责起草和检查,人负责确定业务含义、处理冲突、批准例外。
SHACL(Shapes Constraint Language)是W3C标准,用于定义RDF数据图谱必须满足的"形状"约束,类似于JSON Schema对JSON数据的约束作用。它可以检查某个节点是否具备必填属性、属性值是否在合法范围内、两个实体之间的关系数量是否符合业务规定(如一个申请人最多只能有一个主贷款),违反约束时生成结构化的验证报告,供人工或自动化流程处理。实体消解(Entity Resolution)是治理层的另一关键技术,解决的是"同一现实对象在不同系统中有不同表示"的问题。常见方法包括:基于编辑距离的字符串相似度、基于词向量的语义相似度,以及规则引擎(如统一社会信用代码匹配优先级高于名称匹配)。未能自动消解的候选对,应进入人工审核队列,而非静默选择其中一个版本,以避免将数据错误传播到后续决策链中。
边界与落地建议
Semantica这条路线有明确边界。自动生成的本体仍然只是草稿;中文和多模态(同时处理文字、图片或音视频)场景可能需要额外适配;大规模部署也会带来存储和运维成本。
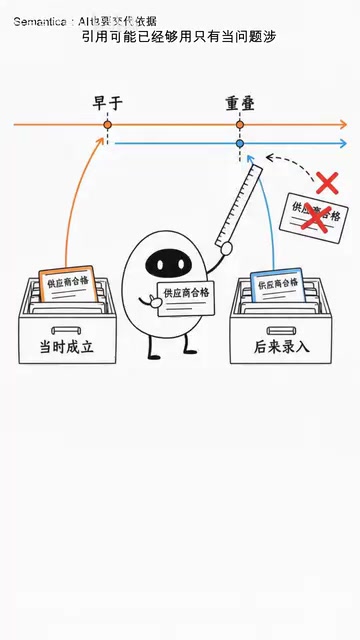
换个角度看:简单的文档问答,向量检索加可靠引用可能已经够用。只有当问题涉及跨系统实体、多条关系、历史状态、合规规则和责任追踪时,建设本体和图谱才更容易产生回报。
如果企业准备让智能体进入审批、合同、付款或供应链流程,可以先做三件事:
- 挑一道必须解释依据的问题,划清它需要哪些事实、关系和规则;
- 给关键事实补上来源和时间,先跑通一条证据链;
- 提前写清哪些实体可以自动合并、哪些冲突必须人工确认、哪些决定需要审批和留痕。
验收时随机抽一条智能体结论,它应该能还原来源文件、关键实体关系、适用规则和有效时间;无法自动消解的冲突必须进入人工审核,而不是静默覆盖。
大模型负责组织语言,Semantica这类语义底座负责把事实、关系、规则和责任链留在系统里。当AI真正参与决策之后,企业要补的,恰恰是"答案之外的东西"。
相关推荐
Opus 5.5 实战手册:Claude Code 长任务的优化与边界
Opus 5.5 在 Claude Code 中的实战手册:明确终点线、删除冗余提示词、将停止规则写入 CLAUDE.md。结合 130 条 Hacker News 评论,剖析 AI 编程长任务的优化方法与失效边界。
AI时代为何急需「默认硬性预算上限」?
AI编码智能体让部署付费服务变得简单,也放大了失控账单风险。本文解读为何按量计费服务应默认提供硬性预算上限,以及 AWS、Google Cloud 的最新跟进动作。

把 Tmux 当操作系统:一位开发者的理想终端 UI 构想
开发者 Mat Duggan 提出"把 Tmux 当操作系统"的大胆构想,主张以终端复用器为核心打造键盘优先的理想 OS 界面。本文解析这一理念的优势、现实挑战及其在技术社区引发的讨论。