上下文即基础设施:Agentic RAG的知识编译层

知识编译不是更好的检索器,而是以最小充分集供给上下文的基础设施。
文章探讨了 agentic RAG 中搜索外挂(harness)在提升准确率的同时带来的上下文膨胀问题,并提出知识编译作为供给层解决方案。搜索外挂仅用 BM25/grep 和 MiniMax M3 即可在 BrowseComp-Plus 达到 85%、多跳 FRAMES 达到 91%,准确率已非瓶颈;但缺乏纪律的循环会重复查询、塞满未使用段落,推高 token 成本和延迟。知识编译通过 LLM 为文档补充导航层级、实体图、时间线等结构化产物,其价值不在提升检索准确率(结构化产物在 FRAMES 上无增益),而在于以编译好、可治理的形态供给上下文。主张—证据导航树在证据充分时削减 91% token,平均削减 38%,盈亏平衡充分率约 2%,实测接近 43%,经济性成立。决策门将延迟从 140 秒压到 30 秒,但省 token 与省轮次存在权衡。本体、图、wiki 等产物在治理、集成、连续性等部署侧体现价值。RAGFlow 的五站流水线将 agentic 循环拆解为有纪律的站点,核心是让进入模型的上下文始终是最小充分集。文章最终将 RAG 重新定义为上下文基础设施,强调架构重心应从检索器调优前移到供给层设计。
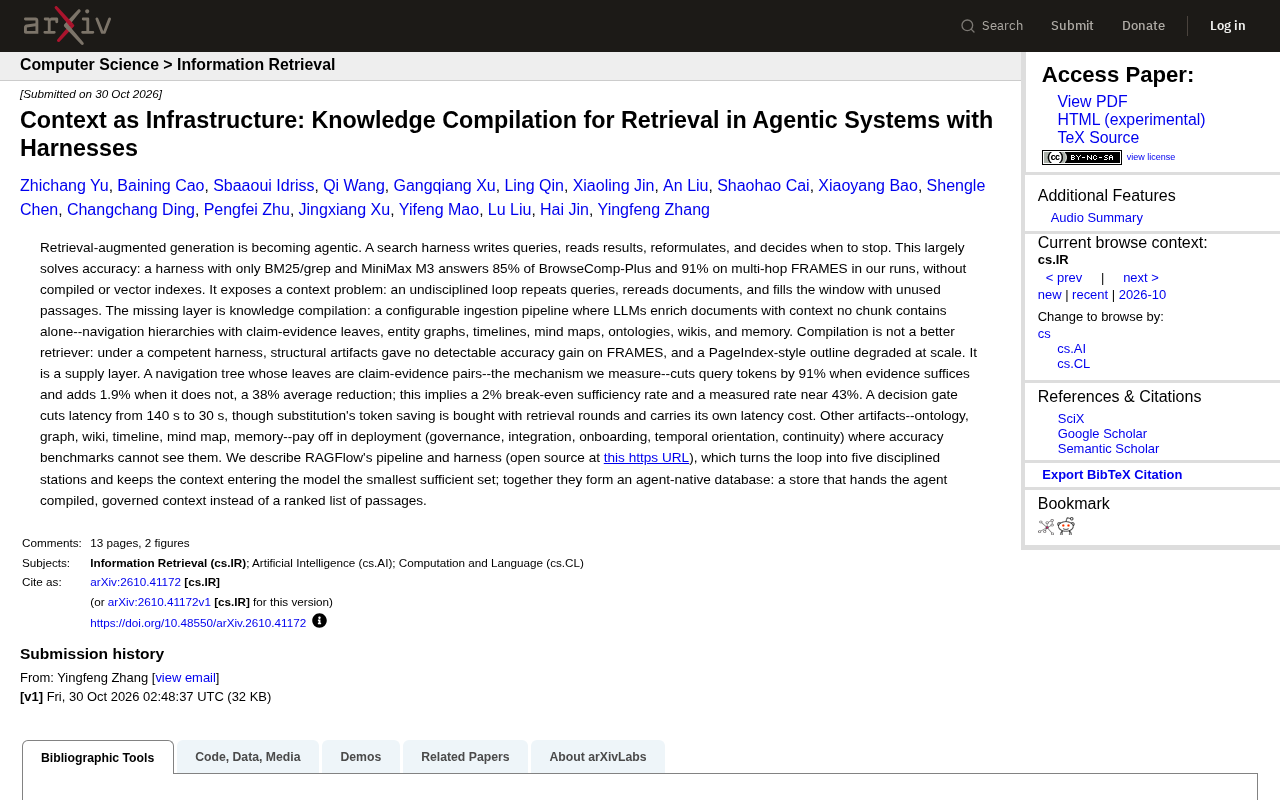
检索增强生成(RAG)正在变得"智能体化"——搜索过程不再是一次性的向量检索,而是由智能体(Agent)编写查询、读取结果、重新表述,并自行决定何时停止。这种"搜索外挂"(harness)在很大程度上解决了准确率问题:仅凭 BM25/grep 和 MiniMax M3,在没有编译索引或向量索引的情况下,某次运行在 BrowseComp-Plus 上达到 85%,在多跳 FRAMES 上达到 91%。但它同时暴露了一个更隐蔽的问题:上下文。一个缺乏纪律的循环会重复查询、反复读取文档,把窗口塞满未使用的段落。缺失的一层,是知识编译(knowledge compilation)。
搜索外挂解决了准确率,却制造了上下文问题
传统 RAG 的核心是"检索—拼接—生成",而 agentic RAG 把检索变成一段有状态的探索过程。搜索外挂会写查询、读结果、改写查询、再决定是否继续。原文作者指出,这套机制在准确率上已经足够好:一个只配备 BM25/grep 和 MiniMax M3 的外挂,在 BrowseComp-Plus 上回答对 85%,在多跳 FRAMES 上达到 91%,完全不需要编译索引或向量索引。
问题出在"上下文经济"上。没有纪律的循环会反复查询同一内容、重读文档、把大量未使用的段落填进上下文窗口。准确率上去了,但 token 成本、延迟和上下文污染随之而来。换句话说,agentic 检索把"找得准"变成了一个相对容易的问题,却把"喂得省、喂得对"留成了空白。
BM25 是一种经典的稀疏检索算法,基于词频(TF)、逆文档频率(IDF)和文档长度归一化对查询与文档的相关性打分,无需训练即可工作,常用于关键词匹配场景。grep 则是文本搜索工具,按正则或字面模式逐行匹配,适合在无索引的原始文本中快速定位。两者共同点是无需预构建向量索引或编译索引,直接对原始语料操作,因此常被用作智能体搜索外挂的轻量级基线。在 agentic RAG 中,智能体可以反复调用这类工具,根据返回结果改写查询,而非依赖一次性向量相似度检索。原文中“仅凭 BM25/grep 和 MiniMax M3”即指这种极简配置,说明准确率提升主要来自智能体的查询规划与迭代,而非检索器本身的复杂度。
知识编译:不是更好的检索器,而是供给层
作者提出的解法是知识编译:一条可配置的摄取流水线,由 LLM 为文档补充任何单个 chunk 都无法独立承载的上下文——带"主张—证据"叶节点的导航层级、实体图、时间线、思维导图、本体、wiki 和记忆。
这里有一个重要的澄清:编译产物不是更好的检索器。原文明确写道,在能力合格的外挂之下,结构化产物在 FRAMES 上没有可检测的准确率增益;PageIndex 风格的大纲在规模变大时甚至出现退化。编译层的价值不在于"搜得更准",而在于供给:把上下文以编译好的、可治理的形态交给模型,而不是交一堆排序后的段落。
这一区分很关键。它意味着评估知识编译的指标不应该只是准确率,而应该包括 token 消耗、延迟、可治理性和集成成本。原文给出的导航树机制——叶节点是"主张—证据"对——在证据充分时把查询 token 削减 91%,在证据不充分时反而增加 1.9%,平均削减 38%。按这组数据推算,盈亏平衡的充分率约为 2%,而实测充分率接近 43%。这是一个相当宽的利润区间,说明编译产物在真实负载下大概率是划算的。
PageIndex 风格的大纲指一种将文档组织为层级目录(如章节树)的索引结构,类似书籍的目录页,用于导航和定位内容。其优势是结构清晰、可解释性强,但原文指出,当文档规模变大时,这种大纲会出现退化——层级过深或节点过多导致检索效率下降、上下文膨胀,甚至准确率不如扁平检索。这呼应了“编译产物不是更好的检索器”的论点:结构化大纲在规模扩展时未必优于简单检索,其价值需结合供给场景评估。
决策门与延迟权衡
编译不是免费的。原文提到一个决策门(decision gate)把延迟从 140 秒压到 30 秒,但替代机制省下的 token 是用检索轮次换来的,本身也带有延迟成本。这里存在一个清晰的权衡结构:导航树压缩的是"喂进去的上下文",决策门压缩的是"不必要的探索",两者针对的是循环的不同环节。
这也提醒我们,agentic 系统的优化不能只看单一指标。省 token 可能增加轮次,减轮次可能牺牲召回,最终要在一个多目标函数上找平衡点。原文说的"盈亏平衡充分率",本质上是在问:在什么样的证据充分率下,编译产物的成本才能被收益覆盖。实测充分率接近 43%,远高于 2% 的平衡点,说明这条路在统计上是成立的。
盈亏平衡充分率是衡量知识编译经济性的一个派生指标:当证据充分时,编译产物(如导航树)能显著削减查询 token;当证据不充分时,反而可能增加 token 消耗。设充分时节省比例为 s,不充分时增加比例为 i,则平均节省 = s × p - i × (1-p),其中 p 为充分率。令平均节省为零,可解出盈亏平衡充分率 p* = i / (s + i)。原文中 s=91%,i=1.9%,代入得 p* ≈ 2%。实测充分率接近 43%,远高于平衡点,意味着在真实负载下编译产物的 token 收益大概率覆盖成本。这一指标为评估编译层是否划算提供了量化依据。
其他编译产物的价值在部署侧
本体、图、wiki、时间线、思维导图和记忆这几类产物,在准确率基准上看不出优势。原文的判断是,它们的回报出现在部署阶段:治理、集成、上手、时间定向和连续性。这些都是基准测试看不见的地方。
这个观察对工程团队有直接意义。如果你的评估只看 FRAMES 或 BrowseComp-Plus 这类准确率指标,你可能会得出"知识编译没用"的结论;但真实系统的痛点在别处——新成员如何理解数据、权限如何治理、跨系统如何集成、对话如何保持连续性。这些恰恰是编译产物擅长的领域。
RAGFlow 的五站流水线与 Agent 原生数据库
原文描述了 RAGFlow 的流水线和外挂(开源地址:https://github.com/infiniflow/ragflow),把 agentic 循环拆成五个有纪律的站点,核心目标只有一个:让进入模型的上下文始终是最小充分集。
作者把这一组合称为"agent 原生数据库":一个把编译好、可治理的上下文交给 agent 的存储层,而不是返回一个排序后的段落列表。这个定位值得注意——它把 RAG 从"检索管道"重新定义为"上下文基础设施",检索只是其中一个环节,编译、治理和供给才是长期价值所在。
对正在构建 agentic 系统的团队来说,这意味着架构重心需要前移:与其不断调优检索器,不如先想清楚上下文如何被编译、如何被治理、如何以最小充分集进入模型。准确率的天花板往往不在检索器上,而在供给层的设计上。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。