深度序列模型如何赋能时间序列的保形预测

系统探索深度序列模型融入保形预测的三条路径,为时间序列不确定性量化提供理论与方法支撑。
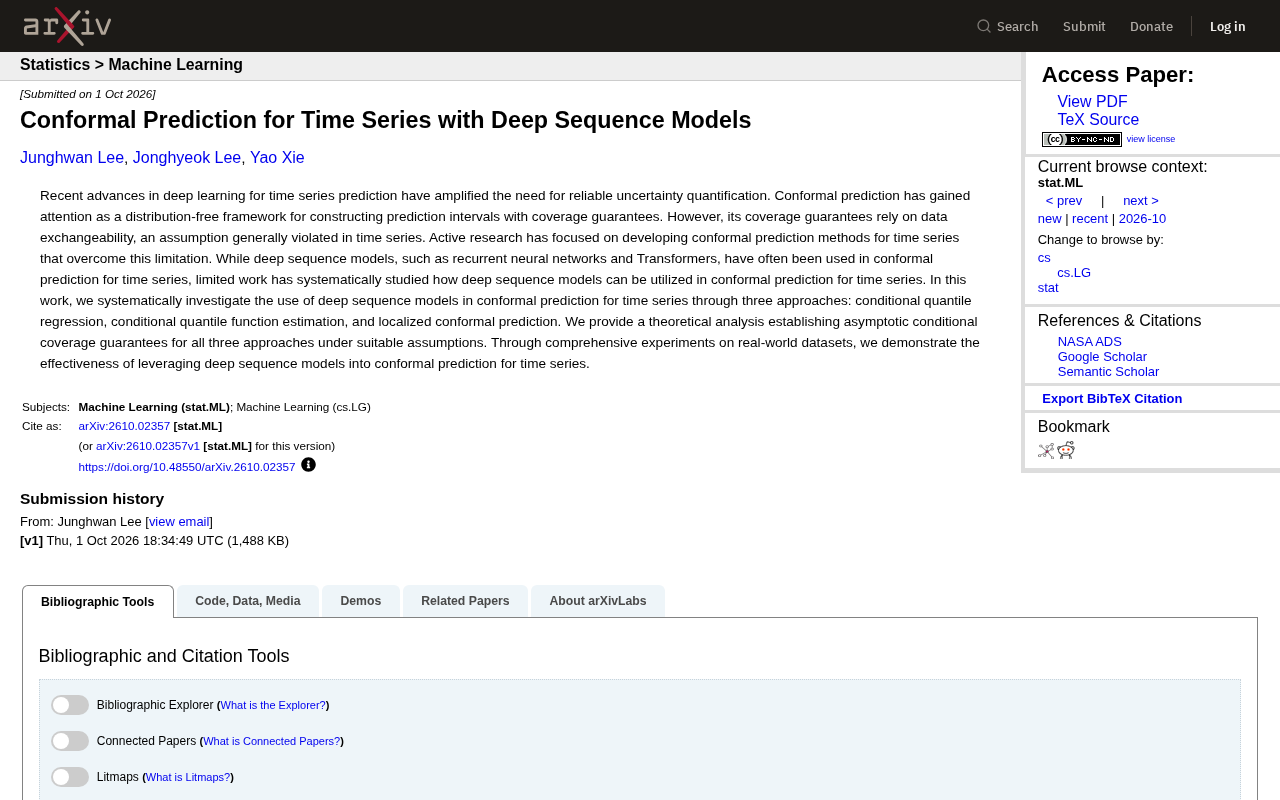
深度学习时间序列预测长期缺乏可靠的不确定性量化手段。保形预测虽能提供无分布假设的预测区间覆盖率保证,但其核心前提——数据可交换性——在时序场景中几乎必然被违反。本研究系统性地考察了将深度序列模型(RNN、Transformer等)融入时序保形预测的三条路径:条件分位数回归、条件分位数函数估计和局部化保形预测。三种方法各有侧重,分别在实现难度、分布刻画完整性和非平稳适应性上有所取舍。研究进一步从理论层面证明,在适当假设下三种方法均可实现渐近条件覆盖保证——这比标准的边际覆盖更为严格,意味着预测区间在具体条件下同样可靠。真实数据集实验验证了方法的有效性,为工程团队在生产环境中部署可信时序预测提供了系统性参考。
不确定性量化:时间序列预测的关键缺口
深度学习在时间序列预测领域取得了显著进展,但一个长期被忽视的问题逐渐凸显——模型给出的预测究竟有多可靠?单纯的点预测无法回答这个问题,而**可靠的不确定性量化(uncertainty quantification)**正成为学术界和工业界的共同诉求。
保形预测(Conformal Prediction)作为一种**无需分布假设(distribution-free)**的框架,近年来受到广泛关注。它的核心价值在于能够构造带有覆盖率保证(coverage guarantee)的预测区间,而不依赖对数据分布形态的强假设。换句话说,它能在一定置信水平下告诉你真实值落在某个区间内的概率,这对于高风险决策场景尤为重要。
可交换性假设:时间序列的天然障碍
保形预测的覆盖率保证建立在**数据可交换性(exchangeability)**这一前提之上。所谓可交换性,简单理解就是数据样本的顺序不影响其联合分布。然而对于时间序列数据,这个假设几乎必然被违反——时间序列本质上存在时序依赖、趋势和自相关结构,样本顺序恰恰承载着关键信息。
这正是将保形预测应用于时间序列时面临的核心矛盾。近年来大量研究致力于突破这一限制,提出各种适配时序特性的保形预测变体。尽管循环神经网络(RNN)和 Transformer 等深度序列模型经常被用作这些方法的底层组件,但一个明显的研究空白是:学界缺乏对深度序列模型在时间序列保形预测中如何系统性发挥作用的研究。
为了在时间序列场景下维持某种形式的覆盖率保证,研究者通常采用两类变通策略。一是加权保形预测(weighted conformal prediction),通过对历史样本按时间衰减或相似度赋权,近似满足弱化版的可交换性条件;二是利用混合(mixing)性质——若时间序列的时序依赖随滞后期增大而快速衰减(即满足强混合或β-混合条件),可以证明标准保形预测的覆盖误差会以可控速率收敛,从而在渐近意义上恢复保证。局部化保形预测本质上也属于这一思路的延伸,通过学习样本间的相似性来构造局部可交换的数据子集。理解这一背景有助于把握三条技术路径各自所针对的"可交换性破坏程度"差异。
三条技术路径的系统性探索
这项工作的价值在于,它不满足于零散地使用深度序列模型,而是系统性地考察了三种集成方式:
条件分位数回归
第一种路径是条件分位数回归(conditional quantile regression)。该方法直接利用深度序列模型估计给定历史信息条件下的目标分位数,从而构造预测区间。深度模型强大的序列建模能力使其能够捕捉复杂的时序依赖,为分位数估计提供更贴合实际的条件分布刻画。
条件分位数回归源自经典的分位数回归(Quantile Regression)框架,由Koenker与Bassett于1978年提出。其训练目标是Pinball Loss(弹球损失):对于目标分位数τ,若预测值高于真实值则以(1-τ)为权重惩罚,低于则以τ为权重惩罚,从而使模型输出收敛到真实的条件分位数。在深度学习中,通常同时训练多个分位数头(如τ=0.05和τ=0.95)以构造90%预测区间。将深度序列模型(如LSTM或Transformer)作为骨干网络,可以让分位数估计充分利用长程时序依赖,而非依赖独立同分布假设。但单纯的分位数回归不提供覆盖率的有限样本保证,需要结合保形校准步骤才能获得严格的统计意义。
条件分位数函数估计
第二种是条件分位数函数估计(conditional quantile function estimation)。相较于只估计若干离散分位点,这种方法试图刻画完整的条件分位数函数,提供对条件分布更全面的描述,从而在构造预测区间时具备更强的灵活性。
局部化保形预测
第三种是局部化保形预测(localized conformal prediction)。它通过深度序列模型学习样本间的相似性或局部权重,在校准阶段对不同样本赋予差异化的权重,以此缓解可交换性被破坏带来的影响。这种局部自适应的思路,是应对时序非平稳特性的务实选择。
理论保证与实验验证
除了方法设计,研究还为三种路径提供了理论分析。在适当假设下,作者证明了这三种方法都能实现渐近条件覆盖(asymptotic conditional coverage)保证。这一点尤为关键——条件覆盖比边际覆盖更强,意味着预测区间在各类具体条件下都能保持可靠性,而非仅在整体平均意义上成立。
在真实世界数据集上的全面实验进一步验证了方法的有效性。实验结果表明,将深度序列模型恰当地融入保形预测框架,确实能够提升时间序列预测区间的质量,兼顾覆盖率与区间宽度的平衡。
边际覆盖(marginal coverage)与条件覆盖(conditional coverage)的区别值得单独说明。边际覆盖保证的是:在所有测试样本上,预测区间包含真实值的比例(期望意义上)不低于设定的置信水平,例如90%。这是经典保形预测的标准保证,相对容易实现。条件覆盖则更严格——它要求对于任意给定的输入条件(如特定的历史模式、时间点或协变量取值),预测区间都能维持目标覆盖率。在实践中,若模型仅满足边际覆盖,可能出现在某些子群体或时段覆盖率严重不足、在另一些区间又冗余过宽的现象,导致区间在关键场景下失去参考价值。渐近条件覆盖保证意味着随样本量增大,方法能逐步逼近更理想的逐条件可靠性,这是三种方法理论贡献的核心所在。
对实践者的启示
对于需要在时间序列任务中部署可信预测的工程团队而言,这项研究提供了几点有价值的参考。深度序列模型不只是提升点预测精度的工具,它们在不确定性量化中同样能扮演核心角色。三条技术路径各有侧重:条件分位数回归实现相对直接,分位数函数估计提供更完整的分布信息,局部化方法则在应对非平稳性上更具针对性。
随着大模型和深度序列架构在预测任务中的普及,如何让这些模型输出可信赖的区间而非仅仅是单点数值,将是从实验室走向生产环境的必经之路。这项系统性研究,为这一方向奠定了理论与方法基础。
相关推荐

Codex入门指南:OpenAI编程智能体与ChatGPT有何不同
Codex是OpenAI推出的AI编程智能体,能自主阅读、修改代码并执行测试。本文解析Codex与ChatGPT的核心区别,以及开发者为什么要学习这类AI编程工具。

Gemini Agent发布:Argon模型太强不敢放出,AI圈新动态盘点
Google发布办公通用智能体Gemini Agent,支持Gemini 4 Argon与Claude Opus 5.5,但Argon因太强暂不开放。本文盘点Odyssey 3世界模型、OpenAI营收、Arena融资等一周AI圈动态。

Sophos借OpenAI Daybreak把威胁响应时间压缩96%
Sophos首席技术官披露,借助OpenAI Daybreak项目和自研安全智能体,其MDR业务平均威胁响应时间从38分钟压缩至89秒,降幅达96%。本文解析其规划-执行-观察闭环架构及AI护栏松绑的意义。