生产环境AI智能体去留决策:如何衡量价值与管控风险
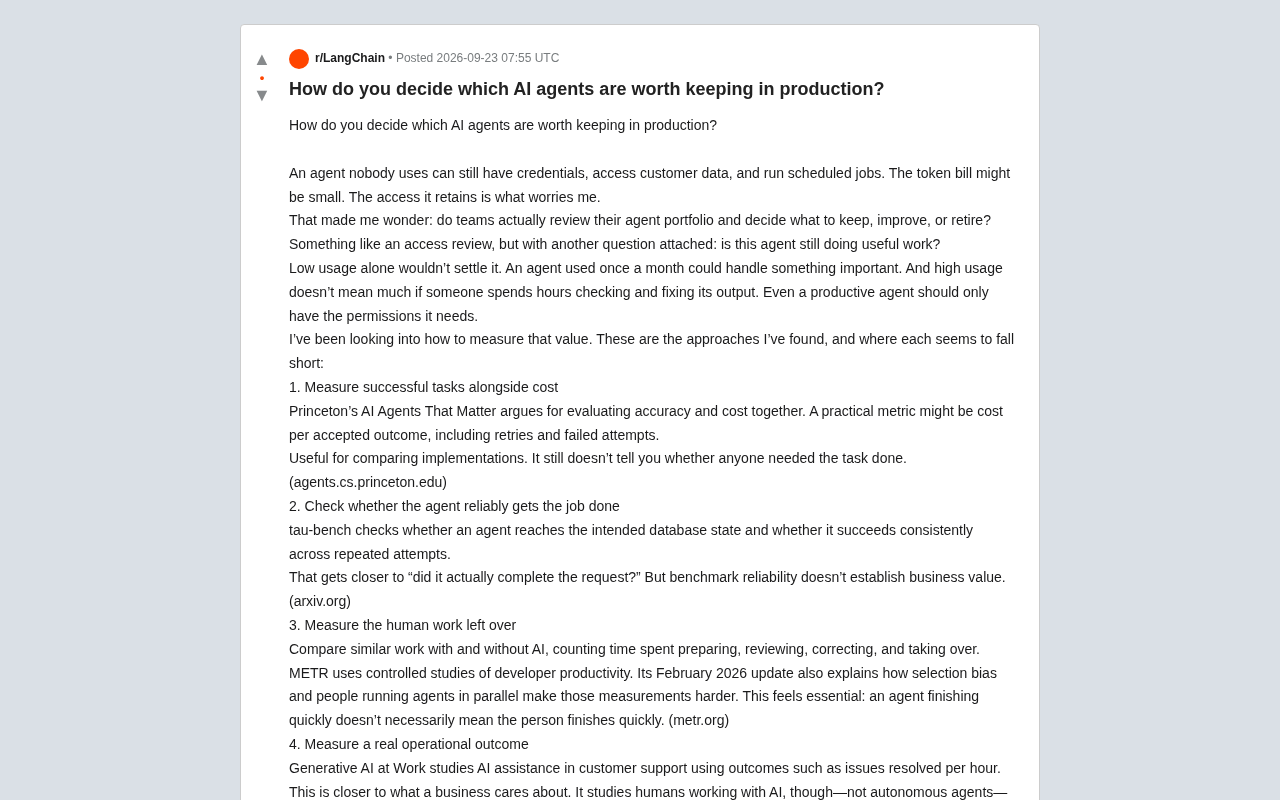
被遗忘的AI智能体仍持有凭证与数据权限,如何系统衡量其价值并决定去留是当前企业治理的核心难题。
文章围绕一个被忽视的生产环境问题展开:企业部署的AI智能体中,那些低使用率甚至完全闲置的个体,虽然Token成本微乎其微,却可能仍持有系统凭证、数据访问权和定时任务,构成真实的安全隐患。作者系统梳理了衡量智能体业务价值的五种主流方法——成本准确率联合评估、任务可靠性基准测试、人工残留工作量统计、真实运营产出测量、使用数据估算——并逐一分析其局限性。核心结论是:这五种方法各解决拼图一角,但都无法单独支撑"保留、修复还是下线"的可执行决策。文章进而提出,价值审查必须与权限审查合并进行,最小权限原则应贯穿智能体全生命周期,并给出了一套适用于生产环境团队的实践清单。
被遗忘的智能体,才是真正的安全隐患
一个没人用的AI智能体,Token账单可能微不足道,但它带来的风险却被严重低估。它可能仍然持有系统凭证、能访问客户数据、还在按计划自动运行定时任务。Reddit上一位从业者提出了一个尖锐的问题:团队真的会定期审查自己的智能体组合,决定哪些该保留、改进或下线吗?
这不仅是一次访问权限审查(access review),还附带了一个更难回答的问题——**这个智能体是否还在做有用的工作?**当企业在生产环境中部署越来越多的自主智能体后,"该留下谁"逐渐从技术问题演变为治理问题。低使用率不能作为唯一判断依据:一个每月只跑一次的智能体,可能处理的正是关键任务;反过来,高频调用也说明不了什么——如果有人要花数小时检查和修正它的输出,那它的"高产"其实是负担。
五种衡量智能体价值的方法及其局限
原帖作者系统梳理了当前学术界和产业界提出的五种衡量思路,每一种都有其价值,也都有明显的短板。这些方法覆盖了从技术评测到真实业务产出的完整光谱。
从准确率与成本的联合评估出发
普林斯顿大学的研究《AI Agents That Matter》主张同时评估准确率与成本。一个实用的指标是"每次被采纳结果的成本"(cost per accepted outcome),把重试和失败的尝试都计入其中。这个指标非常适合横向比较不同实现方案的效率,但它无法回答一个根本问题:这个任务到底有没有人需要它被完成?
检验任务是否被可靠地完成
tau-bench 基准测试关注智能体是否达到了预期的数据库状态,以及在多次重复尝试中能否稳定成功。这比单纯的准确率更接近"它真的完成了请求吗"这一问题。但基准测试上的可靠性,并不能等同于业务价值——测试跑得漂亮,不代表这件事对公司有意义。
tau-bench 是由斯坦福大学等机构提出的智能体评测基准,专门针对"工具辅助代理"(tool-use agents)在真实数据库交互场景下的可靠性评估。它的核心设计理念是:不以单次对话的输出内容来判断成败,而以智能体执行完毕后系统状态是否符合预期为标准,并要求智能体在相同任务上多次重复均能稳定成功,从而测量一致性而非偶发表现。这种设计能有效暴露那些"偶尔能答对,但流程逻辑不稳定"的智能体——这类智能体在真实生产环境中往往是事故的潜在来源。
测量残留的人工工作量
这是原帖作者认为最本质的一种思路:对比有AI和无AI两种情况下完成相似工作的差异,统计准备、审查、纠错和接管所花的时间。METR通过对开发者生产力的受控研究来做这件事,其2026年2月的更新还说明了选择偏差、以及人们并行运行多个智能体如何让这类测量变得更困难。核心洞察在于:智能体快速完成任务,并不意味着人也快速完成了工作。
METR(Model Evaluation & Threat Research)是一家专注于AI能力与风险评估的独立研究机构,其对开发者生产力的研究采用受控实验设计,将相同任务随机分配给"有AI辅助"和"无AI辅助"两组开发者,通过对比实际完成时间来量化AI带来的真实加速效果。2026年2月的更新特别指出了两类测量难题:一是选择偏差——开发者倾向于将AI用于自己认为AI擅长的任务,导致样本不具代表性;二是并行化效应——当开发者同时运行多个智能体时,个人的"墙钟时间"节省不再能直接反映单个智能体的价值贡献,传统的时间对比方法因此失效。
测量真实的运营产出
《Generative AI at Work》研究了AI在客户支持中的辅助作用,使用"每小时解决的问题数"这类结果指标。这最贴近企业真正关心的东西。但它研究的是人机协作,而非完全自主的智能体,而且要把AI的贡献从其他变化中剥离出来,需要相当谨慎的实验设计。
从使用数据估算节省的时间
Anthropic的《Estimating AI Productivity Gains》用模型从对话记录中估算有AI和无AI情况下的任务耗时。这种方式比逐个给员工计时更容易规模化。但估算出的节省不等于实际观察到的节省,一段对话也无法呈现后续发生的全部工作。
从测量到决策:真正难的一步
原帖作者坦言,他真正困惑的地方在于:如何把这些测量结果,连接到一个具体可执行的决定——保留这个智能体、修复它、还是关掉它并撤销其权限?
五种方法各自解决了拼图的一角,但没有一种能单独支撑这个决策。技术基准告诉你它"能不能干",运营指标告诉你它"干得值不值",而人工残留工作量则揭示了那些容易被忽略的隐性成本。一个看似高产的智能体,如果背后需要大量的人工兜底,它的净价值可能是负的。
更关键的是安全维度往往被排除在价值评估之外。价值评估回答"该不该留",而权限审查回答"它拿着多少不该拿的东西"。这两个问题需要合并处理:即便是一个高产的智能体,也应当只持有它所需的最小权限。一个既没价值又握有客户数据访问权的"僵尸智能体",才是最该被优先清理的对象。
最小权限原则(Principle of Least Privilege,PoLP)是信息安全领域的基础原则,要求任何系统组件——包括用户账户、服务进程和自动化智能体——只持有完成其指定功能所必需的最低限度权限,不多授予一分。对AI智能体而言,这意味着一个负责生成周报的智能体,不应持有写入生产数据库或访问全量客户记录的凭证,即便这些权限在初始配置时"顺手"一起给了。随着企业智能体数量增多,权限蔓延(permission creep)问题会悄然累积——每个单独授权看似合理,整体叠加后攻击面却已大幅扩展。将价值评审与权限审查合并的制度意义正在于此:下线决策不只是"停止运行",还必须包括凭证吊销和访问权回收。
给生产环境团队的实践清单
综合原帖讨论,可以提炼出一套务实的智能体组合审查框架:
- 定期做智能体资产盘点:不只是看Token账单,而要列出每个智能体持有的凭证、数据访问权限和定时任务。
- 用"每次被采纳结果的成本"衡量效率:把重试与失败计入,避免被表面的成功率误导。
- 显式统计人工兜底成本:审查、纠错、接管的时间,是判断净价值的关键,也最容易被漏算。
- 绑定一个真实运营指标:如客服场景的"每小时解决问题数",让价值锚定在业务结果上。
- 价值审查与权限审查合并进行:无论去留,最小权限原则都应贯穿始终。
原帖最后的呼吁值得每个从业者思考:一个具体的例子——这个智能体做什么、你测量什么、这个测量改变了什么决定——比任何理论都更有说服力。而一份手工维护的月度审查表格,其价值可能不亚于一套专门的监控工具。当智能体数量持续膨胀,主动淘汰的能力,或许和构建的能力同样重要。
相关推荐
用AI照抄舞蹈动作:换人换画风不换动作实操教程
详解如何用AI复刻舞蹈动作,实现换人、换画风但保留原动作的效果。通过Flova拉片大师工具,上传角色参考图、舞蹈视频和深度视频即可自动生成,附完整操作步骤。
医生职业的阴暗面:一篇引发热议的深度反思
一篇题为《医生职业的阴暗面》的文章登上 Hacker News 热榜,获 254 赞与 287 评论。本文解读该话题为何在技术社区引发热议,并探讨职业倦怠这一跨行业的普遍命题。
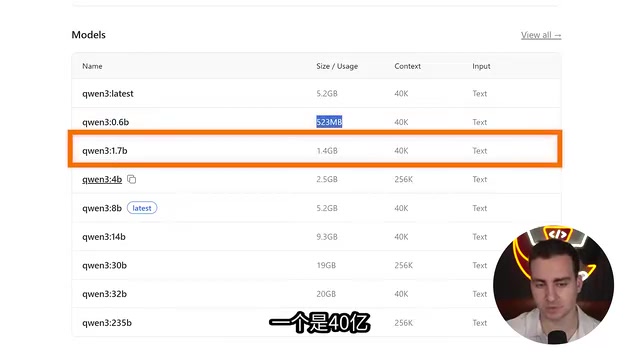
10分钟用Python搭建完全本地的AI智能体教程
本教程演示如何用 Ollama 和 Pydantic AI,几十行 Python 代码搭建完全本地运行的AI智能体,涵盖模型选择、工具函数定义和主循环编写,实现离线、免费、隐私安全的智能体应用。