SkyRL实现Beam Day-0强化学习支持,LoRA解码吞吐提升62%
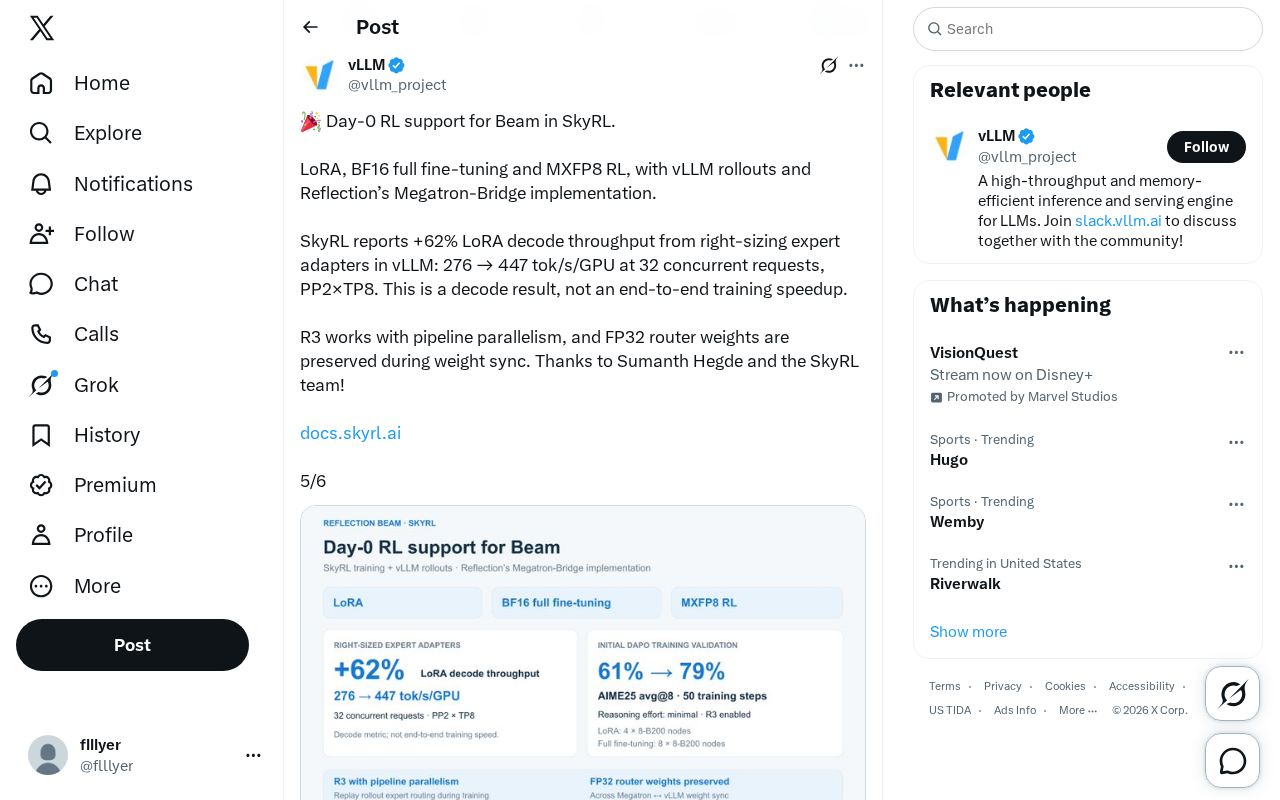
SkyRL 为 Beam 模型提供 Day-0 强化学习支持,统一三种训练模式并实现 62% 解码吞吐提升。
SkyRL 团队宣布与 Reflection 合作,为 Beam 模型实现 Day-0 强化学习支持,模型发布当天即可接入完整 RL 训练流程。该支持将 LoRA 微调、BF16 全量微调和 MXFP8 低精度强化学习统一到 vLLM 推理与 Megatron-Bridge 训练框架中,形成从 rollout 采样到参数更新的闭环。R3 分布式方案可与流水线并行配合,并在权重同步时保留 FP32 路由器权重以维持 MoE 路由的数值稳定。官方数据显示,通过合理配置 vLLM 专家适配器,LoRA 解码吞吐从 276 提升至 447 tok/s/GPU,增幅约 62%,但这是解码阶段结果而非端到端训练加速比。该进展降低了切换训练模式的成本,为 MoE 与低精度 RL 基础设施提供了可复用基准。
SkyRL 团队宣布对 Reflection 的 Beam 模型实现 Day-0 强化学习支持,这意味着 Beam 模型在发布当天就能接入完整的 RL 训练流程。这一进展来自 SkyRL 与 Reflection 的合作,核心突破在于将 LoRA、BF16 全量微调和 MXFP8 强化学习统一到 vLLM 推理与 Megatron-Bridge 训练框架中。
技术栈整合:vLLM 与 Megatron-Bridge 的协同
SkyRL 此次支持覆盖了三种训练模式:LoRA 微调、BF16 全量微调和 MXFP8 低精度强化学习。推理侧使用 vLLM 进行 rollout 生成,训练侧则依托 Reflection 的 Megatron-Bridge 实现。这种组合让 Beam 模型可以在同一套基础设施内完成从采样到更新的闭环。
你可能没注意到,R3(SkyRL 的分布式训练方案)已经能够与流水线并行(Pipeline Parallelism)配合工作。在权重同步过程中,FP32 路由器权重被完整保留,避免了低精度转换带来的数值不稳定问题。
LoRA、全量微调与低精度 RL 的差异
LoRA(Low-Rank Adaptation)通过在权重旁挂载低秩矩阵来训练,冻结原模型参数,显存占用和通信量都远小于全量微调,适合快速迭代和多任务切换。BF16 全量微调更新全部参数,精度较高但显存与带宽压力大,通常用于追求最终效果的场景。MXFP8 是一种 8 位浮点微缩放格式,每个小块共享一个指数缩放因子,在保持动态范围的同时把权重和激活压到 8 位,可显著提升算力和显存效率,但对数值稳定性更敏感,因此需要配合 FP32 路由器权重等保护措施。三者统一到同一工具链,意味着团队可以按任务需求在成本、速度和精度之间灵活选择,而不必更换训练框架。
62% 解码吞吐提升的来源
SkyRL 在官方报告中给出了一个关键数据:通过合理配置 vLLM 中的专家适配器(expert adapters),LoRA 解码吞吐从 276 tok/s/GPU 提升到 447 tok/s/GPU,在 32 并发请求、PP2×TP8 的配置下实现了约 62% 的增长。
需要明确的是,这是一个解码阶段的结果,并非端到端训练加速比。解码吞吐的提升直接影响 RL rollout 的效率,因为强化学习训练中大量时间花在生成样本上。对于 Beam 这类专家混合(MoE)架构的模型,专家适配器的配置方式会显著影响推理效率,SkyRL 的调优经验为类似场景提供了可复用的参考。
专家适配器与 MoE 推理
专家适配器(expert adapters)是针对 MoE 模型中每个专家分别挂载的 LoRA 适配器。与稠密模型只挂一组适配器不同,MoE 的每个专家都有独立权重,推理时 token 被路由到少数专家,若适配器组织不当,会造成 kernel 启动频繁、显存访问碎片化和批处理效率下降。vLLM 通过将各专家的适配器批量组织、与专家计算融合调度,减少额外开销,从而在不改变模型结构的前提下提升解码吞吐。这也解释了为何 62% 的提升高度依赖具体配置:专家数量、路由分布和并发度都会影响适配器的调度效率。
对 RL 训练工作流的意义
Day-0 支持意味着新模型发布当天即可进入 RL 后训练流程,而不必等待框架适配。SkyRL 将 LoRA、全量微调和 MXFP8 三种路径统一到同一套工具链,降低了研究者和工程团队切换训练模式的成本。
从工程角度看,vLLM rollout 与 Megatron-Bridge 训练的组合兼顾了推理吞吐和训练稳定性。FP32 路由器权重的保留说明团队在追求低精度训练效率的同时,没有牺牲 MoE 路由的数值精度。
Day-0 支持的含义
Day-0 支持指新模型发布当天,训练框架就已完成适配,可直接用于 RL 后训练。传统流程中,新模型发布后框架方需数周时间适配权重格式、并行切分和推理 kernel,期间研究者只能等待。实现 Day-0 需要框架提前获知模型结构,并复用 vLLM 与 Megatron 的通用接口,使新模型只需提供配置即可接入。对 RL 后训练尤其重要,因为 RL 依赖大量在线 rollout,推理与训练框架的对接成本往往高于监督微调。
展望
SkyRL 此次更新体现了 RL 训练框架向“模型发布即支持”方向演进的趋势。随着 MoE 架构和低精度训练成为主流,如何在 vLLM 推理与 Megatron 训练之间高效同步权重、如何针对专家适配器做细粒度调优,将成为 RL 基础设施竞争的关键点。SkyRL 公开的解码吞吐数据和配置细节,为社区提供了有价值的实践基准。
相关推荐

Product Hunt 推出可视化发布编辑器,告别繁琐填写
Product Hunt 推出可视化发布编辑器,支持点击原位编辑名称、标语、画廊和 maker 信息,自动保存草稿,并用检查清单引导创作者完成发布。本文解析其编辑逻辑与对发布体验的影响。

泽连斯基亲述:俄军2000万人压境,我们如何守住基辅
泽连斯基访谈回顾俄乌战争初期:俄军200,000兵力直扑基辅,乌军主力却在东部。他讲述动员如何将军队从200,000扩张到800,000,以及基辅州、切尔尼戈夫州如何被收复。

Ovren Live Preview:用自然语言实时预览产品改动
Ovren Live Preview 是一款用自然语言描述改动、在真实页面上实时预览的 AI 开发工具。了解其核心功能、工作流、市场定位与潜在挑战。