SLAM-ASR语音识别背后的归纳头机制
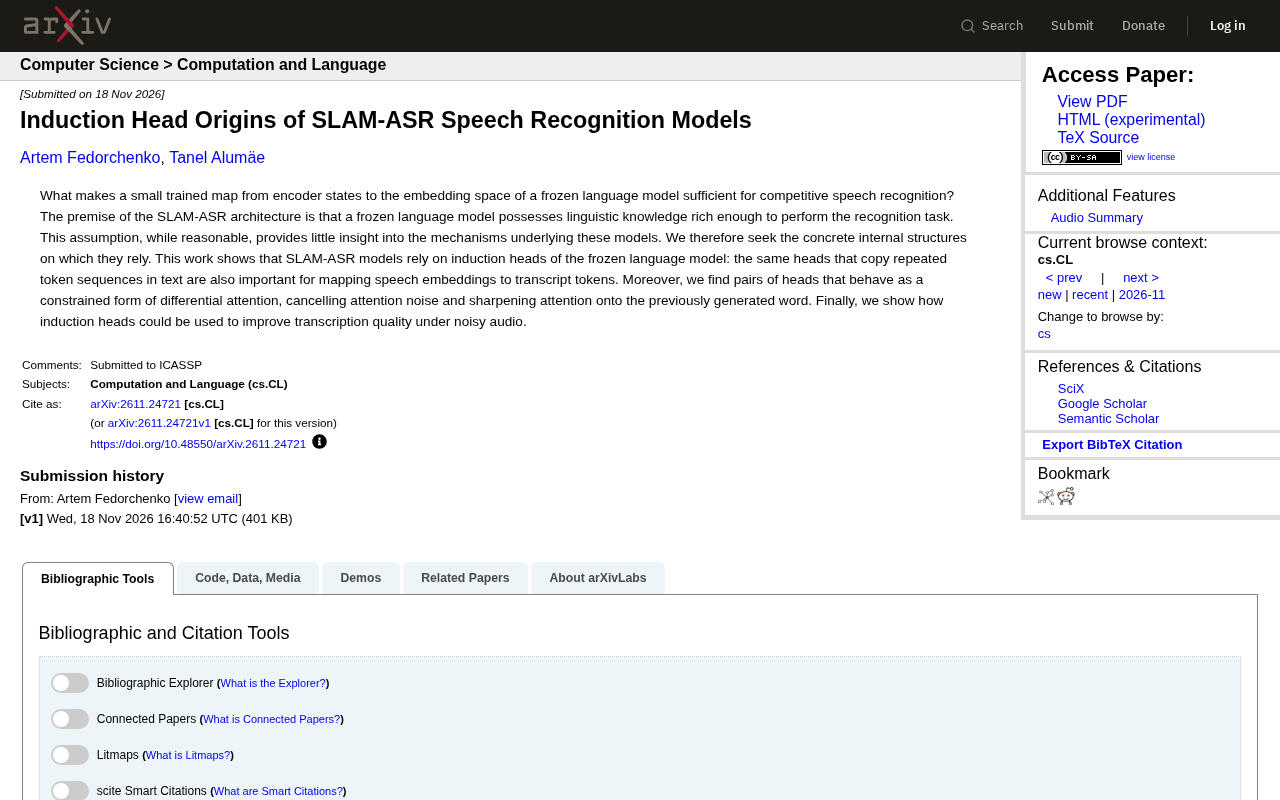
SLAM-ASR 借冻结语言模型中的归纳头完成语音到文本的映射。
该文解读了一项对 SLAM-ASR 内部机制的研究。SLAM-ASR 仅训练一个小型映射层,将语音编码器输出对齐到冻结语言模型的嵌入空间。研究发现,其性能关键依赖语言模型中原有的归纳头——这类注意力头本用于复制文本中的重复序列,如今被复用为把语音嵌入映射为转录 token 的组件,使语音识别转化为一种广义序列复制任务,这也解释了小映射层为何足够。此外,模型中出现一对表现出受限差分注意力行为的注意力头,可抑制无关注意力噪声并将焦点锐化到前一个已生成词,提升转录连贯性。研究还提出可通过引导归纳头改善噪声环境下的转录质量,并为参数高效多模态架构设计与可解释性调试提供依据。
引言:小映射为何能实现强识别?
SLAM-ASR 架构的核心前提是:一个冻结的语言模型已经具备足够丰富的语言知识来完成语音识别任务。因此,只需一个小型可训练映射,就能将编码器状态对齐到语言模型的嵌入空间。这个假设虽然合理,却未能揭示模型内部究竟依赖哪些具体结构。
近期一篇研究深入探查了 SLAM-ASR 的内部机制,发现其性能关键依赖于冻结语言模型中的归纳头(induction heads)——这些注意力头原本负责在文本中复制重复的 token 序列,现在却被复用为将语音嵌入映射到转录 token 的核心组件。
SLAM-ASR(Speech Language Model for Automatic Speech Recognition)是近年来出现的一类参数高效语音识别架构,其典型做法是将预训练的语音编码器(如 Whisper 编码器或 wav2vec 2.0)与一个冻结的大语言模型通过轻量映射层连接,仅训练映射层即可完成识别。与之相对,传统端到端语音识别通常需要微调整个声学模型或语言模型。SLAM-ASR 的代表性工作包括基于 Llama、Qwen 等解码器构建的系统,它们在大规模语音-文本对上只更新极少参数便取得接近全量微调的效果,因此“小映射为何够用”成为理解该类架构的关键问题。
归纳头:从文本复制到语音映射
归纳头是语言模型中一类特殊的注意力头,它们能够检测重复模式并复制后续 token。在纯文本任务中,这种能力表现为:当序列中出现“A B ... A”时,归纳头会预测下一个 token 为 B。
这项研究表明,SLAM-ASR 模型正是借用了这种机制。当语音编码器输出嵌入序列后,归纳头会将其与已生成的转录 token 进行模式匹配,从而引导语言模型输出正确的文字。换句话说,语音识别被转化为一种广义的序列复制任务,而归纳头恰好擅长此道。
这一发现解释了为什么一个小型映射层就足够:映射层不需要学习复杂的声学-语言对应关系,只需将语音特征“伪装”成语言模型能够识别的 token 模式,剩下的工作由归纳头完成。
归纳头(induction head)最早由 Anthropic 团队在 2022 年的电路分析研究中系统刻画,被视为 Transformer 中实现上下文学习(in-context learning)的核心回路。其典型结构由两个注意力头协作完成:前一个“上一 token 头”把前文出现过的 token 信息写入特定位置,后一个“归纳头”再据此匹配当前 token 并复制其后续内容。研究者通过注意力模式打分、激活修补(activation patching)和消融实验来定位这类头。归纳头的存在解释了模型为何能在没有梯度更新的情况下,仅凭提示中的示例完成新任务——这与 SLAM-ASR 借用冻结语言模型完成语音映射的假设高度吻合。
差分注意力对:抑制噪声,锐化焦点
除了归纳头,研究还发现了一对注意力头,它们表现出一种受限形式的差分注意力行为。这两个头协同工作,一个负责关注上下文中的相关部分,另一个则抑制无关的注意力噪声。
具体来说,这对头能够抵消注意力分布中的干扰成分,将注意力锐化到前一个已生成的词上。这种机制对于维持转录的连贯性至关重要,尤其是在语音信号存在模糊性或背景噪声时。
差分注意力并非全新概念,但这是首次在 SLAM-ASR 模型中被观察到以如此具体的形式存在。它揭示了模型如何在不增加参数量的情况下,实现更精准的注意力聚焦。
差分注意力(differential attention)是一种通过两组注意力图相减来消除噪声的机制,其思想可追溯到 Differential Transformer 等工作:将查询和键拆分为两组,分别计算注意力分布后作差,使共性干扰项相互抵消,只保留真正有区分度的信号。与标准 softmax 注意力容易把概率质量分散到无关 token 不同,差分注意力能以较低的头维度获得更尖锐的聚焦。文中所述“一对注意力头表现出受限形式的差分注意力”,指的是两个独立头在输出层面的协同抵消,而非单个头内部的显式差分设计,因此称为“受限形式”。
利用归纳头提升噪声环境下的转录质量
研究的第三个贡献是展示了如何利用归纳头来改善噪声音频下的转录质量。既然归纳头负责模式复制,那么通过增强或引导这些头的注意力模式,就有可能让模型在嘈杂环境中更稳健地捕捉语音中的语言结构。
虽然原文未提供具体的性能提升数字,但这一方向为语音识别系统的鲁棒性优化提供了新的思路:与其重新训练整个模型,不如针对性地调整归纳头的注意力行为。
对语音识别架构的启示
这项研究的意义超越了 SLAM-ASR 本身。它表明,冻结语言模型中固有的归纳能力可以被下游任务“借用”,而无需微调。这为参数高效的多模态架构设计提供了理论依据:选择合适的预训练语言模型,并设计映射层来激活其归纳头,可能比从头训练更有效。
同时,研究也提醒我们,理解模型的内部机制有助于发现潜在的可解释性线索。归纳头和差分注意力对的存在,为调试和优化语音识别系统提供了具体的干预点。
结语
SLAM-ASR 的成功并非仅仅源于“冻结语言模型+小映射”的简单组合,而是因为这一组合恰好激活了语言模型中已有的归纳头机制。这一发现不仅解释了模型的工作原理,也为未来语音识别系统的设计开辟了新的可能性——从黑箱优化转向对内部机制的精准利用。
相关推荐
AI写代码越来越便宜,真正难的是验证
生成代码越来越便宜,软件团队的瓶颈转向验证。结合萨提亚·纳德拉访谈,解析编程智能体的规格说明、多模型审查、权限分离与组织调整,以及工程师如何把一次修复沉淀为团队可复用的能力。
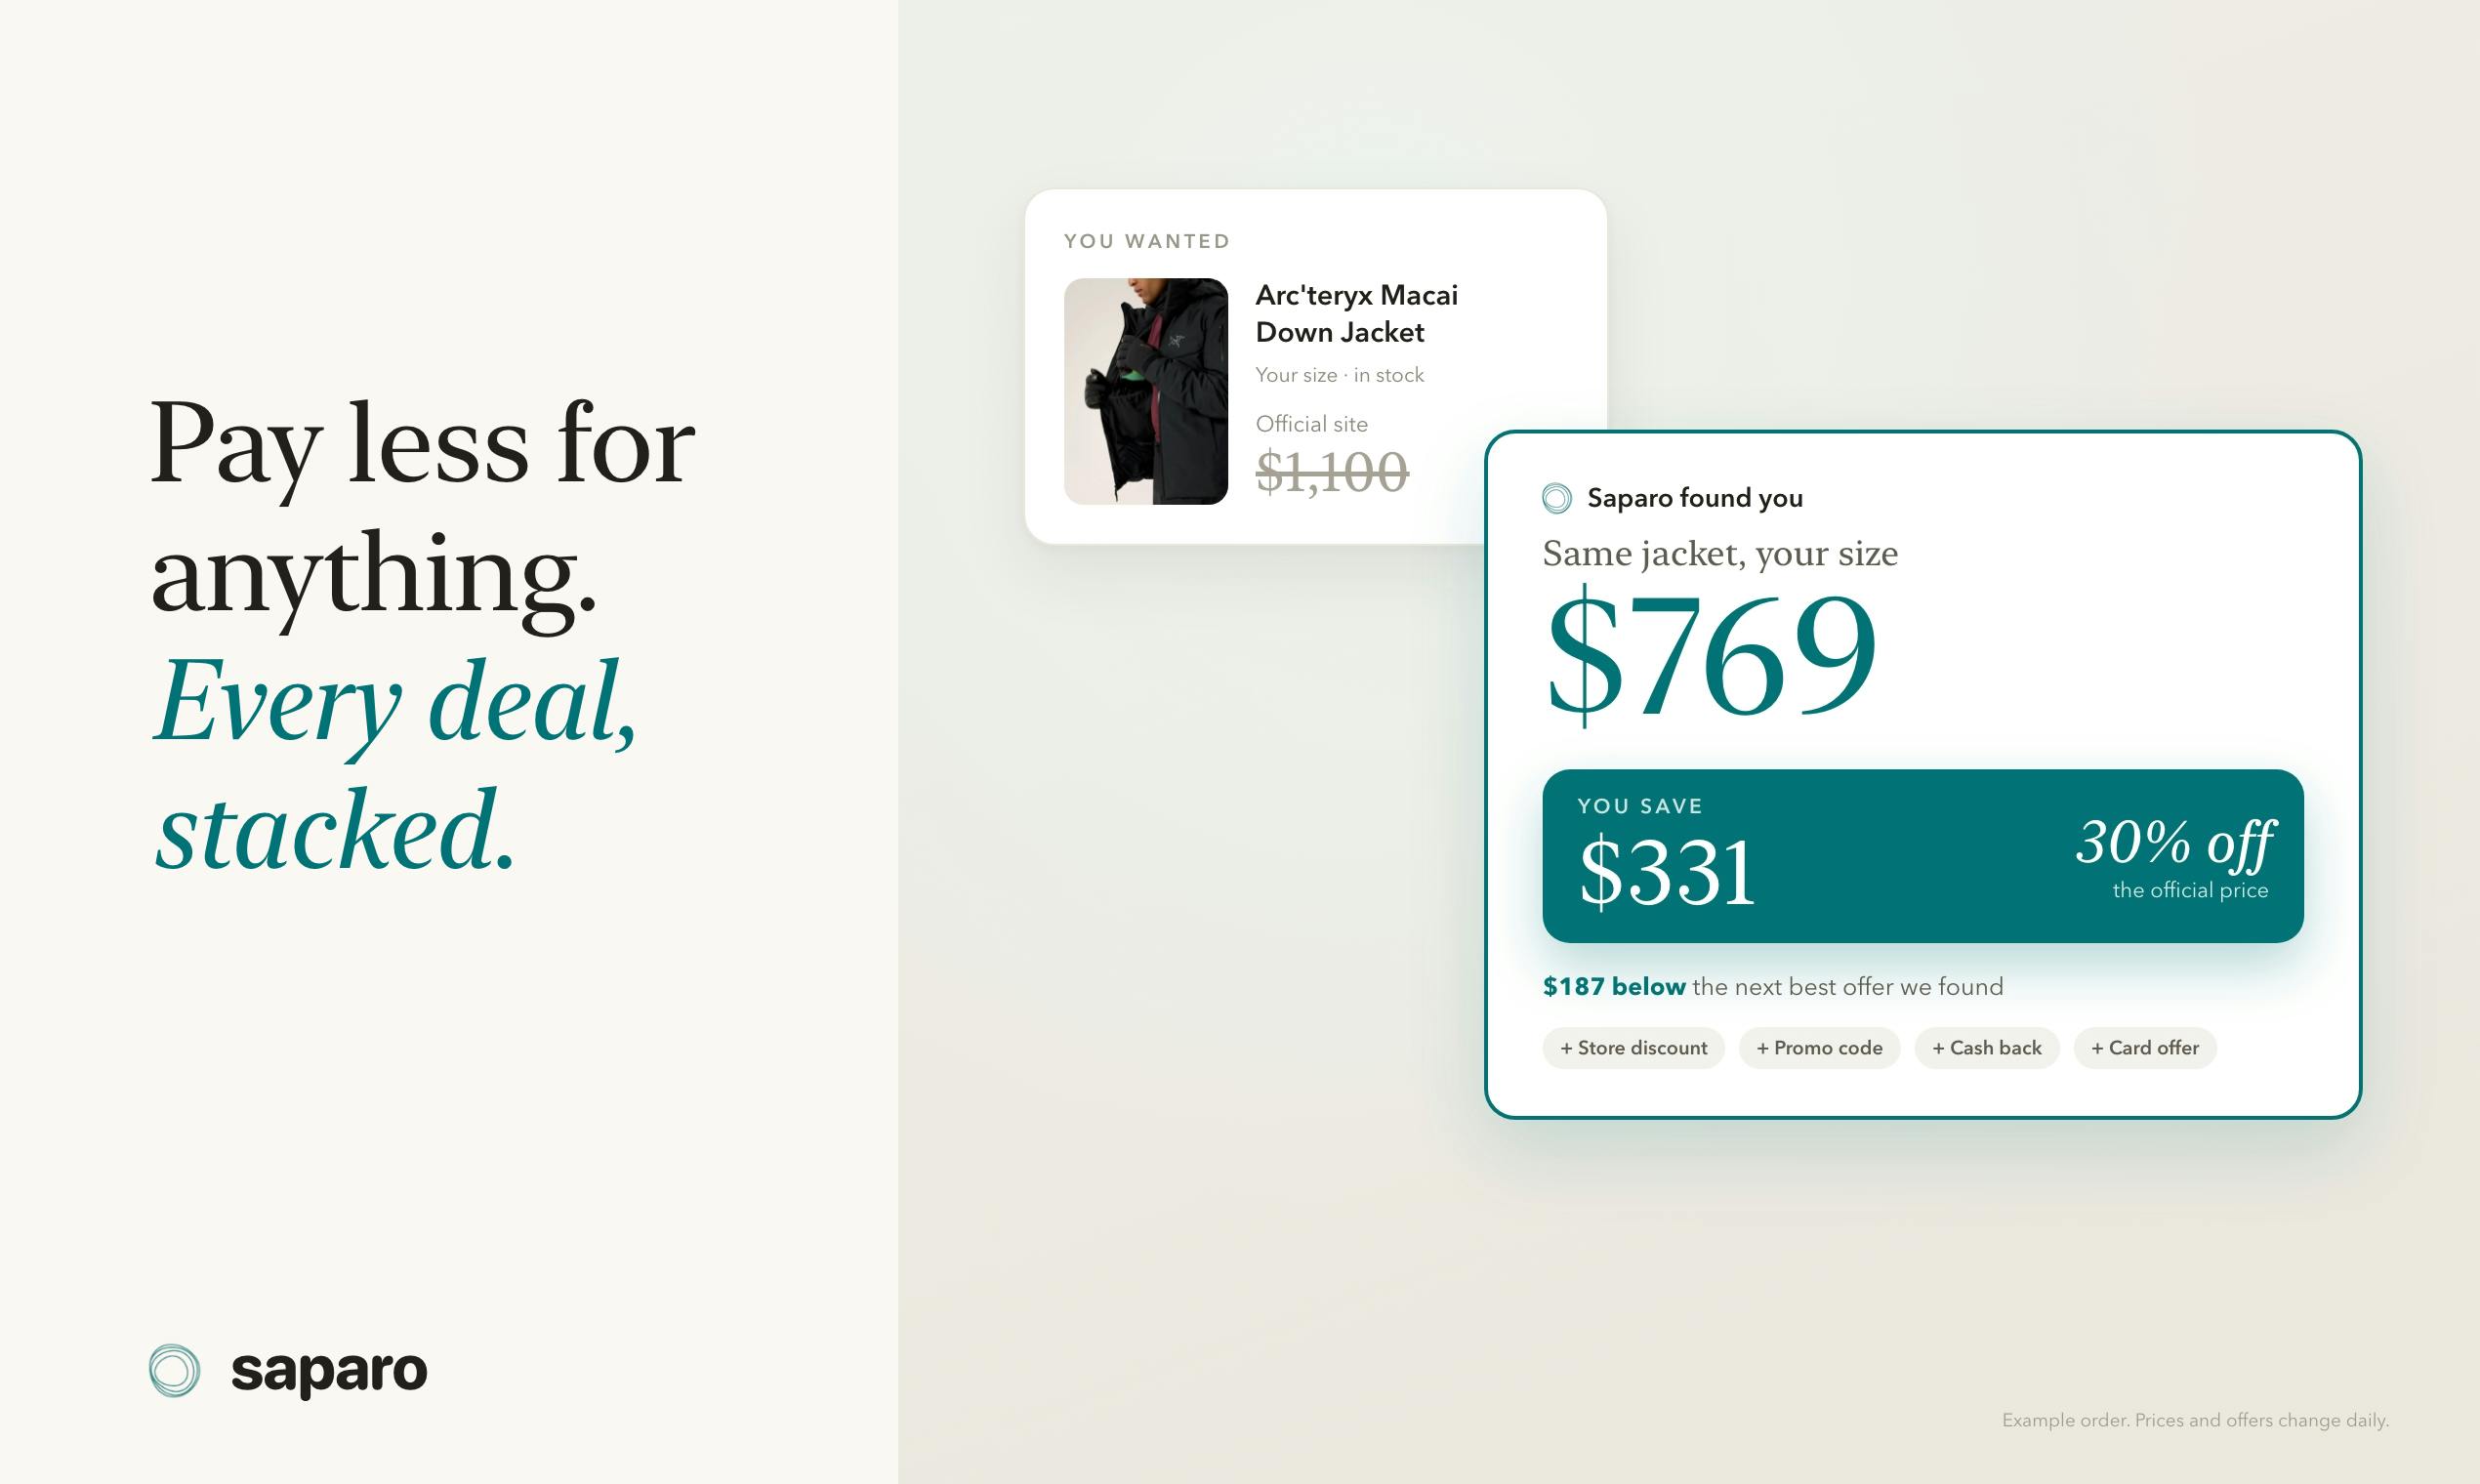
Saparo:自动叠加优惠的购物AI代理,登顶Product Hunt
Saparo 是一款自动叠加优惠的购物 AI 代理,登顶 Product Hunt。它能搜索同款、匹配尺码、组合促销码与返现,按含运费税费的总成本排序,最终支付由用户完成。
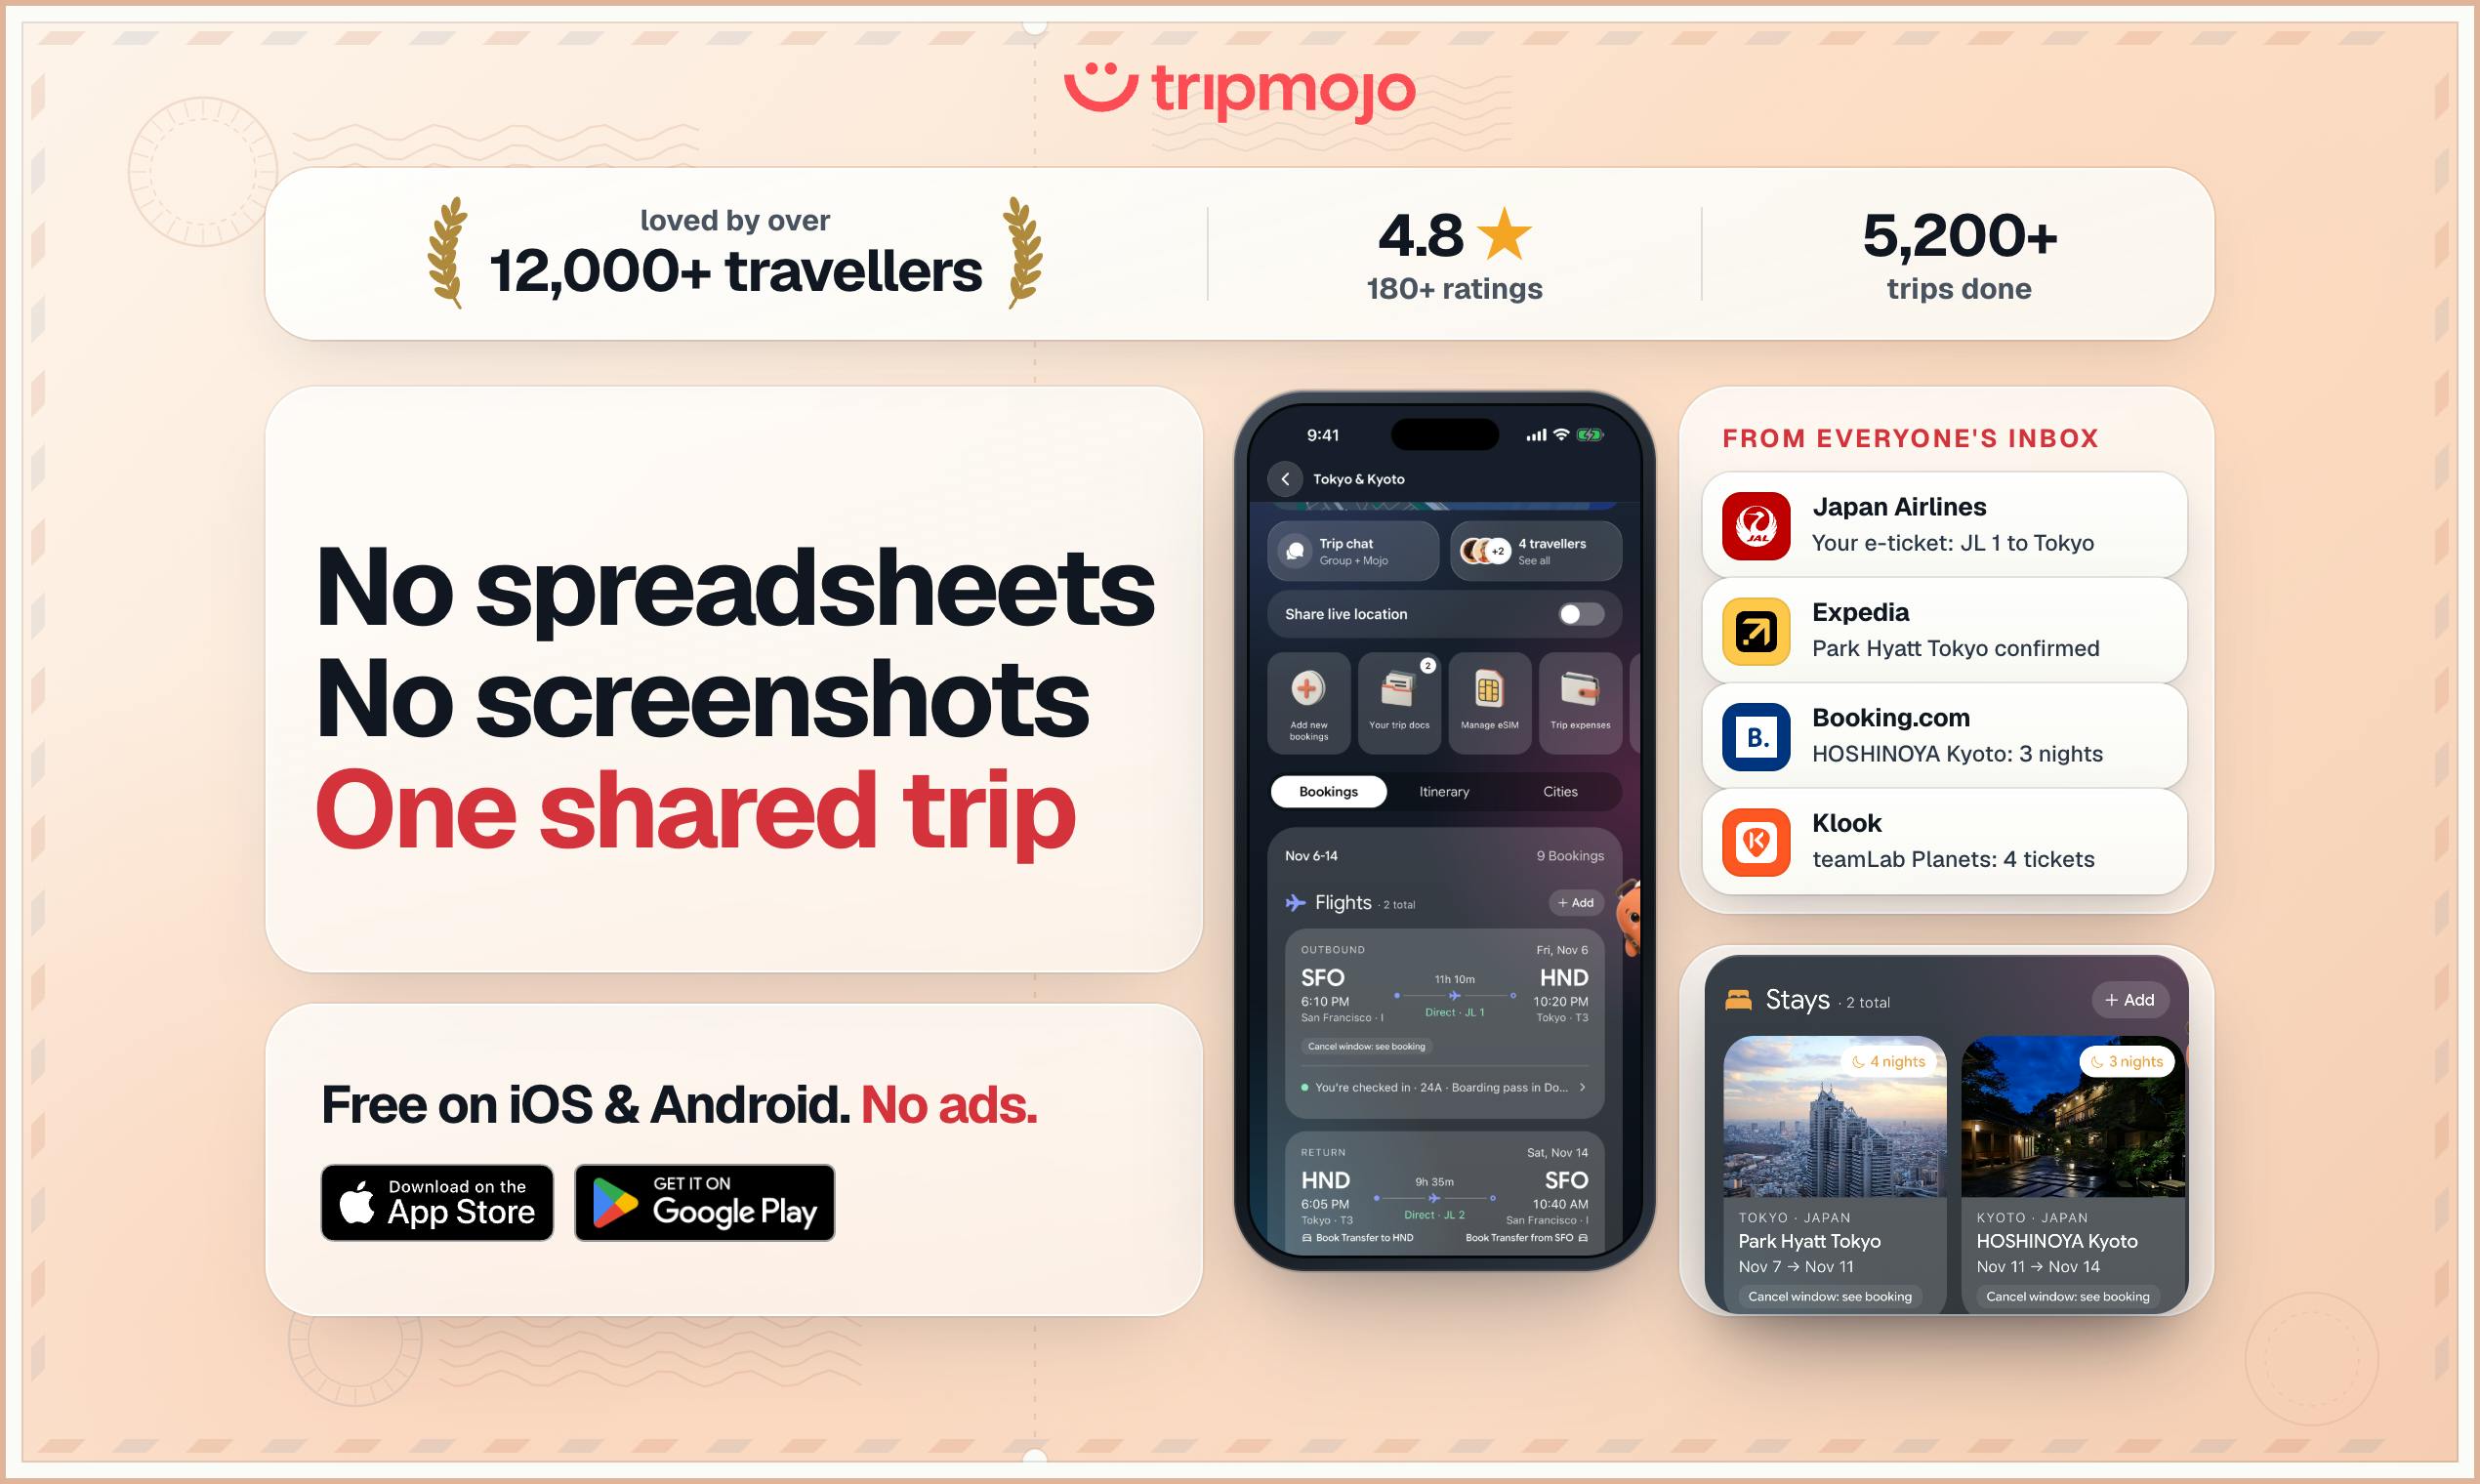
Tripmojo:会帮你值机的AI旅行Agent
Tripmojo是Product Hunt上排名第2的AI旅行Agent应用,能同步预订邮件生成共享行程,并由AI助手Mojo在出行当天尝试值机、保存登机牌、提醒延误与登机口变更,行程中维护计划并分摊费用,iOS与Android免费。