Sourcerer:离线AI淘货助手,代码算钱模型识别

开源项目 Sourcerer 用本地 Gemma 3 识别物品、纯函数计算最高出价,实现离线定价决策。
Sourcerer 是一个离线优先的开源工具,帮助二手卖家在无网络环境下判断物品的最高出价。它将任务严格拆分为两半:本地运行的 Gemma 3 4B 负责图像识别与关键词提取,纯 TypeScript 函数依据平台费、运费、耗材和利润率计算金额,确保离线与在线结论完全一致。开发者通过 30 件物品的四组评测发现,JSON Schema 能消除品牌编造,反编造提示词改善的是置信度校准而非准确率。金额结论最终改由确定性函数组装,避免模型把数字说反。工程上采用 Temporal 保证任务耐久性,并坦诚披露识别耗时 30–40 秒、缺乏免费成交价数据等局限。
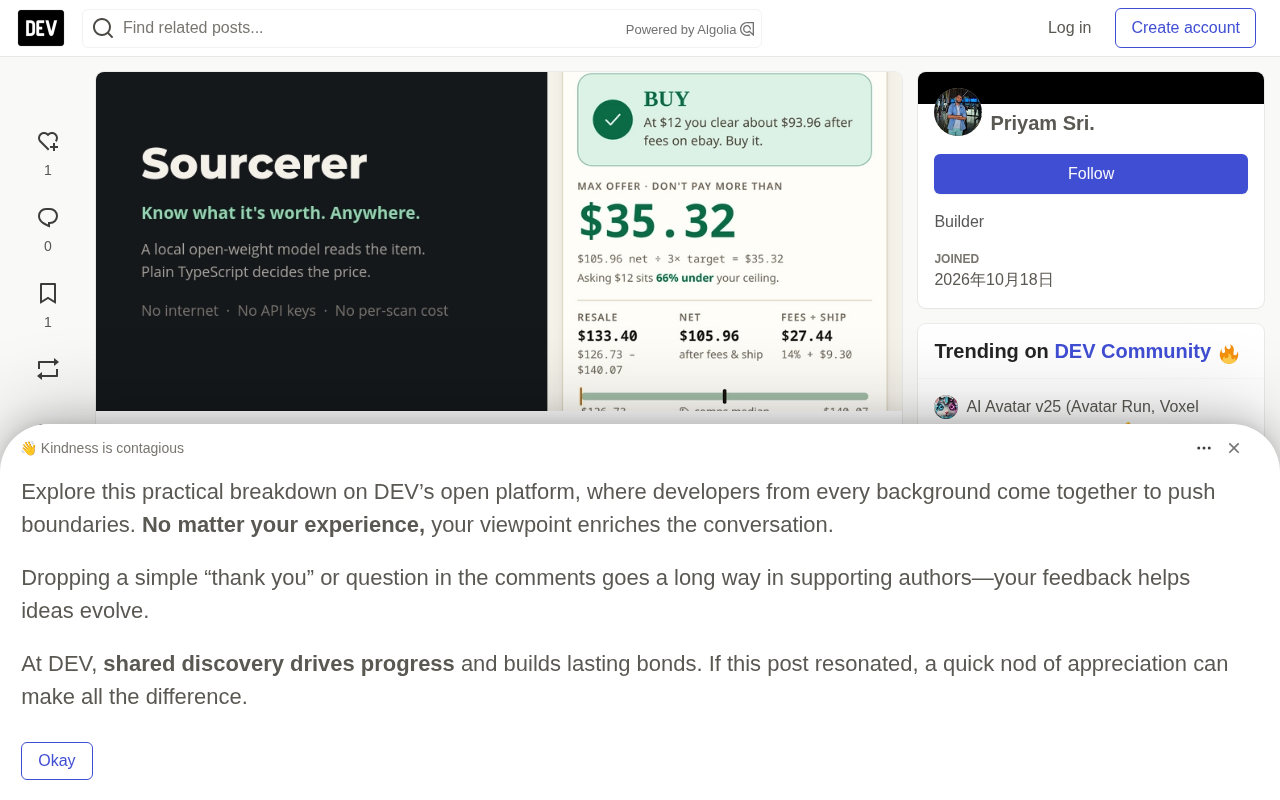
在二手店地下室、手机没有信号的时候,如何判断一件8美元的夹克值不值得买?Sourcerer 给出的答案不是“它值多少钱”,而是“我现在最多该出多少钱”——扣掉平台费、运费、耗材和你想要的利润率之后的上限。
这个开源项目把工作拆成两半:本地运行的 Gemma 3 4B 模型负责“看懂”物品,纯 TypeScript 函数负责“算钱”。据开发者 ItsPriyamSri 在 Hacktoberfest 开源 AI 挑战赛的投稿,整个系统离线优先,无需联网、无需 API 密钥、按次扫描零成本。
为什么要拆开模型和算术
开发者最初的尝试是让一个小模型既识别物品又给出购买建议。结果问题很隐蔽:让 4B 模型判断“该不该买”,它会给出一个自信、通顺、但算术上错误的答案。真正需要的是解一个公式:
max_offer = (resale − resale·fee − shipping − supplies) / target_multiple
语言模型不是做这件事的正确工具。它擅长的是看一张光线很差的标签照片,然后说出“这是 Pendleton 的水洗板衬衫,而且缩水过”。
于是系统被永久地一分为二:Gemma 3 4B 在本地读取图片、提取关键词;定价交给实时商品列表或用户自己的成交历史;最终金额由 packages/shared/src/economics.ts 里的纯函数决定。决定函数不涉及任何 I/O,所以离线时浏览器算出的结论和联网时服务器算出的结论是同一份代码,误差为零。
“决定发生在没有信号的地方。”开发者强调,这不是成本问题,而是物理问题——唯一解法是把模型放在决策发生的位置。
Gemma 3 4B 是 Google 于 2025 年初发布的开源多模态模型系列中的小参数版本,支持文本与图像输入(即“vision”能力),可在消费级硬件上通过 Ollama 等本地推理框架运行。4B 指约 40 亿参数,量化后显存占用通常在 3–4 GB 级别,这使得在无网络的笔记本或手机上完成图像理解成为可能。它的能力边界也由此而来:擅长常识性识别与模糊图像的容错,但多步算术与精确数值推理可靠性有限,这正是文章将其限定为“识别器”而非“决策者”的技术依据。
一条提示词买不到的东西:评测数据说话
开发者用 30 件人工标注的物品跑了四组配置,模型为 gemma3:4b,温度 0.1。结果有点反直觉:
| 配置 | 可解析 JSON | 品牌正确 | 类型正确 | 两者都对 | 编造品牌 | 中位耗时 |
|---|---|---|---|---|---|---|
| v1 散文提示词 | 100% | 97% | 100% | 29/30 | 1/4 | 8.8s |
| v2 + JSON Schema | 100% | 100% | 100% | 30/30 | 0/4 | 8.6s |
| v3 完整规则提示词 | 100% | 100% | 100% | 30/30 | 0/4 | 8.5s |
| v4 + 反编造规则 | 100% | 100% | 100% | 30/30 | 0/4 | 8.3s |
开发者原本以为提示词工程是主要杠杆,结果发现“可解析性”在朴素提示词下已经是 30/30。真正起作用的是两件不同的事:JSON Schema 把编造品牌的数量从 1 降到 0;反编造规则改变的是置信度校准,而不是准确率。
第 21 号物品最能说明问题:“Eames 风格休闲椅,玫瑰木,没有任何标签。”朴素提示词下,模型给出 "brand": "Eames (Style)" 和 0.95 的置信度——一个格式干净、自信、可机读的假品牌。加入 Schema 后,品牌字段被允许为 null,模型选择了“不知道”,置信度从 0.95 一路降到 0.6,并主动补充了“无可见标签”的说明。
开发者坦承仍有遗留问题:标题里依然写着“Eames Lounge Chair Rosewood”,而标题正是会被粘贴到商品列表里的内容。由于定价锚定在可比成交价而非标题,金额不受影响,但列表生成器应当在品牌为 null 时拒绝使用设计师名字——这是下一步要做的。
JSON Schema 约束解码是指在推理时把输出格式的语法结构(如字段名、类型、是否允许 null)作为约束注入,使模型只能生成符合模式的内容。它解决的是“可解析性”与“字段合法性”问题——例如品牌字段被声明为可为 null 后,模型获得了一个合法的“不知道”出口,而不是被迫编造一个看起来合理的值。需要注意的是,Schema 保证的是格式正确,并不保证内容真实;文章中提到编造品牌从 1 降到 0,更多是因为 null 选项消除了“必须填”的压力,而非模型的知识边界发生了改变。置信度校准则是另一个维度,指的是模型自报概率与实际正确率之间的匹配程度,通常需要专门的提示或后处理来改善。
模型只读不算,第二模型只调工具
识别模型和工具调用模型是分开的,这是能力边界而非偶然。通过 ollama show gemma3:4b 可以看到,Gemma 3 的能力列表是 completion, vision——没有 tool calling。
所以顾问代理跑在 llama3.2:3b 上,具备 tools 能力,同一个金额问题约 2 秒回答。开发者试过 Qwen 3 4B,工具调用正确,但每步要输出约 35KB 的思考内容,六步预算下回答一个 215 美元的销售问题要超过四分钟。
更关键的是金额结论的归属问题。模型会正确复述数字,却把结论搞反:面对一个 150 美元的军鼓、58.82 美元的上限,三次运行给出三种说法——说“低于上限”的、说“应该买”的、说“应该放弃”的。
最终方案是金额句子不再由模型撰写:feeMath 用与扫描界面相同的 decideVerdict() 组装回复。同一个问题问五遍,答案逐字符一致:
PASS. Most I would pay is $58.82. At $150 you would make $26.46 if it resells at $215.
代理剩下的工作是理解请求、用正确的参数调用工具。三轮对话记录显示,“我要跨州发货,运费按 35 美元算”被转成 shippingCost: 35,上限从 58.82 变为 49.82,第三轮还能记得第一轮的内容。
Tool calling(工具调用) 是让语言模型在生成过程中输出结构化的函数调用请求,由外部运行时执行并将结果回传的能力。它通常依赖模型在训练阶段见过特定的调用格式,因此并非所有模型都具备——ollama show 列出的能力标签可以直观判断。不具备该能力的模型即使被提示“请调用工具”,也只能生成看起来像调用的文本,无法被可靠解析。此外,工具调用模型往往会产生“思维链”式中间输出,token 数量直接决定延迟;文章中提到 Qwen 3 4B 每步输出约 35KB 思考内容导致四分钟以上的响应,就是这一机制在小模型上的典型代价。
工程细节:耐久任务与诚实的数据
eBay 把已完成交易列表移到了登录墙后面,免费的真实成交价来源已经没有了。最常见的诱惑做法是把要价标成成交价返回,但开发者选择给每条可比数据打上 kind: "asking" 标签,界面上每行都显示“要价”,并乘以一个公开命名的系数:
export const ASKING_TO_SOLD_FACTOR = 0.86; // 在所有应用处标注
批量重新定价任务跑在 Temporal 上,每个物品两个活动:刷新可比数据、应用新价格。开发者用 SIGKILL 在扫描中途杀掉工作进程来验证耐久性:12 件物品,第一个 worker 刷了 3 件,重启后第二个 worker 刷了 9 件,重复刷新 0 件,活动执行 24 次(期望值 24)。崩溃只花了时间,没花别的。
性能数据同样直白:从照片识别需要 30–40 秒,从输入文字识别 8.3–8.8 秒;重启后第一次扫描要多等约 75 秒加载权重;本地 1B 模型生成列表草稿约 2 秒。开发者承认 30 秒比这个工具瞄准的“十秒决策”要慢,这是目前尚未攻克的主要差距。
接真实服务的过程还暴露了三个缺陷,其中两个是静默的:Ollama 0.40 移除了 POST /api/embeddings,导致每次写入都存了 NULL 向量,“我买过这个吗”悄悄退化成关键词匹配;32 件种子数据因 Ollama 一次只答一个模型请求而超时;可比数据步骤把网络调用记录成了 provider: cache,而这一行的职责恰恰是告诉用户查询是否离开了设备。
Temporal 是一个开源的持久化执行(durable execution)工作流引擎。它把工作流的状态、活动调用记录和重试历史持久化到数据库中,工作进程崩溃后由其他 worker 从检查点继续执行,从而保证每个活动“至少执行一次”并可配置为幂等。文章中用 SIGKILL 杀掉进程验证的正是这一特性:已完成的活动不会重跑,未完成的由新 worker 接管。与之配套的概念是活动幂等性——若活动本身写入外部系统,需要业务侧去重才能实现“恰好一次”的效果,这也是文中“重复刷新 0 件”需要结合具体实现来理解的原因。
开放权重为什么重要
开发者的答案不是泛泛的“隐私”,而是具体的:决策发生在没有信号的地方——地下室、后屋、谷仓、乡村遗产拍卖、跳蚤市场仓库的角落。任何需要往返服务器才能定价的架构,都会在产品存在的那个瞬间失效。
开放权重让这件事成为可能:没有按次计费、没有速率限制、没有供应商能废弃提示词所依赖的模型版本。运行成本只有电费——对一个每月处理 20–40 件物品的兼职卖家来说,按次一两分钱一年也就几美元,成本不是论点,往返才是。
开发者也不讳言局限:前沿模型对真正冷门的收藏品有更大的世界知识库,对精细标签细节没有量化损失。这个 4B 模型对 Levi's 和 Pyrex 很自信,对没有标记的中世纪椅子就不太行。如果要鉴定一件 4000 美元的物品,应该去找正经模型;Sourcerer 优化的是另一种场景——四十件 12 美元的物品,每件十秒钟。
其他诚实的边界包括:没有成交历史时价格模型是空的,第一周的结论偏向 PASS;没人为此付过钱,定价只是假设;最大评测只有 30 件物品,由一个人在一台机器上花一个下午标注完成。
值得关注的设计取舍
Sourcerer 最有价值的部分不是它用了多少模型,而是它对“模型该做什么”的克制。识别交给模型,因为模糊照片需要容忍度和常识;算术交给代码,因为钱需要可审计。当模型把结论说反时,开发者的反应不是加更多提示词,而是把这句话从模型手里拿走。
项目采用 MIT 协议,克隆后 pnpm install && bash scripts/setup.sh,再开两个终端分别启动 brain 和 web 即可,无需任何 API 密钥就能看到核心循环工作。对于想研究本地多模态模型落地、或者对离线优先架构感兴趣的开发者,这是一个结构清晰、证据可查的参考实现。
相关推荐

农业革命另一面:疾病如何帮农民击败狩猎采集者
历史学者Kyle Harper解读农业社会如何击败狩猎采集者:不仅靠单位土地能量提取效率带来的人口增长优势,还依靠定居生活催生的病原体在扩张中造成额外死亡率,形成双重替代机制。

渐进式披露让Agent提速2.3倍:上下文工程新思路
Hacker News讨论提出用渐进式披露优化AI Agent上下文,实现2.3倍提速。本文解析上下文膨胀的三大性能损耗,介绍分层工具目录、按需检索、历史压缩等实践路径及落地注意事项。
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 现可在 Mac 上完全本地运行,模型与智能体均在设备端执行,支持原生 Mac 应用和本地文件,敏感数据无需上传云端,已在 Perplexity Mac 应用上线。