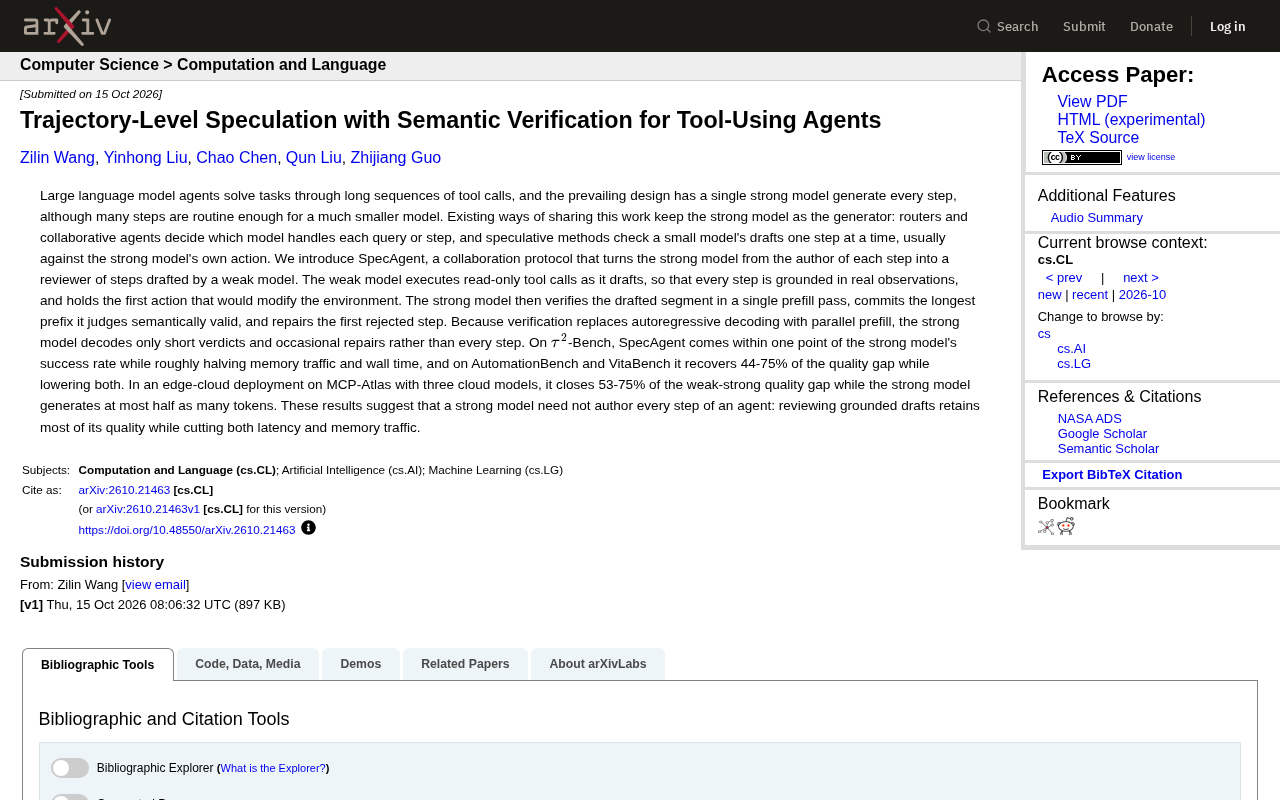
SpecAgent:让强模型做审稿人,工具智能体推理成本减半

SpecAgent 让弱模型起草轨迹、强模型单次验证,质量近乎强模型而成本减半。
SpecAgent 提出一种反转式的模型协作协议,把强模型从"每一步动作的生成者"重新定位为"整段草稿的审稿人"。它让弱模型直接执行只读工具调用、落地起草轨迹,直到遇到第一个会改变环境状态的动作才停下;随后强模型在一次 prefill 前向传播中判断草稿语义有效的最长前缀,直接提交该前缀,并只修复第一个被拒绝的步骤。由于验证是并行 prefill 而非串行逐 token 解码,强模型的计算量大幅下降,把推测式解码的思想从单步、字符串层面提升到了轨迹、语义层面。在 τ²-Bench、AutomationBench、VitaBench 和 MCP-Atlas 等基准上,SpecAgent 成功率逼近强模型,内存流量与墙钟时间约减半,并在边缘-云场景中弥补了弱模型与强模型间 53%-75% 的质量差距,强模型生成的 token 数至多减半。
在大语言模型驱动的工具智能体(tool-using agent)中,一个长期默认的架构选择是:每一步决策都由最强的模型来生成。无论是路由分配还是协同决策,强模型始终扮演"作者"角色,负责产出每一个动作。然而,真实任务中大量步骤其实相当常规——查天气、读文件、搜索信息——这些操作对一个小模型而言并不困难。真正的瓶颈不在于能力,而在于架构:我们是否真的需要强模型逐字逐句地写完整个决策序列?
来自学术界的 SpecAgent 提出了一种颇具反转意味的协作协议:把强模型从"每一步的作者"变成"草稿的审稿人"。
现有方案的局限:强模型始终在为每一步买单
当前的模型协同策略大致分为两类。一类是路由(routing)方案,根据查询或步骤的难度决定由哪个模型处理;另一类是协同智能体,让不同规模的模型分工完成任务。
这两类方案有一个共同点:强模型依然是生成方。推测式解码(speculative decoding)虽然引入了小模型起草、大模型校验的思路,但校验粒度停留在单步层面,且通常是对照强模型自己会采取的动作来判断。
这种设计的代价是显而易见的。每一步都需要强模型参与解码,即便该步骤只是读取一个本地文件或发起一次搜索。当任务轨迹拉长到数十步甚至上百步时,推理延迟和内存流量会线性堆叠。对于边缘-云协同部署场景,这意味着高昂的云端调用成本和不容忽视的通信开销。
推测式解码(Speculative Decoding) 是一种推理加速技术,最初由 Leviathan 等人于 2022 年提出。其核心思想是让一个轻量级的"草稿模型"(draft model)快速自回归生成若干候选 token,再由目标大模型在一次前向传播中并行验证这些候选 token 是否被接受,从而把大模型原本串行的逐 token 解码转化为并行的批量校验。之所以能加速,是因为验证阶段的计算是并行的 prefill,而非逐 token 的 decode,在 GPU 上并行效率远高于串行生成。SpecAgent 借鉴了这一思想,但做了关键改造:一是把"草稿"的粒度从 token 提升到完整工具调用动作,二是把验证得到的"接受/拒绝"从字符串层面提升到语义层面的轨迹合法性判断,三是加入了"修复"环节,对第一个被拒绝的步骤给出替代动作。因此 SpecAgent 可以说是推测式解码在智能体轨迹这一更高抽象层级上的一次迁移。
SpecAgent 的核心思路:起草—验证—修复
SpecAgent 的协议设计可以拆成三个关键环节。
弱模型起草,且必须"落地"。 弱模型在起草阶段直接执行只读工具调用,让每一步都建立在真实观测之上,而非凭空想象。它持续起草直到遇到第一个会修改环境状态的动作,然后在此处停下。
强模型单次前向验证。 起草出的整段轨迹交给强模型后,后者不再逐步自回归解码,而是在一次 prefill 前向传播中完成验证。它判断这段草稿在语义上有效的最长前缀,直接提交该前缀,并只对第一个被拒绝的步骤进行修复。
验证替代解码。 这是效率提升的根本来源。强模型的输出从"每一步的完整动作"缩减为"简短裁决加偶发修复"。由于验证是并行的 prefill,而非串行的逐 token 解码,强模型的实际计算量大幅下降。
你可能没注意到,这里的验证是语义层面的判断,而非简单的字符串匹配或动作比对。强模型评判的是草稿轨迹作为一个整体是否在语义上成立,这让验证粒度从单步提升到了轨迹级别。
Prefill 与 Decode 的区别:Transformer 推理分为两个阶段。Prefill 阶段一次性处理整段输入提示(prompt),所有 token 的注意力计算可以并行完成,主要受算力(compute-bound)限制;Decode 阶段则逐个生成输出 token,每生成一个都要重新做一次前向,主要受显存带宽(memory-bound)限制。对于一个有 N 个输入 token、需要生成 M 个输出 token 的请求,decode 的代价大致正比于 M 且无法并行。SpecAgent 的精髓正在于把强模型的职责从"生成 M 个 token 的完整动作序列"(decode 主导)转换为"阅读一段已写好的草稿并给出裁决"(prefill 主导)。由于 prefill 是并行的、decode 是串行的,即便输入变长,总延迟和显存流量仍然显著低于逐步生成,这正是"验证替代解码"能带来约减半墙钟时间和内存流量的根本原因。
实验结果:逼近强模型质量,成本近乎减半
SpecAgent 在多个基准上验证了其效果,不同测试平台给出了相互印证的结论。
在 τ²-Bench 上,SpecAgent 的成功率与强模型相差不到一个百分点,同时内存流量和墙钟时间(wall time)都大约减半。这是一个相当有说服力的结果:质量几乎无损,成本却腰斩。
在 AutomationBench 和 VitaBench 上,SpecAgent 恢复了两模型质量差距的 44% 到 75%,同时降低了延迟和内存开销。这意味着它不总能完全追平强模型,但在大多数情况下能显著缩小差距,且始终以更低的成本运行。
在 MCP-Atlas 的边缘-云部署场景中,测试涉及三个云端模型。SpecAgent 弥补了弱模型与强模型之间 53% 到 75% 的质量差距,而强模型生成的 token 数量至多为原来的一半。
多个独立基准的结果指向同一个共识:强模型的审查能力比它的生成能力更"划算"。让强模型审视一段已经落地执行的草稿,远比让它从零开始逐步生成要高效。
τ²-Bench、AutomationBench、VitaBench 与 MCP-Atlas 都是近年用于评估工具智能体能力的基准。τ²-Bench 由 Sierra 提出,聚焦于客服等领域中多轮对话下的工具调用与策略遵循,强调 agent 在真实业务规则约束下完成任务的能力。AutomationBench 侧重自动化流程类任务,考察 agent 在长链路操作中的稳定性。VitaBench 则更关注复杂真实场景里的多步推理与工具组合。MCP-Atlas 与 Model Context Protocol(MCP)生态相关,用于评估多个云端模型在工具调用场景下的协同表现,常被用于模拟边缘-云协作部署。这些基准的共同特点是任务轨迹长、步骤多、工具调用密集,恰好是 SpecAgent 这类"轨迹级验证"方案收益最大的场景,因此它们给出的结论具有互补的参考价值。
为什么这个方向值得关注
SpecAgent 的价值不只是一项工程优化。它触及了一个更根本的问题:在智能体架构中,强模型的核心价值到底是什么?
如果强模型的真正优势在于判断和审查——识别草稿中哪一步在语义上不成立、哪里需要修复——那么把它绑定在逐步骤的生成任务上,就是对稀缺算力的错配。SpecAgent 的实验结果支持这一判断:强模型作为审稿人,其质量贡献的大部分得以保留,而成本结构被彻底改写。
对于需要在边缘设备上部署工具智能体的场景,这一思路尤其有吸引力。弱模型承担大部分起草工作,只读工具调用在本地完成,强模型仅在云端做一次前向验证。带宽消耗和云端算力占用都随之下降,同时保持了接近强模型的任务完成质量。
当然,这一方案也有其适用边界。它依赖弱模型能够起草出语义上基本合理的轨迹,否则强模型需要频繁修复,收益会打折扣。验证阶段的"最长有效前缀"判断标准也可能因任务类型而异。但就目前多个基准上的表现来看,SpecAgent 为工具智能体的成本-质量权衡提供了一个值得深入探索的新方向。
边缘-云协同部署 指的是将计算任务在终端设备(边缘)与远端数据中心(云)之间进行分工的架构。在工具智能体场景中,边缘设备通常算力、内存和带宽都有限,而云端大模型调用则面临延迟、费用和隐私三方面的约束。SpecAgent 的协作模式天然契合这一架构:弱模型部署在边缘侧,负责高频、轻量的只读工具调用与轨迹起草;强模型只在云端对草稿做一次前向验证,大幅减少需要上传的数据量和云端算力占用。相比每一步都调用云端强模型,这种"本地起草、云端审阅"的模式能同时降低带宽消耗、云端调用费用和端到端延迟,同时保持接近强模型的任务完成质量,为算力受限环境下的智能体落地提供了可行路径。
相关推荐
Underdog Saluki 27B:2-Bit量化下的工具调用实战指南
深入解读 Underdog Saluki 27B 基于 GSQ-RCO 的 2-bit 量化方案,涵盖 GGUF 头部结构、内存占用分析与原生 llama.cpp 下的 BFCL 工具调用实测要点,助你评估低比特量化模型的实用边界。
OpenAI与Anthropic限制智能电视逆向工程,引发AI伦理争议
OpenAI与Anthropic限制智能电视逆向工程项目REA,引发AI安全与开放研究争议。本文分析事件背景、隐私隐患及AI公司的使用政策,探讨平衡之道。

GPU-unlock:解锁 Nvidia 3000 系显卡的 FP/BF16 指令发射率
gpu-unlock 项目探索 Nvidia 3000 系显卡在 FP16/BF16 计算上的指令发射率限制,本文解读其测量方法、解锁思路、社区争议以及对 GPU 性能优化的实际意义。